深掘り 2026年10月15日
AI エージェントが手を動かす仕事は CPU で動く——半導体四社が専用ラックを出し、買い手がいま買っているのは CPU の容量だ
SecondSource 深掘りレポート #41
本稿は 2026 年 10 月 15 日に掲載し、10 月 23 日に、より高い執筆基準で文章を書き直した。掲載後の出来事は加えていない。
本稿の要点
AI エージェントとは、仕事を受け取ると手を動かして最後まで片づける AI のことだ。モデルは GPU の上で次の一手を考え、呼び出すツールやプログラムは CPU の上で動く。GPU も CPU もコンピューターの半導体の一種である。10 月 12 日、オープン・コンピュート・プロジェクト(OCP)の年次ハードウェア大会で、AMD、NVIDIA、Intel、Arm の四社がそろって、エージェントのツールを動かすための CPU ラックを出した。ラックとは、組み上がった CPU サーバーを一つの棚にまとめたものである。2026 年 10 月 15 日時点で、買い手はエージェントが使う CPU を GPU とは別に買っている。最大の例は、Meta が Amazon のクラウドである AWS 上の CPU コアを買った件だ。本稿が調べたプレスリリース、決算資料、論文、アナリストの報告の範囲では、エージェント専用に設計したラック一式を買ったと公に述べた買い手は、まだいない。当面エージェント用の CPU の商売を誰が取るかについて、本誌の読みは「出荷できる社」である。根拠は一社だけで、Intel が決算資料で自ら報告した供給不足である。
1. まず分担から:AI エージェントは GPU で次の一手を考え、CPU で手を動かす
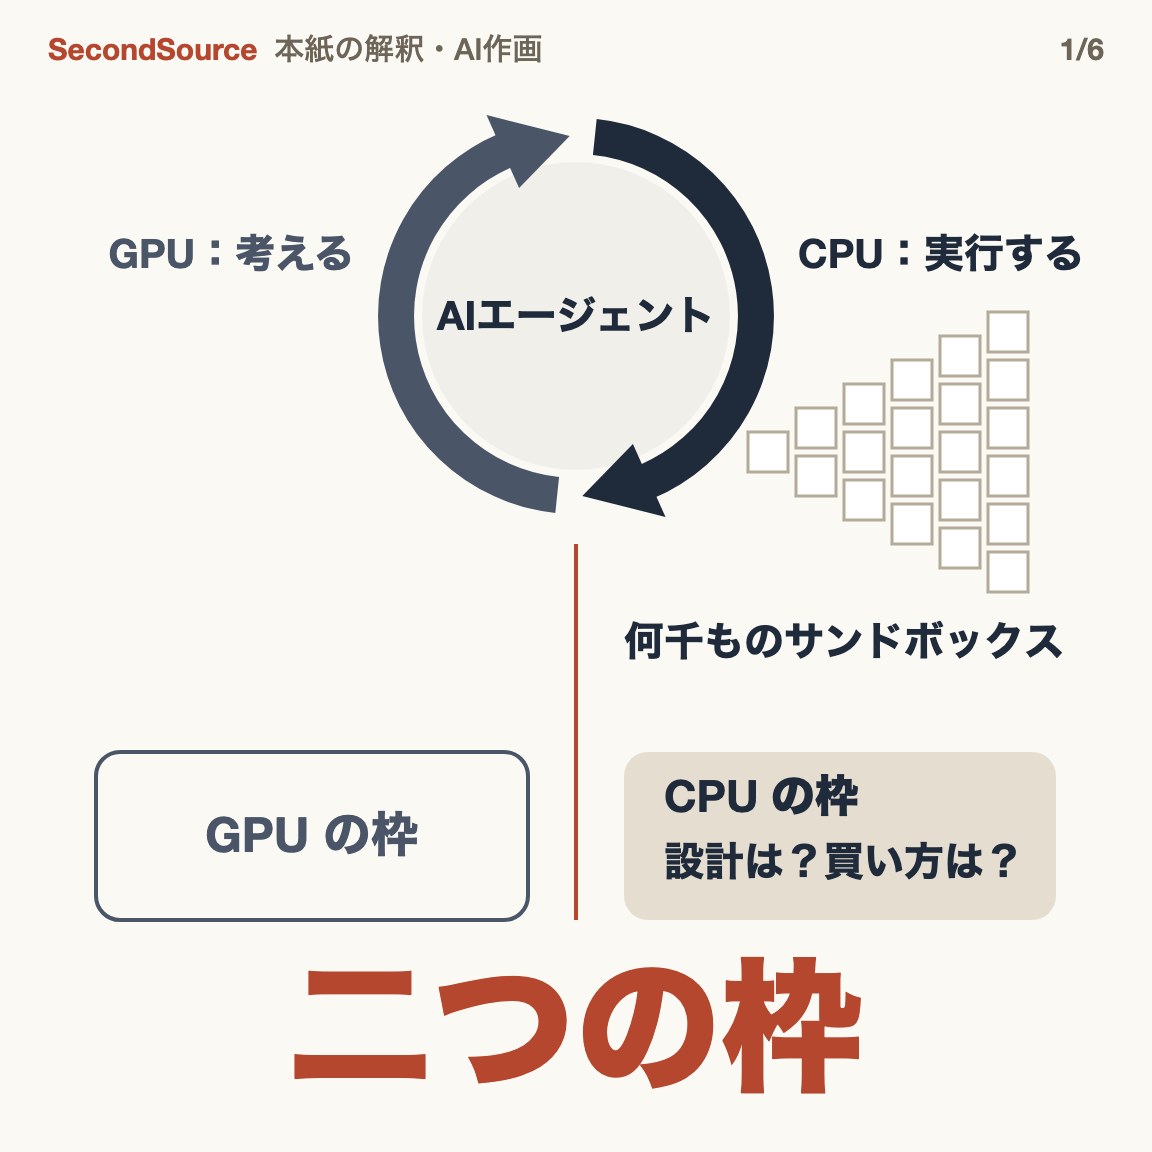
AI エージェントは質問に答えるだけでなく、実際に仕事を片づける。たとえばウェブを検索する、短いプログラムを書いて実行する、あるソフトウェアを操作する、といった仕事だ。進め方は一周ずつ回るループである。モデルが次に何をするかを考え、ツールを呼び出して実行させ、結果を受け取り、また次の一手を考える。仕事が終わるまでこれを繰り返す。
このループの二つの半分は、別々の半導体で動く。次の一手を考えるのはモデルの計算で、業界では推論と呼ぶ。GPU が得意なのは、モデルが必要とする同じ種類の大量の計算を一度にこなすことで、一般のソフトウェアを動かすための半導体ではない。手を動かす側の半分は、検索、ファイルの読み書き、プログラムの実行である。これらは一般のソフトウェアで、もともと CPU で動くように書かれている。エージェントが書いたプログラムは、ふつうサンドボックスの中で実行される。サンドボックスとは外から隔離した小さな実行環境で、プログラムが失敗しても外には触れられない。一つの仕事に一つのサンドボックスを開くので、仕事が増えればサンドボックスは何千と開き、その一つひとつが CPU を使う。
半導体各社は、まさにこの分担に沿って製品を出している。NVIDIA は、Vera CPU ラックが「ツールの呼び出し、オーケストレーション、サンドボックスでの実行を支える」と明記した。オーケストレーションとは、どのツールを先に動かし、結果を誰に渡すかを段取りすることだ。モデルの訓練と推論は、別の GPU ラックに任せる。AMD の Helion ラックには CPU だけを載せる構成もあり、AMD はこれを「エージェント実行専用の容量」と明記して、別のモデル推論設備につなぐとしている。
本稿では GPU と CPU を二つの枠として扱う。エージェントが使うのは CPU の枠で、選ぶべき問いが二つある。一つ目は設計である。コアとは CPU の中で実際に命令を実行する単位で、サーバー用の CPU 1 個に数十から百以上ある。一つの道は密度だ。1 ラックにコアとメモリを多く詰め込むほど、同時に開けるサンドボックスが増える。もう一つの道はシングルコアの速さだ。エージェントは一歩ずつ進み、次の一歩は前の一歩の結果を待つ。同じ仕事の中の各ステップは、コアがいくつあっても同時には進められない。だから一つの仕事が最初から最後まで何分かかるかは、コア 1 個の速さで決まる。二つ目は買い方である。CPU の容量、つまりコアと電力を買うのか。クラウドから借りても自前で建ててもよく、ラックの種類は問わない。それとも、エージェント専用に設計したラック一式を名指しで買うのか。
本稿は次の順に答える。誰がこの CPU を売っているか(第 2 節)。誰がすでに買っているか、買っているのは容量かラック一式か(第 3 節)。二つの設計の道がそれぞれ何を受け持つか(第 4 節)。当面どの社が商売を取れるか(第 5 節)。
2. 半導体四社がエージェント用の CPU ラックを出した。この流れは 3 月に始まっていた
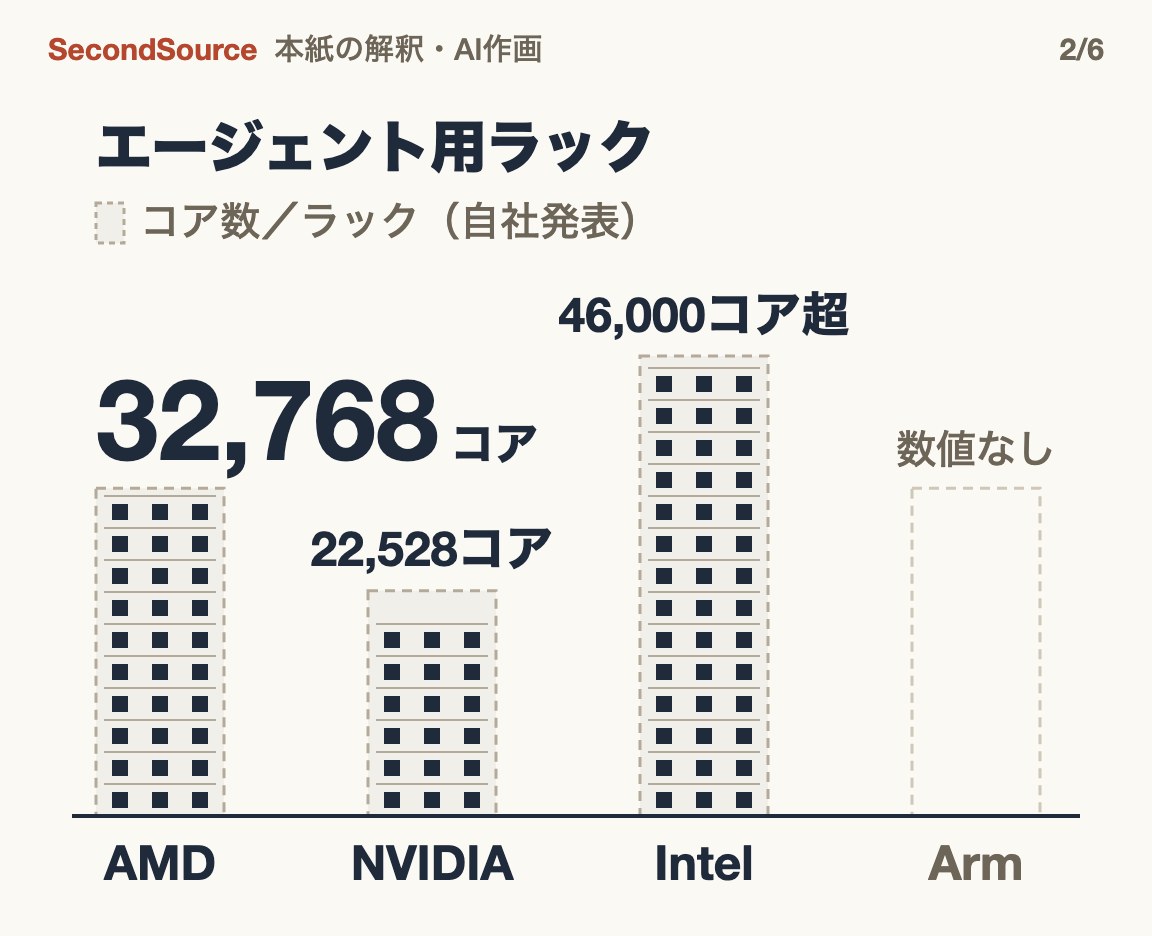
本誌の 10 月 13 日号が記録したのは、AMD と NVIDIA の二社だけだった。同じ大会には、Intel と Arm も出ていた。
| 社名 | 製品 | 各社が公表した規模 | 時期 |
|---|---|---|---|
| AMD | Helion ラックの CPU のみの構成 | 1 ラック最大 32,768 コア | 2026 年 11 月出荷 |
| NVIDIA | Vera CPU ラック | 1 ラック最大 256 個の CPU、22,528 コア | 最初のシステムを納入済み |
| Intel | Xeon 6+ プロセッサーのラック設計 | 一部の構成で 1 ラック 46,000 コア超 | 大会で展示 |
| Arm | AGI CPU のシステム | 1 個 136 コア(本稿が調べた資料に 1 ラックのコア数はない) | システム発売済み |
Arm のシステムは、Supermicro や Verda といったシステムメーカーが販売している。システムメーカーとは、半導体を組み合わせて完成したサーバーにして売る会社のことだ。
この流れは 10 月に始まったものでもない。Arm は 3 月 24 日に CPU 製品の AGI CPU を発表し、Meta は共同開発のパートナーである。NVIDIA は 5 月 31 日に Vera CPU を発表した。計算用のラックを貸し出す CoreWeave は 9 月 30 日、Vera ラックの貸し出しを発表した。
3. 買い手はこの CPU をすでに別に買っている。買っているのは容量で、専用ラック一式に公の買い手はまだいない
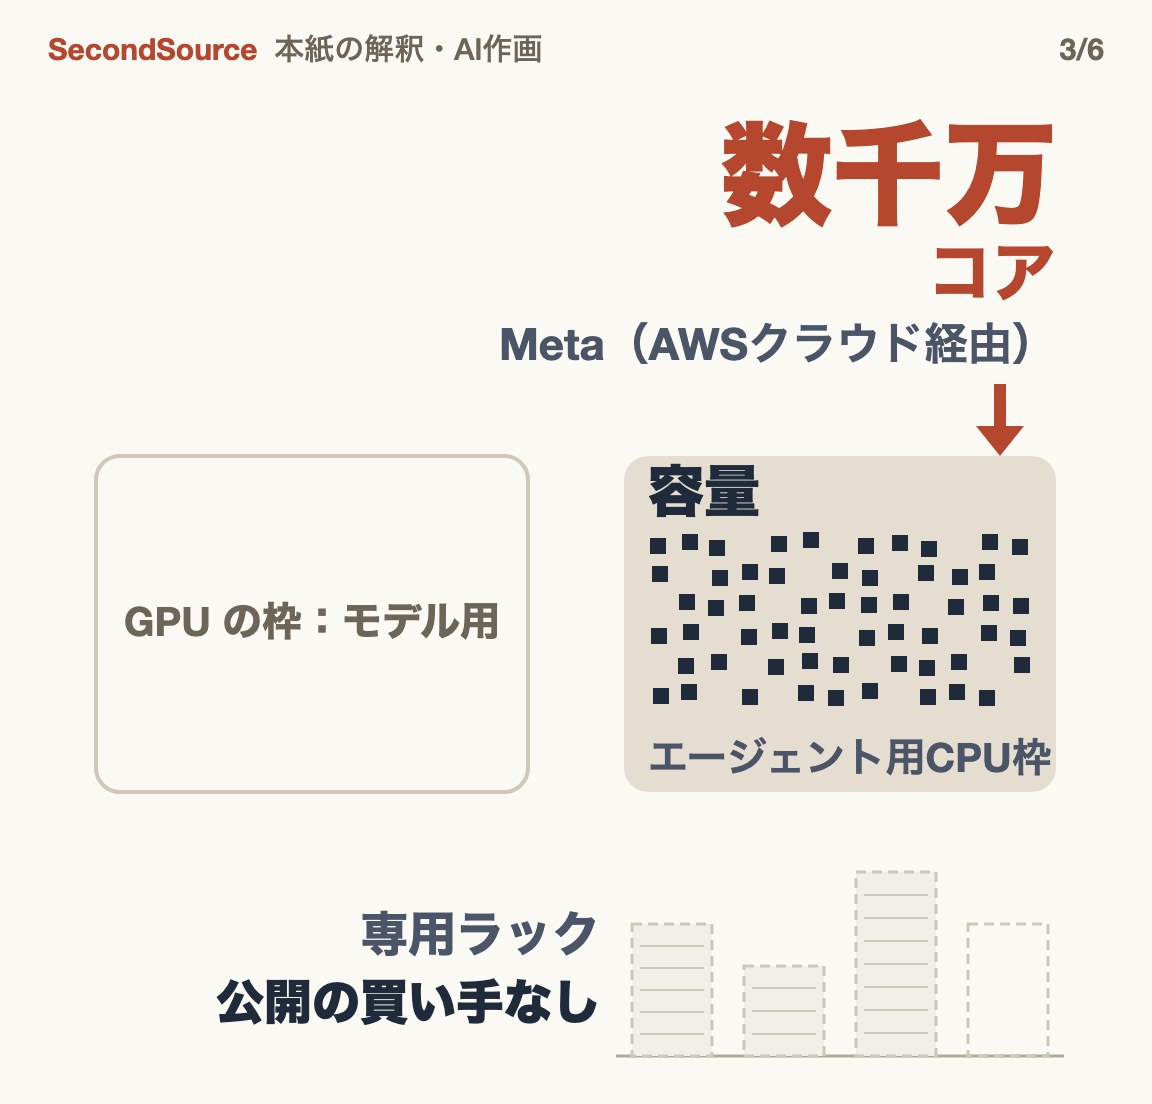
公開された最大の調達は Meta である。4 月末、Meta と AWS は複数年・数十億米ドル規模の契約を発表し、Meta は「数千万個の Graviton5 コア」を使う。Meta のインフラ責任者は、目的は「agentic AI を支える CPU 集約型の処理」を動かすことだと述べた。エージェントの裏で CPU を多く使う仕事のことである。Graviton5 は AWS が自社開発し、AWS のクラウド上で提供する CPU だ。したがってこの取引で買ったのは容量である。契約の具体的な形は公開されていない。
二つ目の例はエージェント専用ではないが、CPU がすでに単独で計画されていることがわかる。Microsoft の Fairwater と呼ばれるデータセンターのキャンパスについて、AI と半導体のサプライチェーンを調べる調査会社 SemiAnalysis が 2 月に現地取材で報じた。キャンパスには 48 MW の CPU・ストレージ棟があり、295 MW の GPU クラスターを支える。MW は電力の容量の単位である。同じ記事によれば、強化学習の訓練をしている AI 研究所は CPU が足りず、一般的な x86 サーバーをクラウド事業者と取り合っている。強化学習とは、モデルに仕事を何度もやらせ、うまくできたら報酬を与える訓練法で、エージェントをこの方法で鍛えるには大量のサンドボックスが要る。
残りは小さな始まりだ。すでに使っている会社はあるが、どれもまだこの節の見出しの「公の買い手」には数えない。本稿が数えるのは、エージェント専用のラック一式を買ったと買い手が公に述べた場合だけで、売り手が納入したと言う場合や、クラウド事業者が貸し出す場合は数えない。NVIDIA は、最初の Vera CPU システムを Anthropic、OpenAI などの AI 企業に納めたと述べたが、台数は公表していない。これは NVIDIA が製品ページに書いたもので、名簿に載った会社が何を買ったと述べたものは、本稿では見つからなかった。エージェント製品をつくる Perplexity は 10 月初め、自社のサンドボックスを Vera に移し始めたと述べたが、ラック一式を買ったのか借りたのかは述べていない。第 2 節の CoreWeave は Vera ラックを貸し出すクラウド事業者で、本稿が調べた資料には誰に貸したかが書かれていない。
4. 密度か、シングルコアの速さか:本誌は二つの道が別々の区間を受け持つと読む
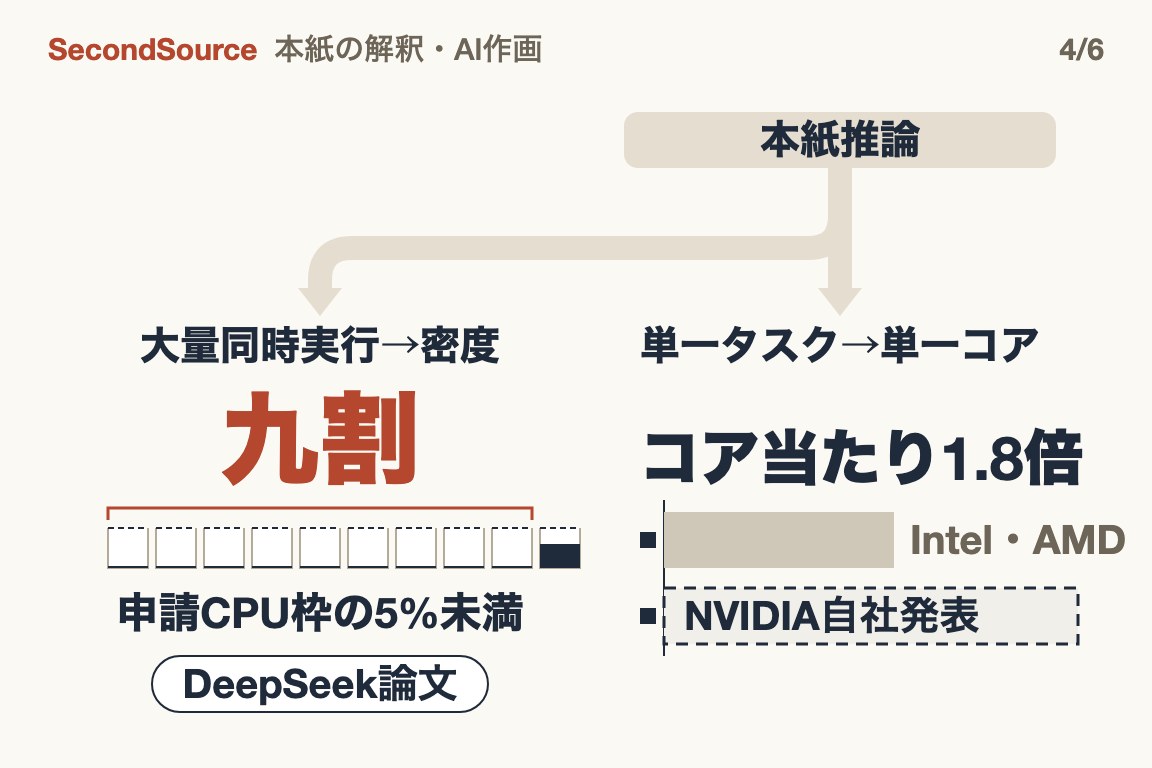
第 1 節の二つの道には、それぞれ賭けている会社がある。AMD の Helion が売るのは密度だ。NVIDIA の CEO は、エージェントに要るのはシングルコアが最も速い CPU であり、コアを多く貸し出すために設計したクラウドの CPU は方向を誤っていると主張する。
大量のサンドボックスを同時に開く区間には、公開された運用の数字が一つある。AI 企業の DeepSeek は 9 月に論文を出し、エージェントの訓練に使うサンドボックス基盤(名前は DSec)を公開した。CPU サーバー約 160 台・3 万コアで、1 日約 300 万個のサンドボックスを動かす。約 9 割のサンドボックスは、開始前に申請した CPU の割り当ての 5% も平均して使っていない。大半のサンドボックスでは CPU がほとんど遊んでいる。本誌の推論はこうだ。この種の負荷に要るのは、1 ラックにより多くのサンドボックスを収めること、つまり密度である。限界もある。これは一社の訓練用の機材群の数字で、実際の利用者に使われているエージェント製品のサンドボックスの使用量は誰も公開していない。5% の分母は申請量なので、多めに申請すればこの比率は下がる。
一つの仕事を速く終わらせる区間について、NVIDIA は、Vera のコアあたりの性能が x86 CPU の 1.8 倍だとしている。x86 とは、Intel と AMD のサーバー用 CPU の主流の設計である。Perplexity が自社で測ったのはワークフロー全体で、約 1.5 倍速かった。どちらもメーカーとそのパートナーの自己申告の数字で、測っているものも違うので、互いの裏付けにはならない。どちらも比較した CPU の型番を書いていない。
二つの区間の証拠の重さは違う。シングルコアの速さを看板にする NVIDIA でさえ、ラック単位で前面に出す仕様は密度だ。CPU の個数、コア数、そして 1 ラック 400 TB のメモリである。テクノロジー企業向けに調査と助言を手がける Futurum のアナリスト、Brendan Burke 氏は、二つの設計は「置き換え合うより補い合うことになる可能性が高い」と判断している。公開資料の中に、買い手が二つのうち一つを選んだ例も見当たらない。本誌のこの読みの確信は高くなく、同じ負荷での独立した測定を待つ(第 6 節の見るべき数字の 3 つ目)。
5. 当面この CPU の商売を取るのは、出荷できる社だ
ここで言う当面とは、2026 年下半期から 2027 年上半期までである。
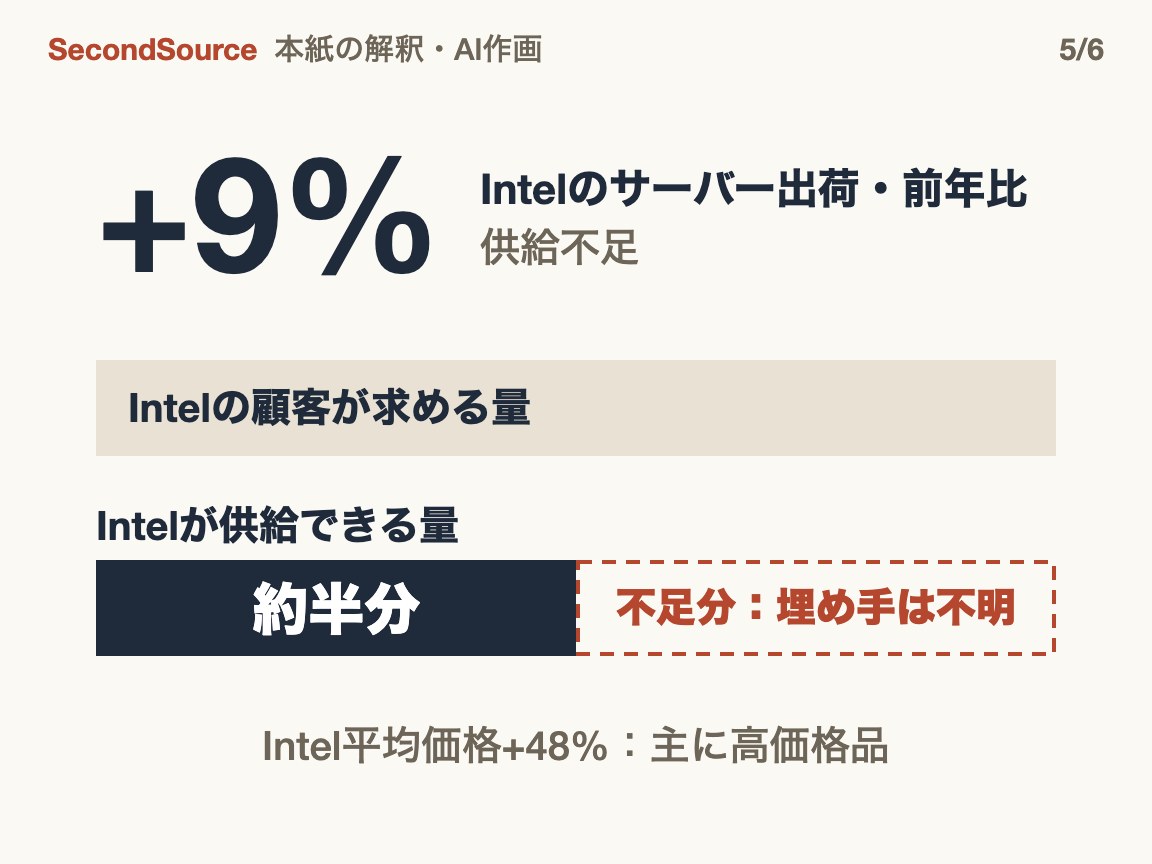
Intel の 2026 年第 2 四半期の決算資料は、二つのことを同時に書いている。サーバーの出荷数量は前年同期より 9% 増え、主に大手クラウド事業者の需要によるものだった。そして「市場の需要が供給できる製品を上回った」。原因は社内の供給制約である。SiliconANGLE の報道によれば、Intel の CEO は 9 月、顧客の CPU 需要の約半分しか満たせていないと述べた。
同じ決算資料で、サーバーの平均販売価格は 48% 上がった。本誌はこの数字を品不足の証拠には使わない。決算資料は、その大半が高価格帯の製品を多く売ったことによるもので、需要に応じた値上げの寄与は小さいと明記している。
Intel に足りないのは一般的なサーバー用 CPU だ。エージェントのサンドボックスは専用のラック一式でなくても一般的な x86 サーバーで動き、DeepSeek の基盤もそうだ。Intel が満たせない半分を、ほかの三社がどれだけ埋められるかは、各社の供給しだいだ。AMD の Helion は出荷が始まるところで、次の CPU である Verano は、TechTimes の報道によれば 2027 年上半期の量産を目標にしている。NVIDIA は、Vera のシステムを今秋からシステムメーカーとクラウドのパートナー経由で供給するとしている。Arm のシステムは発売済みだが、名前の公表された買い手はいない。シェアがすでにどの社に流れているかは、いまの資料からはわからない。
6. これは誰にとって何を意味するか
- AI の計算資源を買う企業:エージェント用に別に組む CPU の予算については、契約の前に、各社が 2027 年上半期にどれだけ納められるかを確かめておく。
- CPU のサプライヤー:独立した測定か、名前を出した顧客での導入を最初に示した社の主張が通る。
- エージェント製品をつくる企業:まずサンドボックスが実際にどれだけ CPU を使っているかを測る。DeepSeek のように大半が遊んでいるなら、シングルコアの速さに上乗せして払う価値は薄い。
本誌の見立て
エージェント用の CPU の商売を読むときは、まず二つを問う。買い手が何を買ったと公に述べているか(容量か、ラック一式か)。売り手がどれだけ出荷できるか。
これから見るべき数字
1. 10 月 29 日の Intel 第 3 四半期決算。 サーバーの出荷数量の伸びがはっきり加速するか、決算資料が需要超過を書かなくなれば、供給のボトルネックは緩んでいる。伸びが一桁のままなら、第 5 節の読みは続く。
2. 11 月の出荷開始後の AMD の四半期決算プレスリリース。 顧客への導入の記述があるかを見る(覆す条件の 1 つ目)。
3. 四社の CPU を同じ負荷で比べた独立した測定が出るかどうか。
4. 実際の利用者に使われているエージェント製品のサンドボックスの CPU 使用量を、誰かが公開するかどうか。 DeepSeek の数字よりはっきり高ければ、第 4 節の推論は範囲を狭める必要がある。
この判断を覆す条件
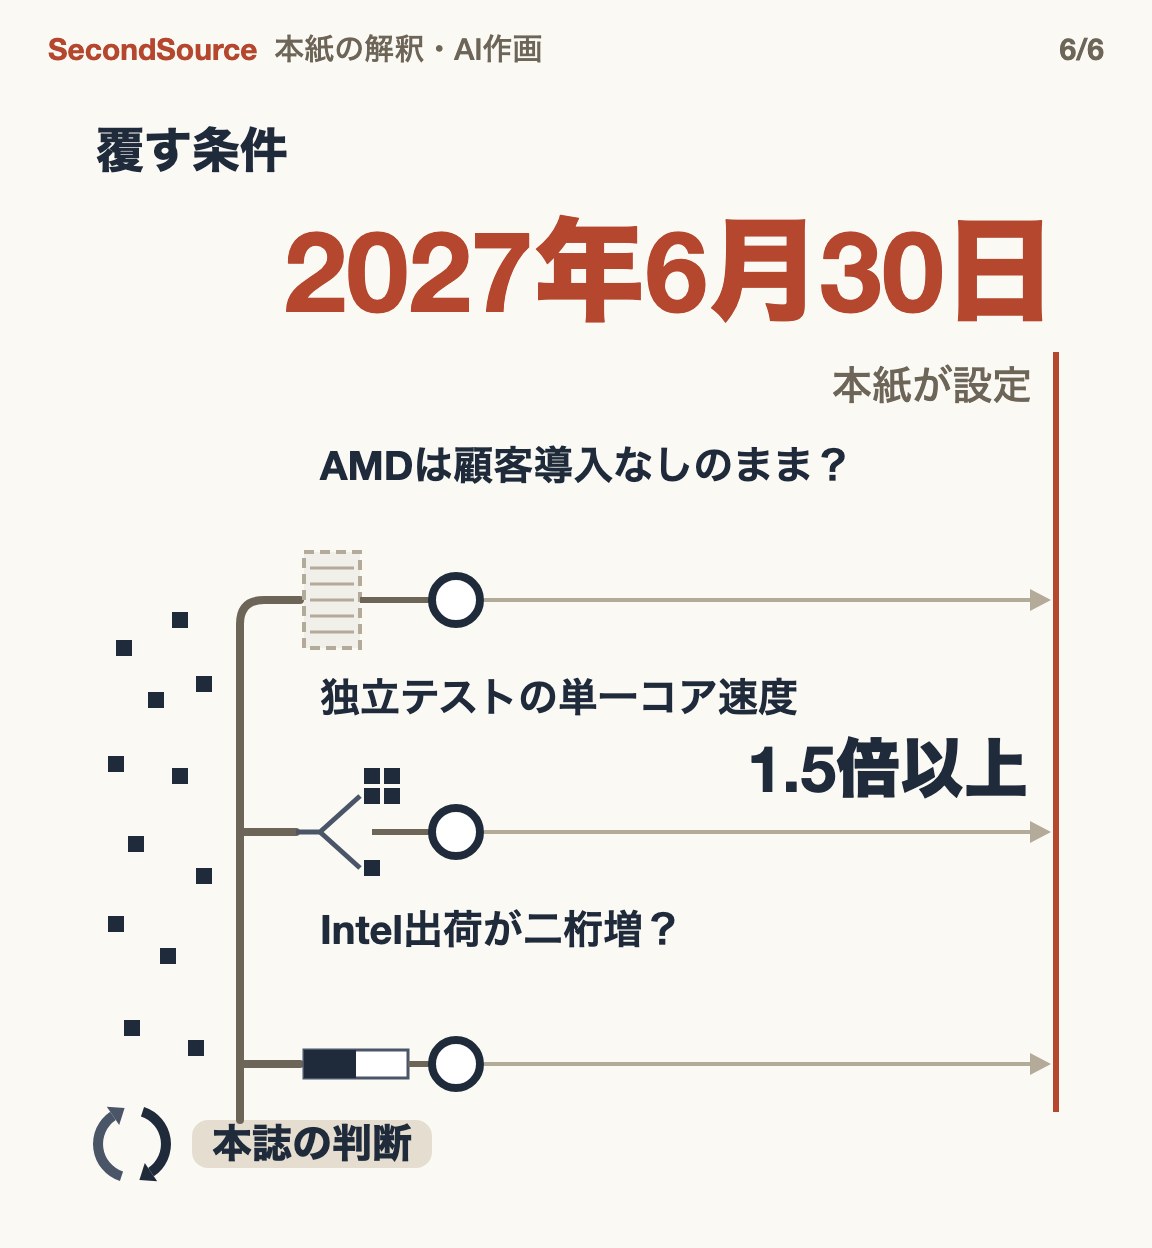
以下の三つの条件の判定期限は、いずれも 2027 年 6 月 30 日である。期限としきい値は、本誌が独自に設けた観察の窓だ。
1. 期限までに、AMD の四半期決算プレスリリースに、Helion の CPU のみのラックをどの顧客にも納入・導入したという記述が一度も出ない。 AMD を試金石にするのは、Helion の CPU のみの構成を、AMD がエージェント専用とはっきり打ち出しているからだ(第 1 節)。出荷は 11 月からで、いまは公の買い手も公表された価格もない。期限までにこれさえどの顧客にも届かなければ、第 2 節の読みは格下げになる。四社が出したのは仕様表の選択肢で、買い手のつく製品の種類とはまだ言えない。
2. 独立した第三者が同じエージェントの負荷で測り、Vera のコアあたりの速さ、またはエージェントの 1 ステップあたりの速さが、比較した CPU の 1.5 倍以上で、しかも密度型の CPU にサンドボックスを開く面で見合う優位がない。 第 4 節の「二つの道が別々の区間を受け持つ」は成り立たず、シングルコアの速さの道が勝つ。
3. Intel の第 3 四半期か第 4 四半期の決算で、サーバーの出荷数量の伸びが前年同期比で二桁に達し、決算資料が需要は供給できる製品を上回ると書かなくなり、同時に AMD と Arm も供給不足を報告していない。 第 5 節の「当面は出荷できる社が取る」は成り立たない。品不足が解け、買い手は前倒しで設計で選ぶようになる。
付録:数字の出どころ
調べた範囲
本稿が調べたのは、メーカーのプレスリリースと製品ページ、Intel の 10-Q(米国の上場企業が四半期ごとに証券取引委員会へ出す報告書)、arXiv の論文、メーカーとパートナーのブログ、そして SemiAnalysis、TrendForce、Futurum などのアナリストの報告である。本文の「ない」「唯一」は、すべてこの範囲の中での話で、誰も買っていないと確定したわけではない。
各数字の出典
| 数字 | 何を測ったか | 誰が言ったか | どこで |
|---|---|---|---|
| 32,768 コア | Helion の CPU のみの構成の 1 ラック最大コア数 | AMD の自己申告 | AMD プレスリリース、2026-10-12 |
| 256 個、22,528 コア、400 TB | Vera CPU ラック 1 ラックの最大 CPU 数、コア数、LPDDR5X メモリ | NVIDIA の自己申告 | NVIDIA 製品ページ、OCP ブログ |
| 46,000 コア、133.45 kW | Xeon 6+ ラック設計の一部構成の 1 ラックのコア数と電力 | Intel の自己申告 | Intel ニュースルーム、OCP 2026 |
| 136 コア、1.99 倍 | AGI CPU 1 個のコア数、24 kW ラックあたりの処理量の AMD EPYC 9755 比 | Arm、Arm の委託を受けた Signal65 | Futurum の記事 |
| 数千万個のコア | Meta が AWS で使う Graviton5 コア | Meta、AWS | 4 月末の発表、TNW の報道 |
| 48 MW、295 MW、約 1 対 6 | Fairwater の CPU・ストレージ棟、GPU クラスターの電力、その比 | SemiAnalysis の現地取材 | SemiAnalysis、2026-02 |
| 約 160 台、3 万コア、300 万個、9 割、5% | DeepSeek のサンドボックス基盤のサーバー数、コア数、1 日のサンドボックス数、申請した割り当ての 5% 未満しか使わない比率 | DeepSeek | DSec 論文、arXiv、2026-09-19 |
| 1.8 倍 | エージェント型の負荷での Vera のコアあたりの持続性能の x86 比 | NVIDIA の自己申告 | NVIDIA ブログ、2026-07 |
| 1.5 倍、1.9 倍 | Perplexity のワークフローの速さと並列のサンドボックス起動の速さ、「現行の本番環境の基準」比 | Perplexity の自社テスト | Perplexity ブログ、2026-07 |
| 9%、48%、38% | Intel のサーバー出荷数量の前年同期比、サーバーの平均販売価格の第 2 四半期と年初来の上昇率 | Intel | Intel 第 2 四半期 10-Q(四半期末 2026-06-27) |
| 約半分 | Intel が満たせる顧客の CPU 需要 | Intel の CEO(報道) | SiliconANGLE の報道 |
第 2 節の四社の詳細
| 社名 | 製品 | 1 ラックの規模(自己申告) | 位置づけの原文 | 時期 |
|---|---|---|---|---|
| AMD | Helion の CPU のみの構成(第 6 世代 EPYC、開発名 Venice) | 最大 32,768 コア | 「エージェント実行専用の容量で、別のモデル推論インフラにつなぐ」 | 2026 年 11 月出荷 |
| NVIDIA | Vera CPU ラック(MGX 仕様を OCP に提供) | 最大 256 個の Vera、22,528 コア、400 TB の LPDDR5X | 「ツールの呼び出し、オーケストレーション、サンドボックスでの実行を支える」。訓練と推論を担う Vera Rubin NVL72 と分担 | 最初のシステムを納入済み |
| Intel | Xeon 6+ のラック設計(ORv3) | 「一部の構成で 1 ラック 46,000 コア超、133.45 kW」 | 「Intel AI for Enterprise Agent Toolkit は今日から Xeon で導入できる」 | 展示中 |
| Arm | AGI CPU のシステム(Supermicro、Verda など) | 1 個 136 コア。Arm の委託を受けた Signal65 の測定では、24 kW ラックあたりの処理量が EPYC 9755 の 1.99 倍 | 「agentic AI のインフラ」 | システム発売済み |
Signal65 の測定は Arm の委託によるもので、独立した測定ではない。四社が名前を挙げる買い手も違う。AMD のプレスリリースは超大規模クラウドを指し、NVIDIA の最初のシステムは AI 研究所と Oracle のクラウドに渡り、Intel は企業向けのエージェントのツールキットを推し、Arm はシステムメーカーを通じて出荷する。四社がラック単位で前面に出す仕様は、どれも密度である。コア数、1 ラックの電力、1 ラックのメモリだ。これは仕様表の数字で、買い手が密度で選んでいるという意味ではない。AMD の Helion には高クロックのサーバー構成もあり、Arm のラックあたりの倍率にはシングルコアの性能も含まれる。
AMD はほかに、次の「agentic CPU」である Verano を初めて見せた。TechTimes の報道によれば、展示したチップは 32 コアの小さなチップ 6 個で最大 192 コア、24 チャネルの LPDDR5X メモリで約 2.9 TB/s、2027 年上半期の量産が目標である。AMD のプレスリリース自体は仕様を書いていない。AMD のサーバー事業を率いる Dan McNamara 氏はこう述べた。「agentic AI は単一の負荷ではない。個人のエージェント、企業のアプリケーション、コードの実行、複雑なワークフローにまたがり、それぞれ必要な計算が違う」。
NVIDIA は 5 月 31 日に Vera を発表した際、「検討中」の顧客として NYSE、Anthropic、OpenAI、SpaceXAI、ByteDance、CoreWeave、Lambda、Nebius、Nscale、OCI を挙げた。7 月には Perplexity がサンドボックス基盤と Vera の測定の数字を公表した。
第 3 節の調達の詳細
- Meta と AWS:Meta のインフラ責任者 Santosh Janardhan 氏は、この契約によって Meta は「われわれの規模に必要な性能と効率で、agentic AI を支える CPU 集約型の処理を動かせる」と述べた。Amazon の CEO の Jassy 氏も、第 1 四半期の決算説明会でこの約束に触れた。
- Microsoft の Fairwater:SemiAnalysis の原文の要旨は「48 MW の CPU・ストレージ棟が、主力の 295 MW の GPU クラスターを支える」。同じ記事は「最先端の AI 研究所は強化学習の訓練に必要な CPU を使い果たしつつあり、汎用の x86 CPU サーバーをめぐってクラウド事業者と直接競っている」とも書く。
- NVIDIA の Vera の最初の納入:NVIDIA の製品ページの説明文は、最初の Vera CPU システムを Anthropic、OpenAI、Oracle Cloud Infrastructure(Oracle のクラウド、略称 OCI)、SpaceXAI に納めたと明記している。
- CoreWeave:1 ラックに 128 個の CPU、11,264 コアで、「11,000 を超える同時の環境」を支える。負荷の形についての原文の要旨は「ループの中の一つのステップが何千もの環境を 1 時間必要とし、次の実行まではほとんど何も要らない」。
- Perplexity:7 月のサンドボックス基盤の記事は「この 1 週間で数百万回のサンドボックス作成と数千万回の再接続を支えた」と書き、仕事ごとに Firecracker の microVM(軽量の仮想マシン)で動かす。CEO は 10 月 3 日、Perplexity Computer の Vera への展開を始めたと述べ、狙いは「自社のサンドボックスを持ち、最良のシリコンに合わせて最適化する」ことだとした。
- 供給の構造:超大規模クラウドは、Graviton、Cobalt、Axion といった自社開発の CPU で自社の負荷をまかなう。外販の半導体メーカーである AMD、Intel、NVIDIA、Arm は、それ以外の買い手に売る。Meta は両方の道を歩んでいる。AWS から Graviton5 の容量を買い、Arm の AGI CPU の共同開発パートナーでもある。
本誌 10 月 13 日号の判断を今回どう直したか
10 月 13 日号は、AMD と NVIDIA の二つの発表をもとに三つの判断を示した。「エージェントが CPU の需要を押し上げる」は Intel の決算説明会での言い分から、競合二社のラック単位の製品に変わった。買い手は容量と電力の予算を GPU と CPU の二つの枠に分ける。AMD はコア密度を、NVIDIA はシングルスレッドの速さを売り、勝った方がシェアを決める。本稿の修正はこうだ。二社は四社に、始まりは 3 月に早まった。二つの枠に分ける点は成り立つが、買い手が買っているのは CPU の容量で、CPU ラックを名指しで買っているわけではない。設計の争いは二つの道が別々の区間を受け持つ話に変わり、当面のシェアは供給で決まる。あの号が設けた二つの覆す条件(2027 年上半期までに大手クラウドが CPU のみのエージェント用ラックを公に調達しない、主要なエージェントの基盤がサンドボックスを汎用クラウドの CPU の枠に残す)は、調べてみるとどちらも一部しか成り立たなかった。CPU の調達はすでにあるが、ラック一式という品目には公の買い手がまだいない。
第 4 節の数字の詳細
- DeepSeek の DSec 論文:DSec は DeepSeek Elastic Compute の略で、9 月 19 日に arXiv で公開された、大規模なエージェントの訓練用のサンドボックス基盤である。論文の要旨は「本番規模の 1 単位は約 160 ノードで、1 日約 300 万個のサンドボックスをさばく。本番では 38 万を超えるサンドボックスを同時に動かし、毎秒 5,000 回を超えるサンドボックス作成を維持している」。基盤全体は「160 近い CPU ノード、3 万コア、約 250 TB の DRAM」である。もう一つの数字は「コンテナと microVM のサンドボックスの約 90% が、申請した CPU 容量の 5% 以下しか平均して使っていない」。申請した容量とは、各サンドボックスが前もってスケジューラーに求める CPU の割り当てのことだ。1 ノードに 800 個の microVM か 3,200 個のコンテナを載せられる。ノードは標準的な 2 ソケットの x86 サーバーで、型番はコア数の多い AMD EPYC 9655 である。
- シングルスレッドの自己申告の数字:NVIDIA は 7 月の記事で Vera を「大規模に並べても最高のシングルスレッド性能を出す CPU」と位置づけ、「コアあたりの速さがループの進む速さを決める」と論じた。エージェント型の負荷でコアあたりの持続性能が x86 の 1.8 倍だと自己申告している。Perplexity の自社テストでは「実際の Computer 型のワークフローが現行の本番環境の基準より約 1.5 倍速く、並列のサンドボックス起動は最大 1.9 倍速かった」。CoreWeave は、サンドボックスの起動の速さが x86 CPU 1 個の 3 倍だと自称している。三社の数字は同じものを測っていない。1.8 倍はコアあたりの性能、1.5 倍はワークフロー全体、1.9 倍と 3 倍はサンドボックスの起動の速さである。起動の速さが何に縛られているかを分解した資料はなく、シングルコアの速さで決まるとは限らない。比較の基準はどれも型番を書いておらず、数字はすべてサプライヤーかそのパートナーから出ている。
- 逆向きの自己申告:AMD は、Helion のサーバーのコアあたりの性能が NVIDIA の 88 コアの Vera より 20% 高いと自称している。Futurum の Burke 氏は、AMD が 7 月に出したワットあたりのエージェント数の比較は「スレッド数と定格電力から理論上の負荷で計算した算術だ」と指摘した。どちらも自己申告で、比較の基準も違う。
- Burke 氏の判断の全文の要旨:6 月の台北のコンピューター見本市(COMPUTEX)の後、Burke 氏は「二つの agentic CPU の論点はエージェントのライフサイクルの別々の点を狙っており、これらのチップは置き換え合うより補い合うことになる可能性が高い」と書いた。Intel の Xeon 6+ は企業向け推論の密度と並列性に、NVIDIA の Vera はオーケストレーションの速さと小刻みな強化学習のサンドボックスのループに最適化している、という見立てである。
- もう一つの限界:二つの設計を同じ負荷で比べた独立した測定は、いまのところない。
第 5 節の決算と価格の詳細
- Intel 第 2 四半期 10-Q の原文の要旨:サーバーの売上は「平均販売価格がそれぞれ 48% と 38% 上がった」ことで増えた。「サーバーの平均販売価格の上昇の大半は、第 2 四半期と年初来に高価格帯の製品の構成比が高かったことによるもので、需要に応じた価格設定の寄与は小さい」。「サーバーの出荷数量は前年の第 2 四半期より 9% 増え、主に超大規模クラウドの需要の増加による」。「社内の供給制約により、市場の需要が供給できる製品を上回った」。
- CEO の発言:報道によれば、CEO の Lip-Bu Tan 氏は 9 月、Splunk の大会で、Intel は顧客の CPU 需要の約半分しか満たせないと述べた。同じ報道によれば、Intel は 2026 年の設備投資を 200 億米ドル超に引き上げた。
- 価格:SemiAnalysis は 2 月、「Intel は CPU の在庫が予想外に尽き、Xeon 全体の値上げを検討している」と書いた。TrendForce の 9 月末の報告は、Intel と AMD が「第 1 四半期末に一部の CPU 製品の価格を引き上げた」としている。10 月に台湾メディアが報じた新しい値上げは主に Intel と Qualcomm のパソコン用プロセッサーで、AMD も値上げを準備していると報じられた。こちらはパソコンの製品群で、サーバーの製品群ではない。
- AMD:2030 年のサーバー用 CPU 市場の予測を 2,000 億米ドル超に引き上げた。
- 設計の争いの時期:2027 年末、AMD の Venice と Verano、NVIDIA の Vera、Intel の Xeon 6+ が同じサーバー用 CPU の枠を争い、そのとき初めて実測で比べられる。
CPU と GPU の比率
TrendForce は「いまの AI データセンターの CPU と GPU の比はおよそ 1:4 から 1:8」で、「将来は 1:1 から 1:2 の間に移る見込み」と書く。Arm は、1 GW あたりの CPU のコア数が 3,000 万から 1.2 億に増えると見積もる。Intel の CEO は 1 月、「以前は 1 対 8、いまは 1 対 4 で、同等かそれ以上に向かっていると思う」と述べた。これらはすべてサプライヤーかアナリストの見積もりで、個数、電力、コア数の基準が混ざっている。公開資料で唯一の実際のキャンパスの例は Fairwater で、電力の比は約 1 対 6、しかもストレージを含む。Fairwater の数字は電力の比で、上の個数ベースの比とは分母が違うため、そのまま比べることはできない。
本誌が追うトレンドライン
併存 ⇄
本稿とこのトレンドの関係: このトレンドはもともとアクセラレーターの層の話だった。訓練は GPU に残り、クラウドが自社で使う推論は自社開発チップに移る。エージェント実行の層が現れたことで、同じ境界線が一段下まで延びた。自社の負荷が固定で量も十分なクラウドは自社開発の CPU を使い、それ以外は外販の CPU を買う。このトレンドの元の判断は変わらない。
本記事は日本語版・英語版・中国語版と同一の調査と判断にもとづいて書かれています。
出典にはリンクを付け、原文書と報道を区別し、確かめられなかった点を明記しています。
ご意見・ご感想は ops@secondsource.io までお寄せください。
この記事が依拠した出典
以下は、この記事が引いた事実の記録から機械的にまとめた出典で、各行はそのうち一つの事実の出どころである。
- AMD Investor Relations:Introducing AMD Helion, Agentic AI Compute at Rack Scale
- NVIDIA Blog:OCP Global Summit: Amid Ecosystem Adoption, NVIDIA Opens Vera Rubin Architecture to Help Scale AI Factories Wo…
- Stratechery · 2026:An Interview with Nvidia CEO Jensen Huang About Accelerated Computing — Stratechery by Ben Thompson
- Stratechery · 2026-01:Intel Earnings, The Agentic Opportunity, Intel's Mistaken Pessimism
- Stratechery · 2026-04:Intel Earnings, Intel's Differentiation?, Whither Terafab
- X / @Beth_Kindig · 2026-07-12:x.com/Beth_Kindig/status/2076377926543515895
- Sharp Tech / Stratechery · 2026-03-23:Why Claude Is NOT a Commodity (So Far) — Sharp Tech (Ben Thompson)
- X / @jukan05 · 2026-10-12:x.com/jukan05/status/2109474246036791622
他言語版が引いた出典
以下の出典は、この記事の他言語版の本文ではリンクされているが、この版の本文にはないため、ここに補う。
- thenextweb.com/news/meta-amazon-graviton-chips-agentic-ai
- newsletter.semianalysis.com/p/cpus-are-back-the-datacenter-cpu
- nvidia.com/en-us/data-center/products/vera-rack/
- intel.com/content/www/us/en/newsroom/news/artificial-intelligence/intel-accelera
- futurumgroup.com/insights/arm-agi-cpu-posts-2x-the-agentic-work-per-rack-of-amds
- techtimes.com/articles/329005/20261014/amd-helion-ocp-blueprint-adds-model-route
- investor.nvidia.com/news/press-release-details/2026/NVIDIA-Unveils-Vera-the-CPU-
- coreweave.com/news/coreweave-to-offer-nvidia-vera-the-first-cpu-built-for-ai-age
- perplexity.ai/hub/blog/secure-sandboxes-for-agents
- arxiv.org/html/2609.22978v1
- blogs.nvidia.com/blog/nvidia-vera-max-single-threaded-cpu-at-scale/
- futurumgroup.com/insights/amd-helion-makes-the-cpu-rack-a-first-class-citizen-of
- futurumgroup.com/insights/computex-2026-are-agentic-cpus-rivals-or-complements/
- sec.gov/Archives/edgar/data/50863/000005086326000157/intc-20260627.htm
- siliconangle.com/2026/10/13/intel-bets-the-next-phase-of-ai-belongs-to-the-right
- trendforce.com/insights/agentic-ai-cpu-gpu