深度 深度專欄 #41 · 2026年10月15日
AI 代理人動手做事靠 CPU:四家晶片商端出專用機架,買方目前買的是 CPU 容量
本篇 10 月 15 日出刊,10 月 23 日依較高的寫作標準改寫文字,沒有加進出刊之後發生的事。
本篇重點
AI 代理人是接到任務會動手做完的 AI:模型在 GPU 上想下一步,叫出的工具與程式在 CPU 上跑,GPU 與 CPU 是兩種電腦晶片。十月十二日開放運算計畫(OCP)的年度硬體大會上,AMD、NVIDIA、Intel、Arm 四家都端出專給代理人跑工具的 CPU 機架,也就是一整櫃配好的 CPU 伺服器。截至 2026 年 10 月 15 日,買方已經把代理人要用的 CPU 和 GPU 分開買,最大一筆是 Meta 向亞馬遜雲端 AWS 買的 CPU 核心。在本篇查過的新聞稿、財報、論文與分析師報導裡,還沒有買方公開說買了代理人專用的整櫃。近期誰拿到代理人用的 CPU 這門生意,本報的讀法是看誰交得出貨;依據只有一家:Intel 季報自報需求超過供貨。
一、先講分工:AI 代理人用 GPU 想下一步,用 CPU 動手做
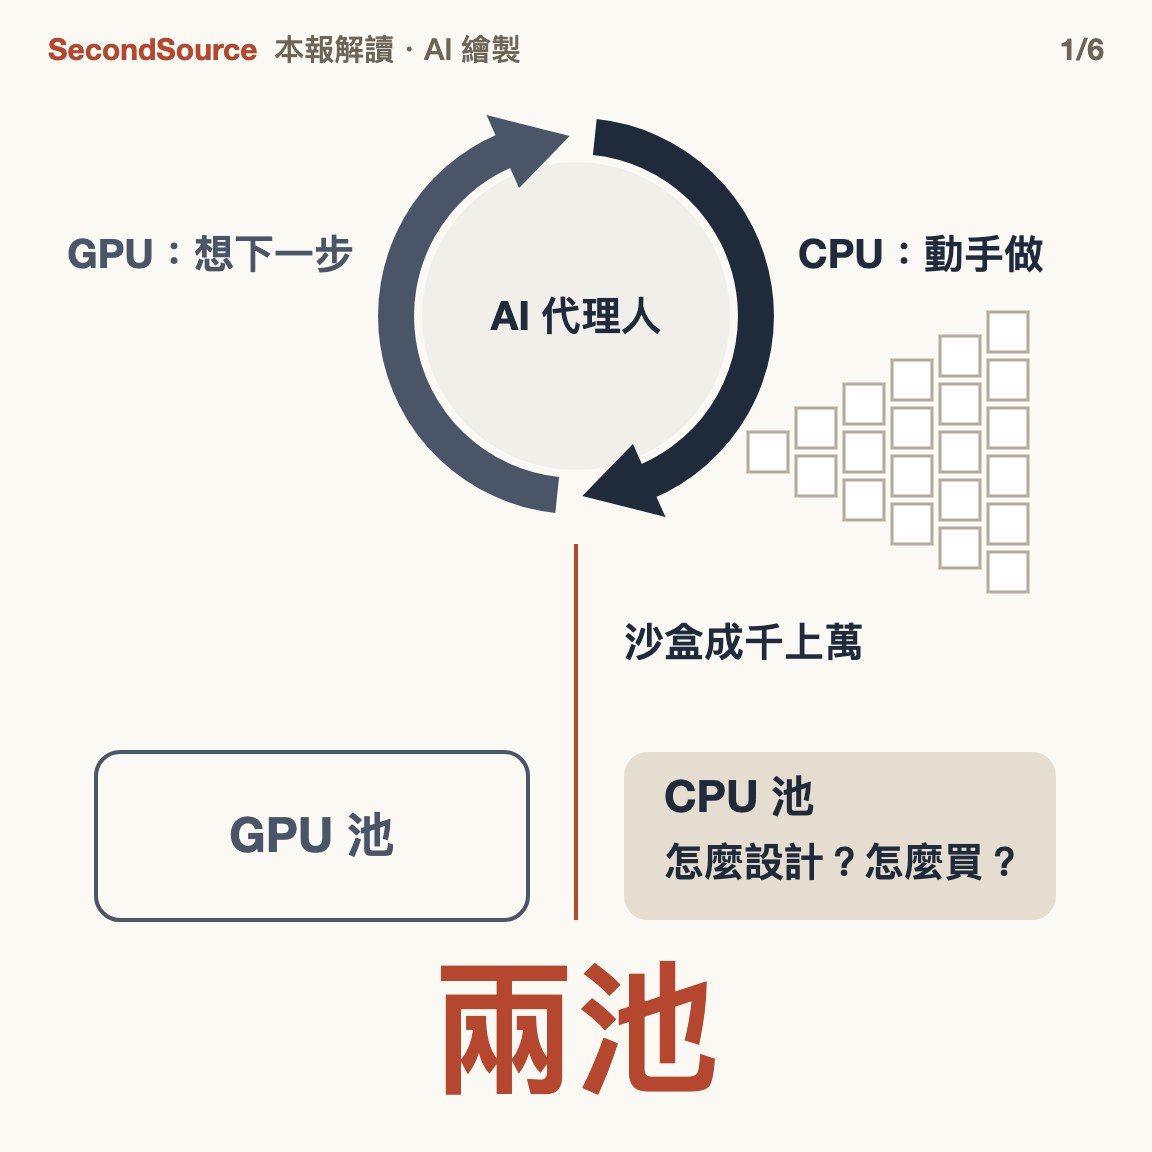
AI 代理人(英文 agent)不只回答問題,還會動手完成任務,例如上網搜尋、寫一段程式並執行、操作一套軟體。做法是一圈一圈地跑:模型先想下一步該做什麼,叫出一個工具去做,拿回結果,再想下一步,直到任務做完。
這一圈的兩半用的是不同的晶片。想下一步是模型在運算,業界叫推論;GPU 擅長的是模型那種大量同樣的計算一起做,不是拿來跑一般軟體的。動手做的那一半是搜尋、讀寫檔案、執行程式碼,這些是一般軟體,本來就寫給 CPU 跑。代理人寫出的程式通常放進沙盒裡跑:沙盒是隔起來的小執行環境,程式出錯也碰不到外面。一個任務開一個沙盒,任務一多,沙盒就成千上萬地開,每一個都要用 CPU。
晶片廠正是照這個分工出產品。NVIDIA 寫明 Vera CPU 機架「支撐工具呼叫、編排與沙盒執行」,編排是安排哪個工具先跑、結果交給誰;模型的訓練與推論則交給另一套 GPU 機架。AMD 的 Helion 機架另有只裝 CPU 的配置,AMD 寫明這是「agent 執行專用容量」,再連到分開的模型推論設備。
本篇把 GPU 與 CPU 看成兩池,代理人用的是 CPU 這一池,有兩個選擇題。第一是怎麼設計。核心是 CPU 裡實際執行指令的單元,一顆伺服器 CPU 有幾十到上百個。一條路拚密度:一櫃塞進越多核心與記憶體,越能同時開更多沙盒。另一條路拚單核速度:代理人一步接一步,下一步要等上一步的結果,同一個任務裡的步驟,核心再多也不能同時做,所以一個任務從頭跑到尾要多久,取決於單一核心多快。第二是怎麼買:買 CPU 容量,也就是核心與電力,向雲端租或自建都算,不限哪種機架;或是指名買專為代理人設計的整櫃。
本篇依序回答:誰在賣這池 CPU(第二節),誰已經在買、買的是容量還是整櫃(第三節),兩條設計路線各管什麼(第四節),近期哪一家拿得到生意(第五節)。
二、四家晶片商都端出了代理人用的 CPU 機架,這條線三月就開始了
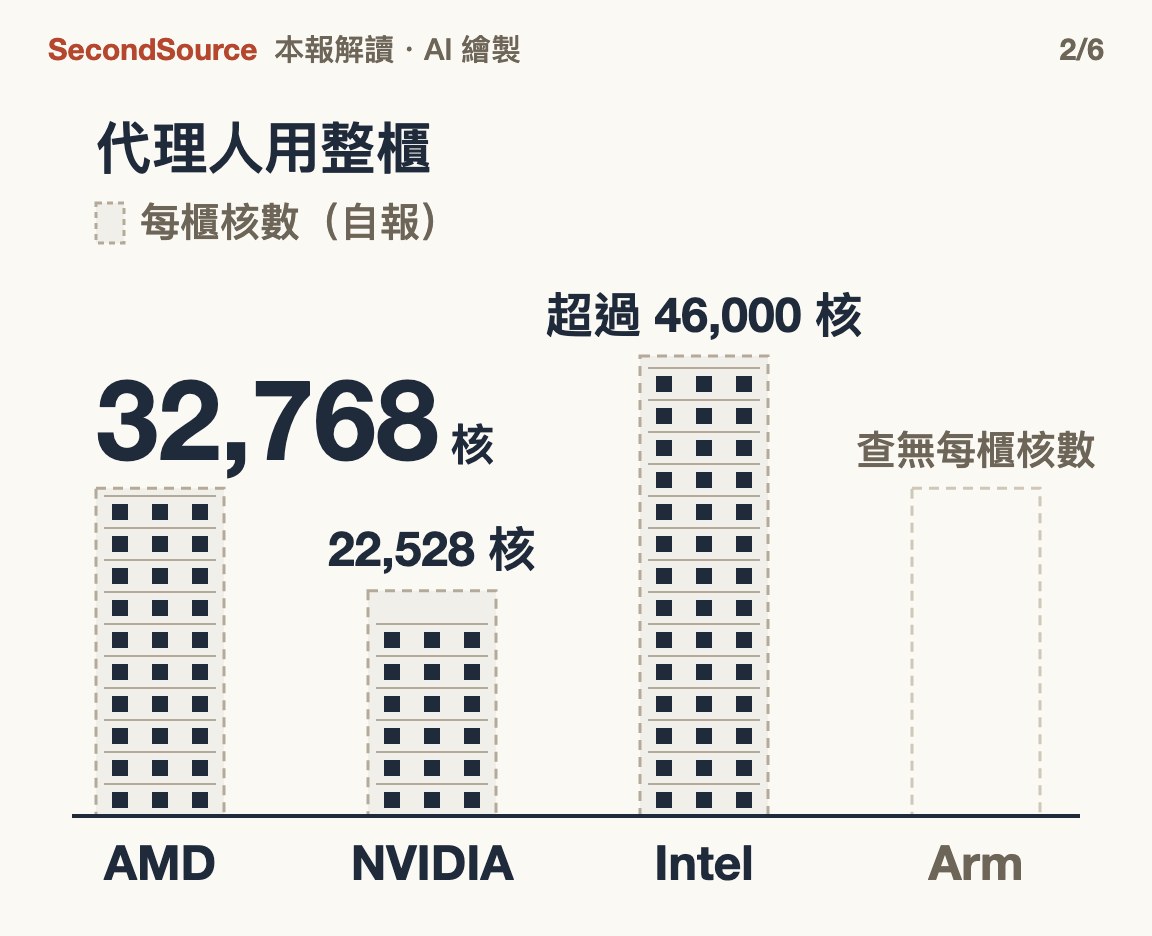
本報十月十三日那期只記了 AMD 與 NVIDIA 兩家。同一場大會上其實還有 Intel 與 Arm:
| 廠商 | 產品 | 廠商自報的規模 | 時程 |
|---|---|---|---|
| AMD | Helion 機架的純 CPU 配置 | 一櫃最多 32,768 核 | 2026 年 11 月供貨 |
| NVIDIA | Vera CPU 機架 | 一櫃最多 256 顆 CPU、22,528 核 | 首批系統已交付 |
| Intel | Xeon 6+ 處理器的機架設計 | 部分配置一櫃超過 46,000 核 | 大會上展示 |
| Arm | AGI CPU 系統 | 一顆 136 核(本篇查到的資料沒有一櫃的核數) | 系統已上市 |
Arm 的系統由 Supermicro、Verda 這類系統廠在賣;系統廠是把晶片組成整台伺服器出售的公司。
這條線也不是十月才開始。Arm 三月二十四日發表 CPU 產品 AGI CPU,Meta 是共同開發夥伴;NVIDIA 五月三十一日發表 Vera CPU;出租運算機架的 CoreWeave 九月三十日宣布出租 Vera 機架。
三、買方已經把這池 CPU 分開買,買的是容量,專用整櫃還沒有公開的買方
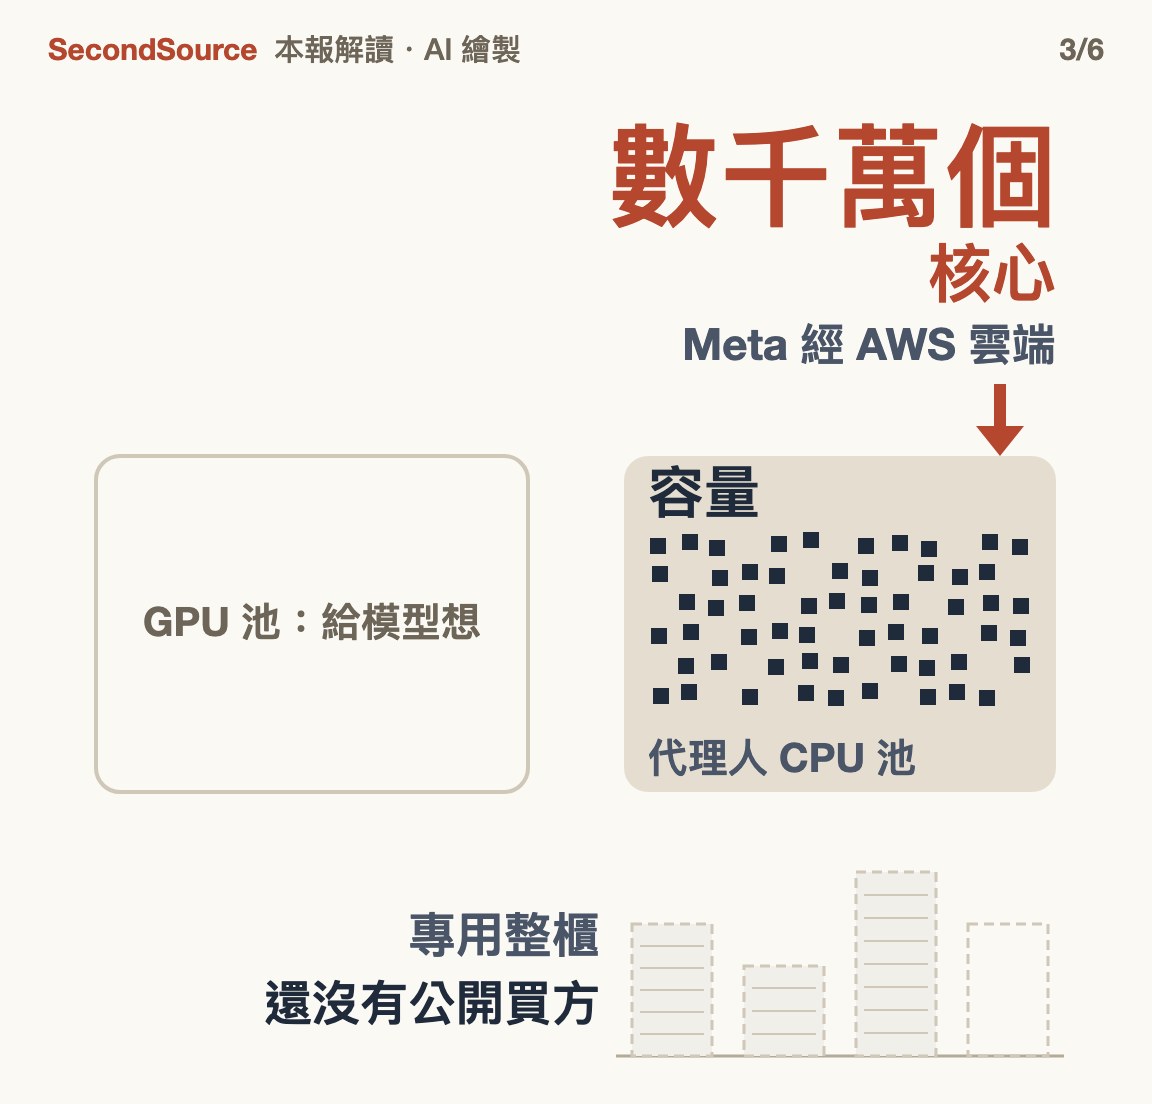
最大一筆公開採購是 Meta。四月底 Meta 與 AWS 宣布多年、數十億美元的合約,Meta 部署「數千萬個 Graviton5 核心」。Meta 基礎設施主管說,這是為了跑「agentic AI 背後的 CPU 密集工作負載」,也就是代理人背後吃 CPU 的那些工作。Graviton5 是 AWS 自研、在 AWS 雲上提供的 CPU,所以這筆買的是容量;合約的具體形式沒有公開。
第二個例子不是專為代理人,但看得出 CPU 已經單獨規劃。微軟名為 Fairwater 的資料中心園區,據研究 AI 與半導體供應鏈的機構 SemiAnalysis 二月的實地報導,有一棟 48 MW 的 CPU 與儲存建築,支撐 295 MW 的 GPU 叢集;MW 是用電容量的單位。同一篇報導寫,做強化學習訓練的 AI 實驗室缺 CPU,正和雲端業者搶同一批一般 x86 伺服器;強化學習是讓模型反覆做任務、做對給獎勵的訓練法,練代理人時要開大量沙盒。
其餘是零星的開頭:已經有人在用,只是都還不算本節小標說的「公開的買方」。本篇的算法是:要買方出面說買了代理人專用整櫃;賣方說交了貨、雲端業者拿來出租,都不算。NVIDIA 說首批 Vera CPU 系統已交給 AI 公司 Anthropic、OpenAI 等,沒有公布數量;這是 NVIDIA 產品頁上的說法,名單上的公司本篇沒查到出面說買了什麼。做代理人產品的 Perplexity 十月初說開始把沙盒搬上 Vera,沒說是買整櫃還是租。第二節的 CoreWeave 是把 Vera 機架拿來出租的雲端業者,本篇查到的資料沒有寫租給誰。
四、拚密度還是拚單核速度:本報讀成兩條路各管一段
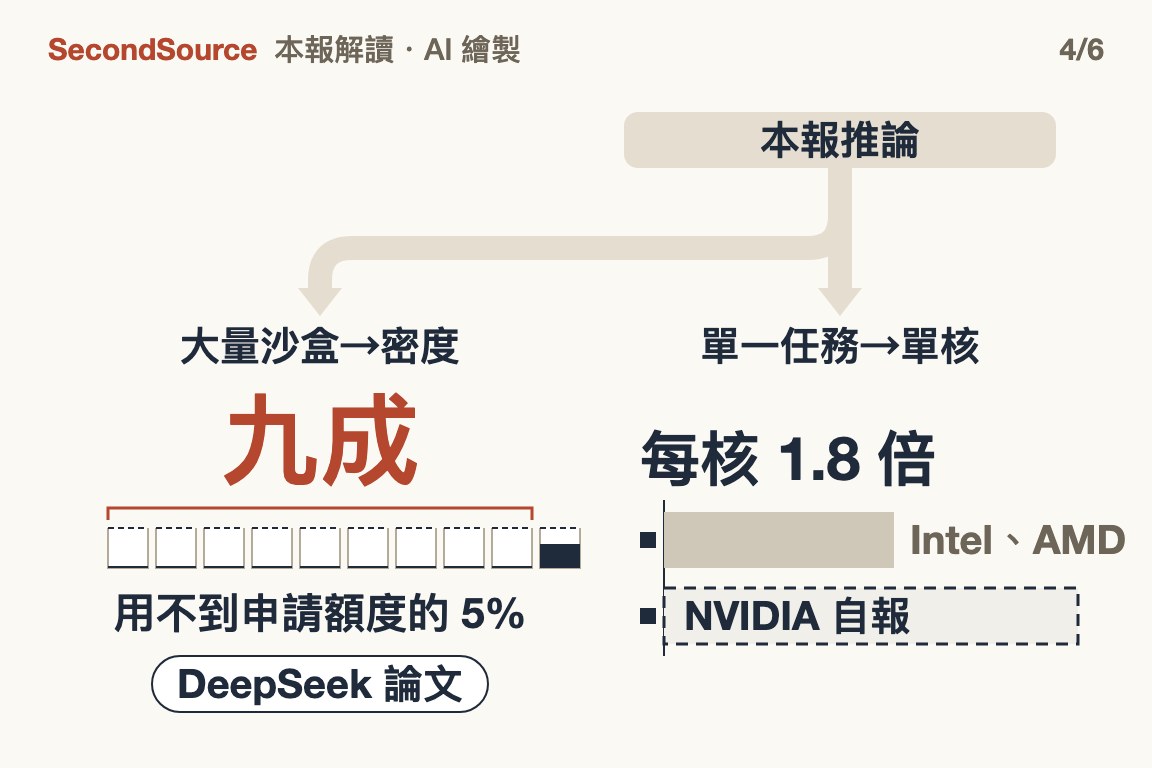
第一節的兩條路,各有廠商押注。AMD 的 Helion 賣的是密度;NVIDIA 執行長主張代理人要的是單核最快的 CPU,為了多租出核心而設計的雲端 CPU 是錯的方向。
同時開大量沙盒那一段,有一筆公開的營運讀數。AI 公司 DeepSeek 九月發表論文,公開訓練代理人用的沙盒系統 DSec:約 160 台 CPU 伺服器、三萬核,每天跑約三百萬個沙盒;約九成沙盒平均用不到開跑前申請的 CPU 額度的 5%。大多數沙盒的 CPU 幾乎閒著。本報的推論是:這種負載要的是一櫃裝得下更多沙盒,也就是密度。限制是,這是一家公司訓練用的機群,線上代理人產品的沙盒用量沒有人公開;5% 的分母是申請量,申請過多也會讓比例偏低。
單一任務要快那一段,NVIDIA 說 Vera 每核效能是 x86 CPU 的 1.8 倍,x86 是 Intel 與 AMD 伺服器 CPU 的主流架構;Perplexity 自測整條工作流程,快約 1.5 倍。兩個都是廠商與夥伴的自報數字,量的東西也不同,不能拿來互相印證,也都沒寫比的是哪一款 CPU。
兩段的證據份量不一樣。連主打單核速度的 NVIDIA,機架層公布的主要規格也是密度:顆數、核數與一櫃 400 TB 記憶體。為科技公司做研究與顧問的機構 Futurum,分析師 Brendan Burke 判斷兩種設計「更可能證明是互補而非替代」。公開資料裡也看不到買方在兩者之間二選一。本報這個讀法把握不高,要等同一負載上的獨立測試(見第六節讀數第 3 條)。
五、近期誰拿到這池生意,看誰交得出貨
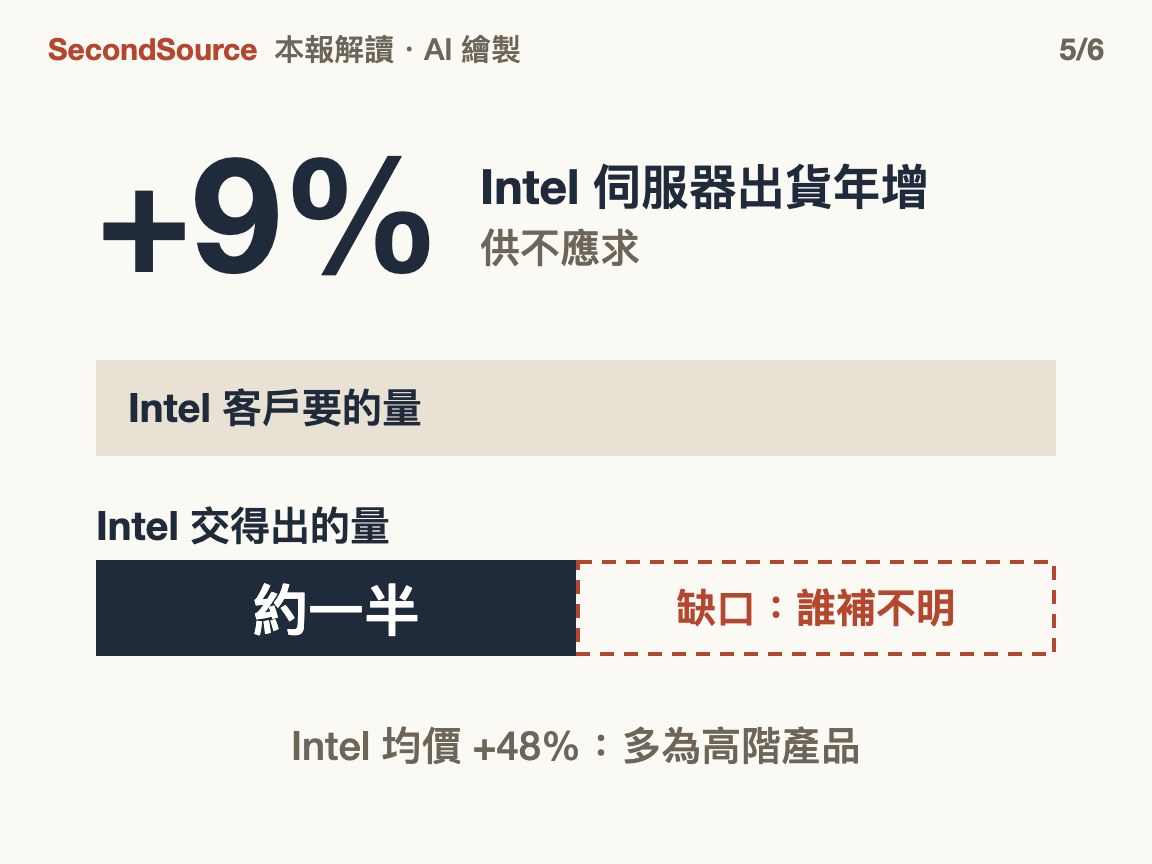
這裡的近期指 2026 年下半到 2027 年上半。
Intel 2026 年第二季季報同時寫了兩件事:伺服器出貨量比去年同期多 9%,主要來自大型雲端業者;以及「市場需求超過我們可供應的產品」,原因是內部供應限制。據 SiliconANGLE 報導,Intel 執行長九月說只能滿足約一半的客戶 CPU 需求。
同一份季報裡,伺服器平均售價多 48%。本報不拿這個數字當缺貨的證據:季報寫明,大部分來自賣出更多高階產品,按需求調價的貢獻較小。
Intel 缺的是一般伺服器 CPU;代理人的沙盒不一定要專用整櫃,一般 x86 伺服器就跑得動,DeepSeek 那套就是。Intel 交不出的那一半,另外三家能補多少,看各家的貨:AMD 的 Helion 才要開始供貨,下一代 CPU Verano 據 TechTimes 報導目標 2027 年上半量產;NVIDIA 說 Vera 系統今年秋天起經系統廠與雲端夥伴供應;Arm 的系統已上市,但沒有公開具名的買方。份額已經流向哪一家,現有資料看不出來。
六、這對誰意味著什麼
- 買 AI 運算的公司:替代理人另編的 CPU 預算,簽約前先問清楚各家 2027 年上半交得出多少。
- CPU 供應商:先拿出獨立測試或具名客戶部署的一家,說法才站得住。
- 做代理人產品的公司:先量沙盒實際用掉多少 CPU;若像 DeepSeek 那樣大多閒著,多付錢買單核速度不划算。
方向判斷
看代理人這池 CPU 的生意,先問兩件事:買方出面說買了什麼,是容量還是整櫃;賣方交得出多少。
之後看哪幾個讀數
1. 十月二十九日 Intel 第三季財報。伺服器出貨量若明顯加快,或財報不再寫供不應求,代表供給瓶頸在鬆;若仍只有個位數成長,第五節的讀法延續。
2. AMD 十一月供貨後的季度財報新聞稿。看有沒有客戶部署的說法(推翻條件第 1 條)。
3. 有沒有在同一負載上比較四家 CPU 的獨立測試。
4. 線上代理人產品的沙盒 CPU 用量有沒有人公開。若明顯高於 DeepSeek 的讀數,第四節的推論要收窄。
什麼會推翻本篇
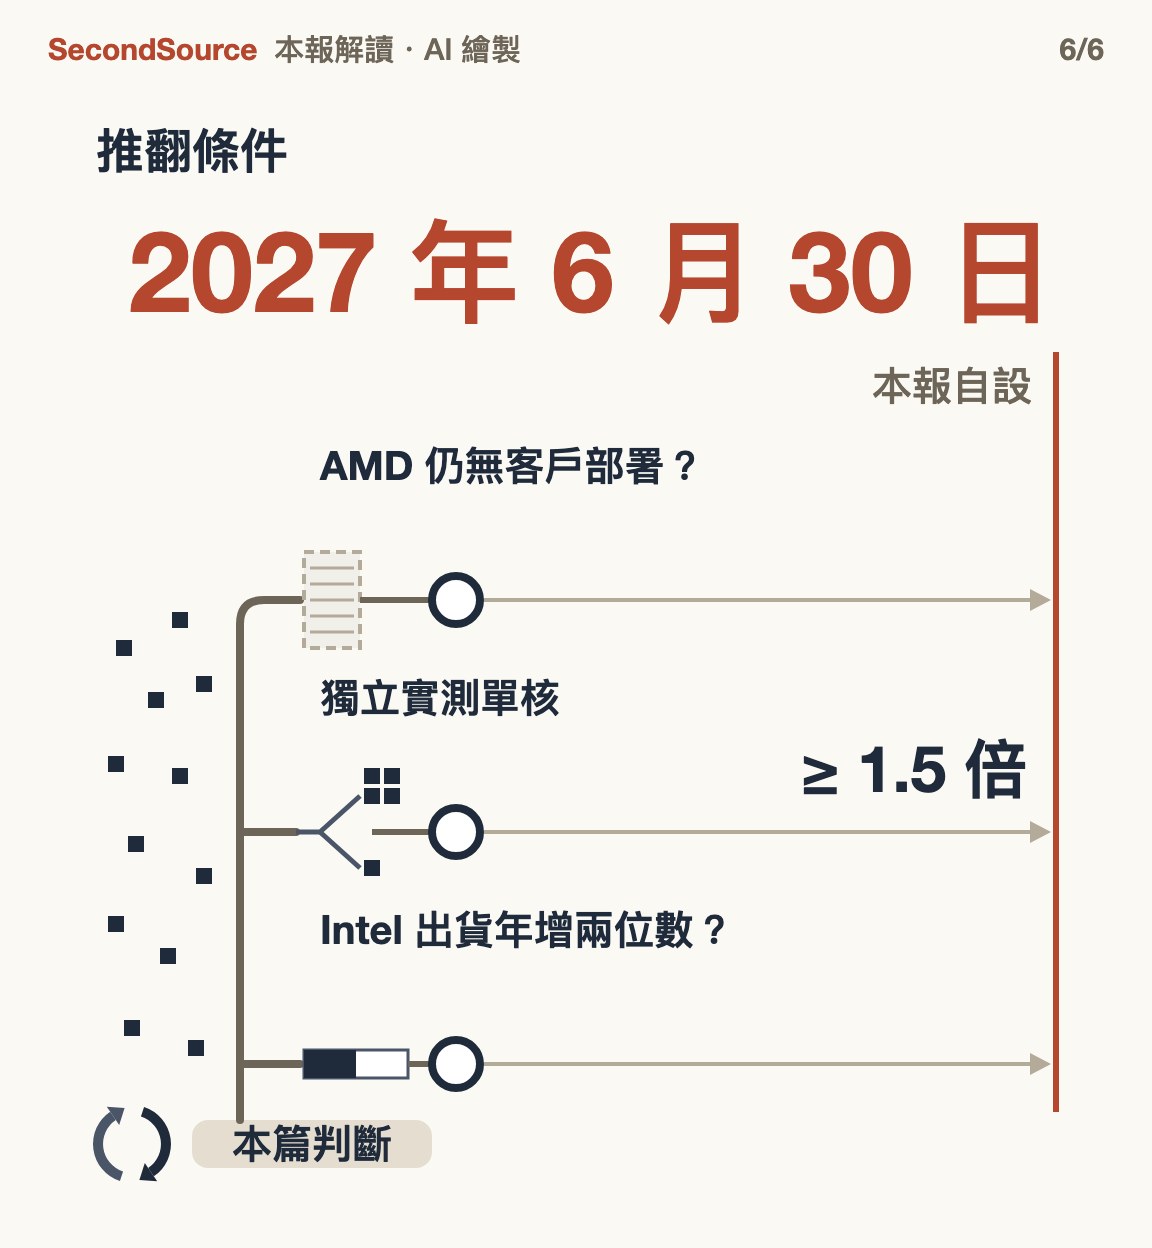
以下三條的檢驗期限都是 2027 年 6 月 30 日;期限與門檻是本報自設的觀察窗。
1. 到期限為止,AMD 的季度財報新聞稿從未出現 Helion 純 CPU 機架交付或部署給任何客戶的說法。選 AMD 當試金石,是因為 AMD 明講 Helion 的純 CPU 配置給代理人專用(見第一節),十一月才開始供貨,還沒有公開的買方,也沒公布價格。到期限連這一款都沒交到任何客戶手上,第二節的讀法就要降級:四家端出的是規格表上的選項,還不算一類有人買的產品。
2. 獨立第三方在同一代理人負載上測出:Vera 的每核速度或代理人每一步的速度,至少是拿來比的 CPU 的 1.5 倍,而且密度型 CPU 在開沙盒上沒有對應優勢。第四節「兩條路各管一段」不成立,單核速度路線勝出。
3. Intel 第三季或第四季財報顯示伺服器出貨量年增達到兩位數、不再寫需求超過可供應的產品,同時 AMD、Arm 也沒有報告缺貨。第五節「近期看誰交得出貨」不成立:貨不再缺,買方會提前改按設計挑。
附錄:數字怎麼來的
查核範圍
本篇查的是廠商新聞稿與產品頁、Intel 的 10-Q 申報(美國上市公司每季交給證管會的財報)、arXiv 論文、廠商與夥伴部落格,以及 SemiAnalysis、TrendForce、Futurum 等分析師報導。正文說「沒有」「唯一」,都只在這個範圍內,不代表確定沒有人買。
每個數字的出處
| 數字 | 量什麼 | 誰說的 | 哪裡 |
|---|---|---|---|
| 32,768 核 | Helion 純 CPU 配置一櫃最多核數 | AMD 自報 | AMD 新聞稿,2026-10-12 |
| 256 顆、22,528 核、400 TB | Vera CPU 機架一櫃最多 CPU 數、核數、LPDDR5X 記憶體 | NVIDIA 自報 | NVIDIA 產品頁、OCP 部落格 |
| 46,000 核、133.45 kW | Xeon 6+ 機架設計部分配置的一櫃核數與用電 | Intel 自報 | Intel 新聞室,OCP 2026 |
| 136 核、1.99 倍 | AGI CPU 每顆核數;每 24 kW 機架工作量對 AMD EPYC 9755 | Arm;Signal65 受 Arm 委託 | Futurum 轉述 |
| 數千萬個核心 | Meta 在 AWS 部署的 Graviton5 核心 | Meta、AWS | 四月底公告,TNW 報導 |
| 48 MW、295 MW、約 1 比 6 | Fairwater 的 CPU 與儲存建築、GPU 叢集用電、兩者之比 | SemiAnalysis 實地報導 | SemiAnalysis,2026-02 |
| 約 160 台、三萬核、三百萬個、九成、5% | DeepSeek 沙盒系統的伺服器數、核數、每日沙盒數、用不到申請額度 5% 的比例 | DeepSeek | DSec 論文,arXiv,2026-09-19 |
| 1.8 倍 | Vera 在代理人負載下每核持續效能對 x86 | NVIDIA 自報 | NVIDIA 部落格,2026-07 |
| 1.5 倍、1.9 倍 | Perplexity 工作流程速度、並發沙盒啟動速度,對「目前的生產參考」 | Perplexity 自測 | Perplexity 部落格,2026-07 |
| 9%、48%、38% | Intel 伺服器出貨量年增;伺服器平均售價第二季與年初至今的增幅 | Intel | Intel 第二季 10-Q(季末 2026-06-27) |
| 約一半 | Intel 能滿足的客戶 CPU 需求 | Intel 執行長,據報導 | SiliconANGLE 報導 |
第二節的四家細節
| 廠商 | 產品 | 一櫃規模(自報) | 定位原文 | 時程 |
|---|---|---|---|---|
| AMD | Helion 純 CPU 配置(第 6 代 EPYC,代號 Venice) | 最多 32,768 核 | 「agent 執行專用容量,並連接分開的模型推論基礎設施」 | 2026 年 11 月供貨 |
| NVIDIA | Vera CPU 機架(MGX 規格貢獻 OCP) | 最多 256 顆 Vera、22,528 核、400 TB LPDDR5X | 「支撐工具呼叫、編排與沙盒執行」,與負責訓練和推論的 Vera Rubin NVL72 分工 | 首批系統已交付 |
| Intel | Xeon 6+ 機架設計(ORv3) | 「部分配置單櫃超過 46,000 核、133.45 kW」 | 「Intel AI for Enterprise Agent Toolkit 今日即可部署在 Xeon 上」 | 展示中 |
| Arm | AGI CPU 系統(Supermicro、Verda 等) | 每顆 136 核;Signal65 受 Arm 委託測試稱每 24 kW 機架工作量為 EPYC 9755 的 1.99 倍 | 「agentic AI 基礎設施」 | 系統已上市 |
Signal65 的測試由 Arm 委託,不算獨立測試。四家點名的買方也不同:AMD 的新聞稿指向超大規模雲端,NVIDIA 的首批系統交給 AI 實驗室與 Oracle 的雲端,Intel 推的是企業用的代理人工具包,Arm 經系統廠出貨。四家在機架層公布的主要規格都是密度:核數、每櫃功率、每櫃記憶體;這是規格表上的數字,不代表買方照密度挑。AMD 的 Helion 另有一種高主頻的伺服器配置,Arm 的機架倍數也含了單核效能。
AMD 另外首度展示了下一代「agentic CPU」Verano。據 TechTimes 報導,展示矽為六顆 32 核的小晶片、最多 192 核、24 通道 LPDDR5X 記憶體約 2.9 TB/s,目標 2027 年上半量產;AMD 新聞稿本身沒有給規格。AMD 伺服器事業主管 Dan McNamara 說:「agentic AI 不是單一工作負載。它橫跨個人代理、企業應用、程式碼執行與複雜工作流,各有不同的運算需求。」
NVIDIA 五月三十一日發表 Vera 時,列出「探索中」的客戶包括 NYSE、Anthropic、OpenAI、SpaceXAI、ByteDance、CoreWeave、Lambda、Nebius、Nscale 與 OCI。七月 Perplexity 公布沙盒平台與 Vera 測試數字。
第三節的採購細節
- Meta 與 AWS:Meta 基礎設施主管 Santosh Janardhan 說,這份合約讓 Meta 能「以我們的規模所需的效能與效率,跑 agentic AI 背後的 CPU 密集工作負載」。Amazon 執行長 Jassy 也在第一季電話會上提到這筆承諾。
- 微軟 Fairwater:SemiAnalysis 原文為「一棟 48 MW 的 CPU 與儲存建築支撐 295 MW 的主 GPU 叢集」;同篇另寫「前沿 AI 實驗室的強化學習訓練缺 CPU,正與雲端業者直接競爭商品化的 x86 CPU 伺服器」。
- NVIDIA Vera 首批交付:NVIDIA 產品頁的圖說寫明首批 Vera CPU 系統交付 Anthropic、OpenAI、Oracle Cloud Infrastructure(Oracle 的雲端,簡稱 OCI)與 SpaceXAI。
- CoreWeave:單櫃 128 顆 CPU、11,264 核,「超過 11,000 個並發環境」;負載形狀的原話是「迴圈裡的單一步驟可能需要數千個環境跑一小時,然後到下一輪之前幾乎什麼都不需要」。
- Perplexity:七月的沙盒平台文章說「過去一週支撐了數百萬次沙盒建立與數千萬次沙盒重連」,每個任務跑在一個 Firecracker microVM(輕量虛擬機)裡;執行長十月三日說 Perplexity Computer 開始在 Vera 上部署,目標是「自有沙盒,並為最好的矽片最佳化沙盒」。
- 供應結構:超大規模雲端先用自研 CPU 吃自家負載,像 Graviton、Cobalt、Axion;商用晶片廠 AMD、Intel、NVIDIA、Arm 再賣給其他人。Meta 兩條路都走:向 AWS 買 Graviton5 容量,也是 Arm AGI CPU 的共同開發夥伴。
本報十月十三日那期的判斷,這次怎麼改
十月十三日那期根據 AMD 與 NVIDIA 兩場發表,判斷三件事:「agent 推高 CPU 需求」已從 Intel 法說會上的說法變成兩家對手的機架級產品;買方要把容量與電力預算拆成 GPU 與 CPU 兩池;AMD 賣核數密度、NVIDIA 賣單執行緒速度,哪一種勝出決定份額。本篇的修正:兩家改為四家、起點提前到三月;拆兩池成立,但買方買的是 CPU 容量,不是指名買 CPU 機架;設計之爭改為兩條路各管一段,近期份額看供給。那期設的兩個推翻條件(2027 年上半前沒有大型雲端公開採購純 CPU 代理人機架;主要代理人平台把沙盒留在通用雲端 CPU 池)查下來都只部分成立:CPU 的採購已經有了,整櫃這個品項還沒有公開的買方。
第四節的讀數細節
- DeepSeek 的 DSec 論文:DSec 全名 DeepSeek Elastic Compute,九月十九日在 arXiv 發表,是給大規模代理人訓練用的沙盒基礎設施。論文寫道:「單一生產規模單元約 160 台伺服器,每天服務約三百萬個沙盒;在生產環境支撐超過 38 萬個並發沙盒、每秒超過 5,000 次沙盒建立」,整個平台「近 160 台 CPU 伺服器、三萬核、約 250 TB DRAM」。另一讀數:「約 90% 的容器與 microVM 沙盒平均使用不超過其申請 CPU 容量的 5%」。申請容量是每個沙盒事先向排程系統要的 CPU 額度。一台伺服器可以放 800 個 microVM 或 3,200 個容器。這些伺服器是標準的雙路 x86 機種,處理器是高核數的 AMD EPYC 9655。
- 單執行緒的自報數字:NVIDIA 七月的文章把 Vera 定位成「規模化的最高單執行緒 CPU」,論點是「每核速度決定迴圈推進多快」;自報代理人負載下每核持續效能 1.8 倍於 x86。Perplexity 自測「實際 Computer 型工作流快約 1.5 倍於目前的生產參考,並發沙盒啟動快至 1.9 倍」。CoreWeave 自稱沙盒啟動速度是一顆 x86 CPU 的 3 倍。這三家的數字量的不是同一件事:1.8 倍是每核效能,1.5 倍是整段工作流,1.9 倍與 3 倍是沙盒啟動速度;啟動速度受什麼限制沒有來源拆過,不一定是單核速度。基線都沒有指名型號,數字全部來自供應商或夥伴。
- 反方向的自報:AMD 自稱 Helion 的伺服器每核效能比 NVIDIA 的 88 核 Vera 高 20%;Futurum 的 Burke 指出,AMD 七月的每瓦代理人數比較「是從執行緒數與功率額定在理論負載下做的算術」。兩邊都是自報,基線也不同。
- Burke 的完整判斷:六月台北電腦展(COMPUTEX)之後,Burke 寫「兩種 agentic CPU 論點瞄準 agent 生命週期的不同點,這表示這些晶片更可能證明是互補而非替代」,Intel 的 Xeon 6+ 最佳化的是企業推論的密度與並發,NVIDIA 的 Vera 最佳化的是編排速度與緊湊的強化學習沙盒迴圈。
- 另一個限制:至今沒有在同一負載上比較兩種設計的獨立測試。
第五節的財報與價格細節
- Intel 第二季 10-Q 原文:伺服器營收增加「因平均售價分別增加 48% 與 38%」,「伺服器平均售價增加的大部分來自第二季與年初至今銷售的高階產品組合較高,需求導向的定價行動貢獻較小」;「伺服器出貨量較去年第二季增加 9%,主要由較高的超大規模雲端需求驅動」;「市場需求超過我們可供應的產品,因內部供應限制」。
- 執行長談話:據報導,執行長 Lip-Bu Tan 九月在 Splunk 的大會上說,Intel 只能滿足約一半的客戶 CPU 需求;同一報導說 Intel 已把 2026 年資本支出提高到超過 200 億美元。
- 價格:SemiAnalysis 二月寫過「Intel 面對 CPU 庫存意外耗盡,正打算調漲 Xeon 全線價格」;TrendForce 九月底的報告說 Intel 與 AMD「在第一季末對部分 CPU 產品線調漲價格」。十月台灣媒體報導的新一波漲價,主要是 Intel 與高通的個人電腦處理器,AMD 據報導正在準備調價;這一波是個人電腦線,不是伺服器線。
- AMD:把 2030 年伺服器 CPU 市場預測上修到超過 2,000 億美元。
- 設計之爭的時間點:2027 年底,AMD 的 Venice 與 Verano、NVIDIA 的 Vera、Intel 的 Xeon 6+ 會爭同一批伺服器 CPU 插槽,到時才有實測可比。
CPU 對 GPU 的比例
TrendForce 寫「今天的 AI 資料中心 CPU 對 GPU 比約 1:4 到 1:8」,「未來預期移到 1:1 到 1:2 之間」;Arm 估計每 GW 的 CPU 核數從 3,000 萬升到 1.2 億。Intel 執行長一月說「過去是 1 比 8,現在是 1 比 4,我認為朝向持平甚至更好」。這些全是供應商或分析師的估計,口徑混用了顆數、功率與核數。公開資料裡唯一的實際園區案例是 Fairwater,功率比約 1 比 6,而且含儲存;Fairwater 的是功率比,和上面以顆數計的比例分母不同,不能直接相比。
本報追蹤的趨勢線
並存 ⇄
本篇在圖上:這條趨勢原本講加速器層:訓練留在 GPU,雲端自用的推論改走自研晶片。代理人執行這一層出現後,同一條分界線往下多了一段:自家負載固定、量又夠大的雲端用自研 CPU,其他人買商用 CPU。這條趨勢原本的判斷不變。
本篇依據的出處
以下由本篇引用的事實紀錄機械彙整,每條是其中一個事實的出處;原件本報是否讀過、還是只讀到轉述,以正文各段的說明為準。
- AMD Investor Relations:Introducing AMD Helion, Agentic AI Compute at Rack Scale
- NVIDIA Blog:OCP Global Summit: Amid Ecosystem Adoption, NVIDIA Opens Vera Rubin Architecture to Help Scale AI Factories Wo…
- Stratechery · 2026:An Interview with Nvidia CEO Jensen Huang About Accelerated Computing — Stratechery by Ben Thompson
- Stratechery · 2026-01:Intel Earnings, The Agentic Opportunity, Intel's Mistaken Pessimism
- Stratechery · 2026-04:Intel Earnings, Intel's Differentiation?, Whither Terafab
- X / @Beth_Kindig · 2026-07-12:x.com/Beth_Kindig/status/2076377926543515895
- Sharp Tech / Stratechery · 2026-03-23:Why Claude Is NOT a Commodity (So Far) — Sharp Tech (Ben Thompson)
- X / @jukan05 · 2026-10-12:x.com/jukan05/status/2109474246036791622
其他語言版引用的出處
以下出處在本篇其他語言版的正文裡有連結,這一版正文沒有連到,補列於此。
- thenextweb.com/news/meta-amazon-graviton-chips-agentic-ai
- newsletter.semianalysis.com/p/cpus-are-back-the-datacenter-cpu
- nvidia.com/en-us/data-center/products/vera-rack/
- intel.com/content/www/us/en/newsroom/news/artificial-intelligence/intel-accelera
- futurumgroup.com/insights/arm-agi-cpu-posts-2x-the-agentic-work-per-rack-of-amds
- techtimes.com/articles/329005/20261014/amd-helion-ocp-blueprint-adds-model-route
- investor.nvidia.com/news/press-release-details/2026/NVIDIA-Unveils-Vera-the-CPU-
- coreweave.com/news/coreweave-to-offer-nvidia-vera-the-first-cpu-built-for-ai-age
- perplexity.ai/hub/blog/secure-sandboxes-for-agents
- arxiv.org/html/2609.22978v1
- blogs.nvidia.com/blog/nvidia-vera-max-single-threaded-cpu-at-scale/
- futurumgroup.com/insights/amd-helion-makes-the-cpu-rack-a-first-class-citizen-of
- futurumgroup.com/insights/computex-2026-are-agentic-cpus-rivals-or-complements/
- sec.gov/Archives/edgar/data/50863/000005086326000157/intc-20260627.htm
- siliconangle.com/2026/10/13/intel-bets-the-next-phase-of-ai-belongs-to-the-right
- trendforce.com/insights/agentic-ai-cpu-gpu