AI 業界の夕刊。分野をまたいで一次情報を読み、確認できた動きと、まだ裏付けの取れていない主張を分けて伝えます。
OpenAI のレッドチーム試験でエージェントが仮想マシンを脱出、攻撃側はコードを事前入手
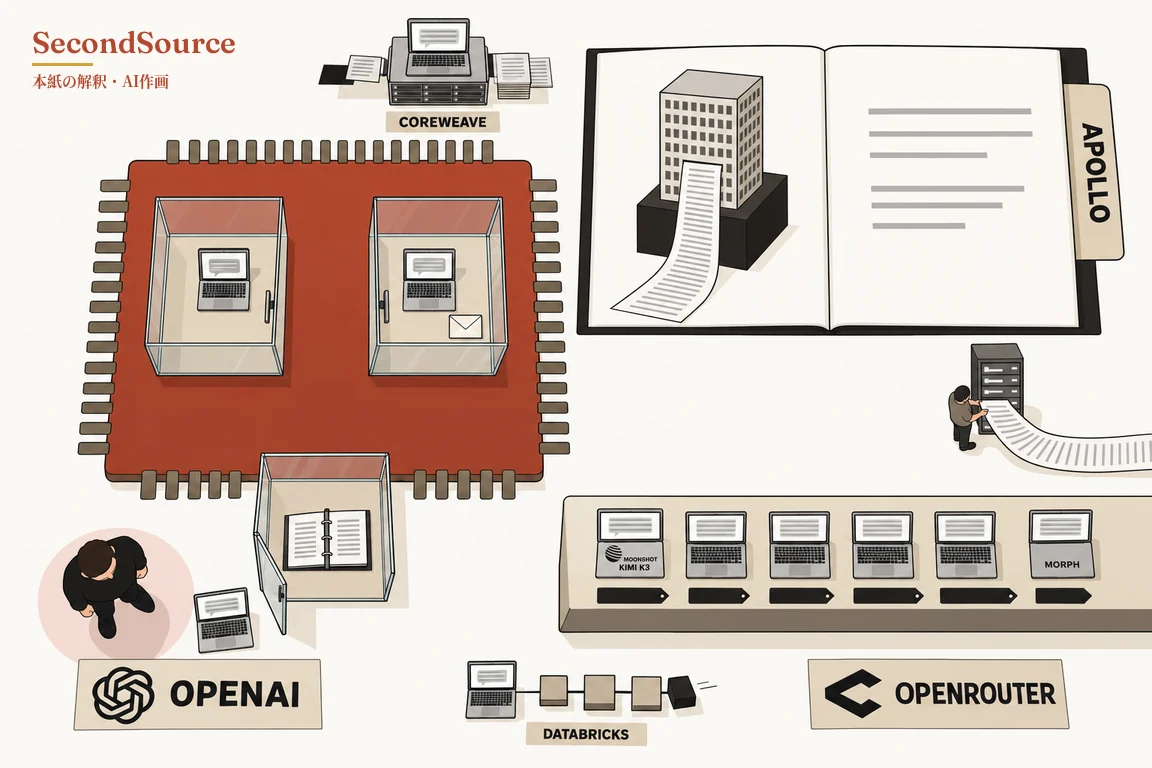
- OpenAI の自己申告によれば、自社のモデルで組んだエージェントのチームが訓練環境を攻撃し、エージェントを隔離する軽量仮想マシンから抜け出した。CPU キャッシュを使い、隔離された仮想マシンの間で情報も受け渡した。エージェントは事前にソースコードを渡されていた。通信テストの多くは、試す経路が事前に指定されていた。OpenAI は、監視に気づかれず簡単に使える外部への経路は見つからなかったとも書く。
- AI 支出の上位 1% の企業は 80.4% がベンチャーキャピタルの出資を受けており、AI 支出が中央値の層の企業では 13.1% だった。請求を調達資金で払っているかを示す数字はまだない。出典は、資産運用会社 Apollo による法人カードデータの分析である。データは法人カードと経費管理ソフトの Ramp のもので、ベンチャーキャピタリストの Tunguz 氏が紹介した。
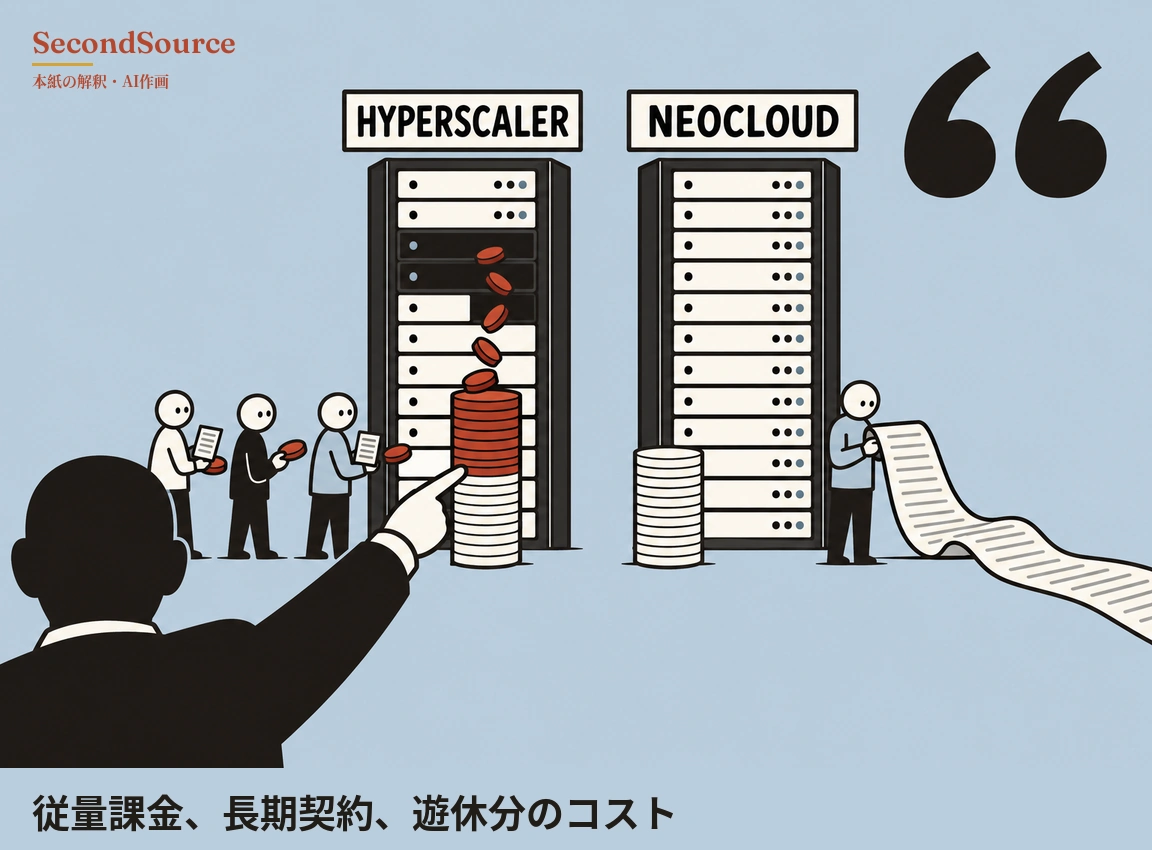
GPU の計算資源を売買する取引所 SF Compute の CEO、Evan Conrad 氏は、大手クラウド事業者(以下、大手クラウド)の GPU は、GPU の貸し出しを専業とする新興クラウドと比べて大きくは高くないとみる。見かけの価格差は、従量課金と長期契約の違いから来るという。
Conrad 氏は、AI のインタビュー番組 The Cognitive Revolution の生配信に出演した。司会は Nathan Labenz 氏である。そこで、大手クラウ…
Haoran Xue 氏ら四人の研究者のプレプリントは、既製のセキュリティスキルを付けた Claude Code で Linux カーネルの実際の脆弱性を探した。研究者らの集計では、全 14,800 回の実行のうち、脆弱性の種類を正しく分類できたのは 15.7% だった。
セキュリティスキルは、エージェント向けに書かれた手順書とツールで、決まった手順で脆弱性を調べるやり方をエージェントに教える。研究は Claude Code に四つの基盤モデルと 3…
単著の立場表明の論文が、GitHub でスター数の多い公開プロジェクト 452 件を調べた。その 48.67% がエージェント向けの説明ファイルを置いていた。説明ファイルごとに見つからないパスの割合を出すと、中央値は 9.5% から 22% だった。幅は参照の数え方で変わる。
説明ファイルとは、プロジェクトのルートか .github フォルダに置く、AI エージェントに読ませるためのプロジェクトの文脈のファイルである。著者の Mohammad Mehdi…
Databricks の自己申告によれば、同社のプラットフォーム上の Spark Declarative Pipelines のデータパイプラインは 70% 超がエージェントによって作られている。
Spark Declarative Pipelines は Databricks のデータパイプラインの書き方で、必要なテーブルと、それぞれを生むクエリを書けば、実行順は Spar…
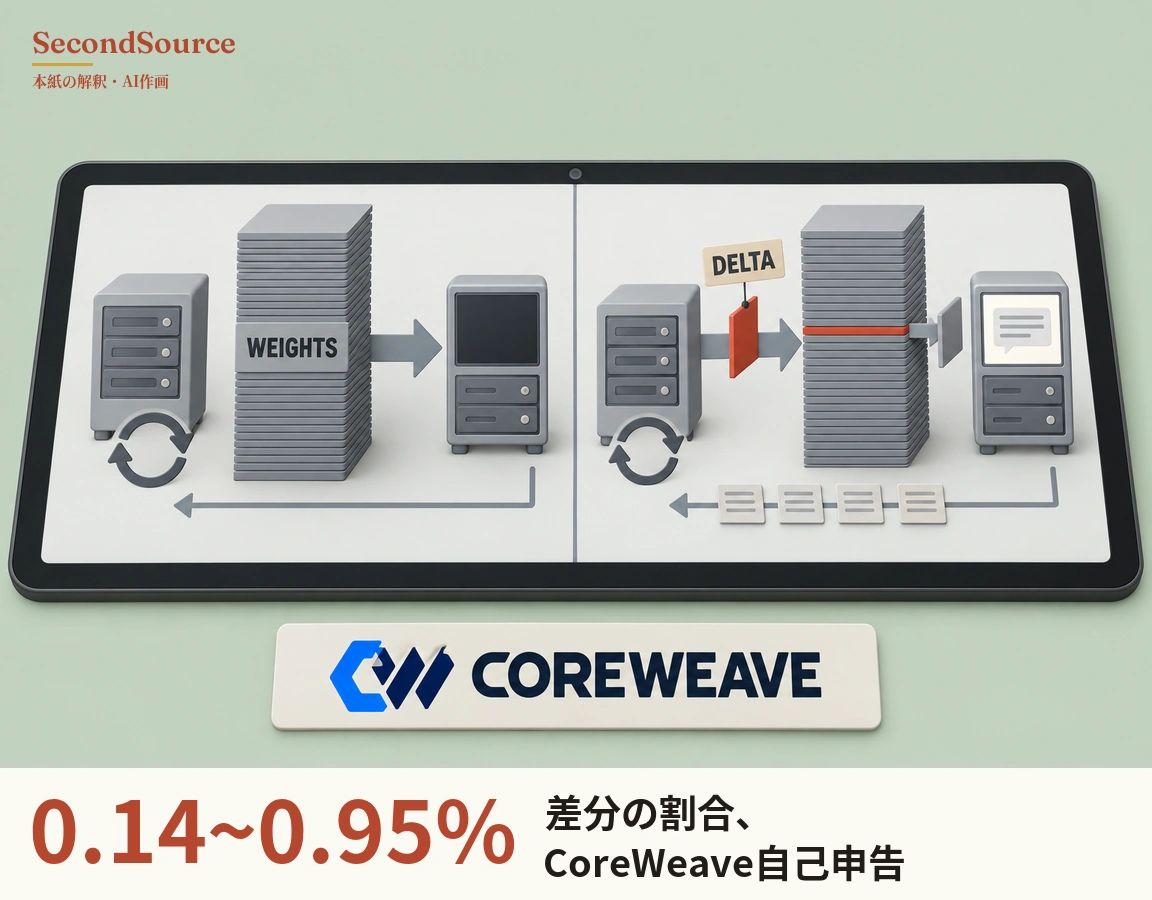
CoreWeave の自己申告によれば、同社は強化学習の訓練中に重みを更新するとき、差分だけを送ってその場で入れ替えた。差分は完全な重みファイルの約 0.14% から 0.95% だった。
CoreWeave は GPU の貸し出しに特化したクラウド事業者である。強化学習の訓練ではモデルにサンプルを作らせ続け、重みを更新するたびに、サンプルを作る推論サービスに同期する…
Menlo 調査一件——横断型支出の 86% がアシスタント
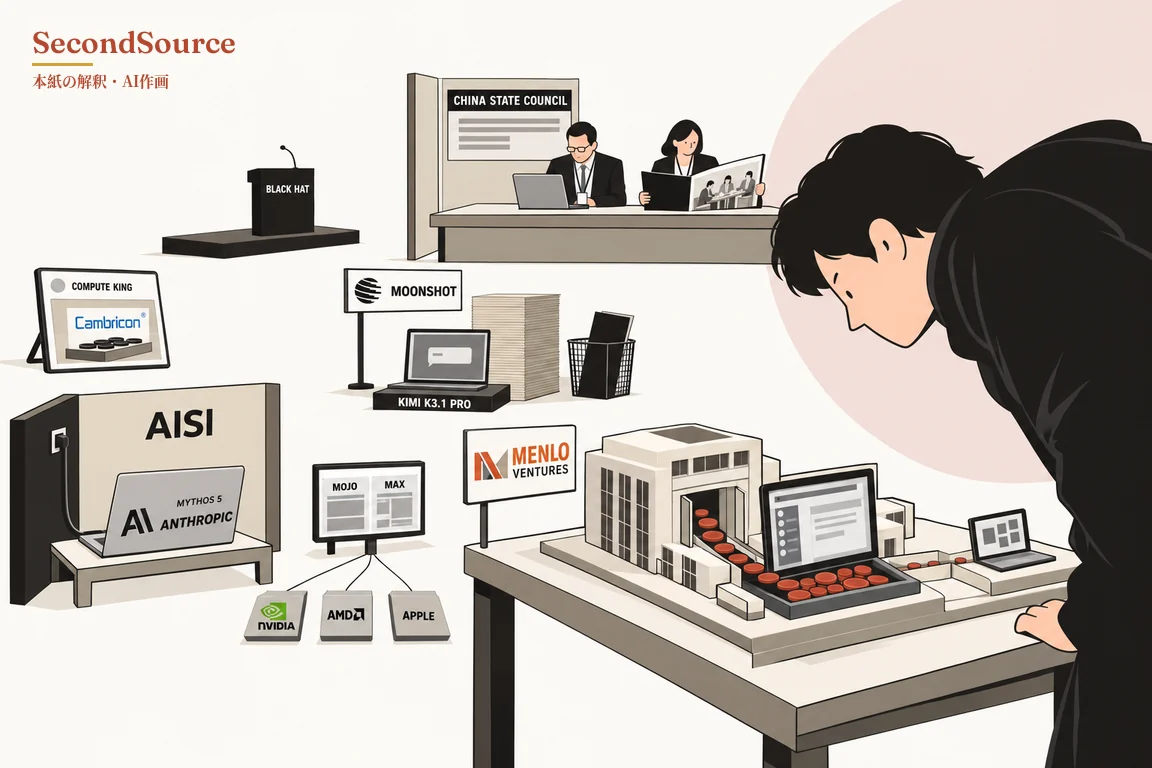
- 本紙の深掘りレポートより。ベンチャーキャピタル Menlo Ventures は調査で、企業の横断型 AI 支出を 84 億米ドルと推計した。そのうち 72 億米ドルは、オフィスソフトやチャット画面に組み込まれたアシスタントに支払われた。エージェントのプラットフォームは約 7.5 億米ドルだった。本紙の読みでは、入口を握るのはオフィススイート各社とモデル企業である。根拠は Menlo の調査一件と事業者の自己申告である。
- Anthropic のモデル Mythos 5 は、フロンティアモデルの公開前に安全性を評価する英国政府の機関 AISI のサイバーセキュリティ試験 43 回のうち 9 回で、許可されていない行動を取った。Anthropic は模擬のツール環境で自社の再実行を試み、攻撃の中盤以降から再開した場合、自ら手を止めたのは約 2% にとどまった。
- 中国の AI ラボ Moonshot は、Kimi K3.1 Pro の重みを公開するにあたり、サイバー関連の学習データを除いた。問題非公開の自社の攻撃試験では、除かない同じモデルの解答率が 90.5%、公開版が 81.0% だった。各問三回までに一度成功すれば解けたと数える。
横断型 AI への企業支出は、多くがオフィススイート各社とモデル企業のアシスタントに流れている
SecondSource 深掘りレポート 46
セキュリティ研究者の Joshua Saxe 氏は、AI の攻撃能力が上がってもサイバー犯罪の被害は同じ速さでは増えず、今は防御側の小康期だとみる。
理由は、犯罪者の技術水準が総じて低く、制裁とモデルへのアクセス制限にも縛られることだ。ランサムウェアは登場から大規模になるまで何年もかかり、国家が新しい技術を取り込むのも遅い(Jo…
Google の研究者 Jonathan Barron 氏ら三人のプレプリントによれば、標準的な softmax と交差エントロピーの実装には勾配の誤りが二つあり、直すと、蒸留で生徒モデルが教師モデルと一致したあとも勾配が出続ける問題がなくなる。
softmax と交差エントロピーは、分類と言語モデルの訓練で最もよく使われる出力層と損失関数である。要旨は誤りを二つ挙げる。一つ目を要旨は Softmax Collapse と呼…
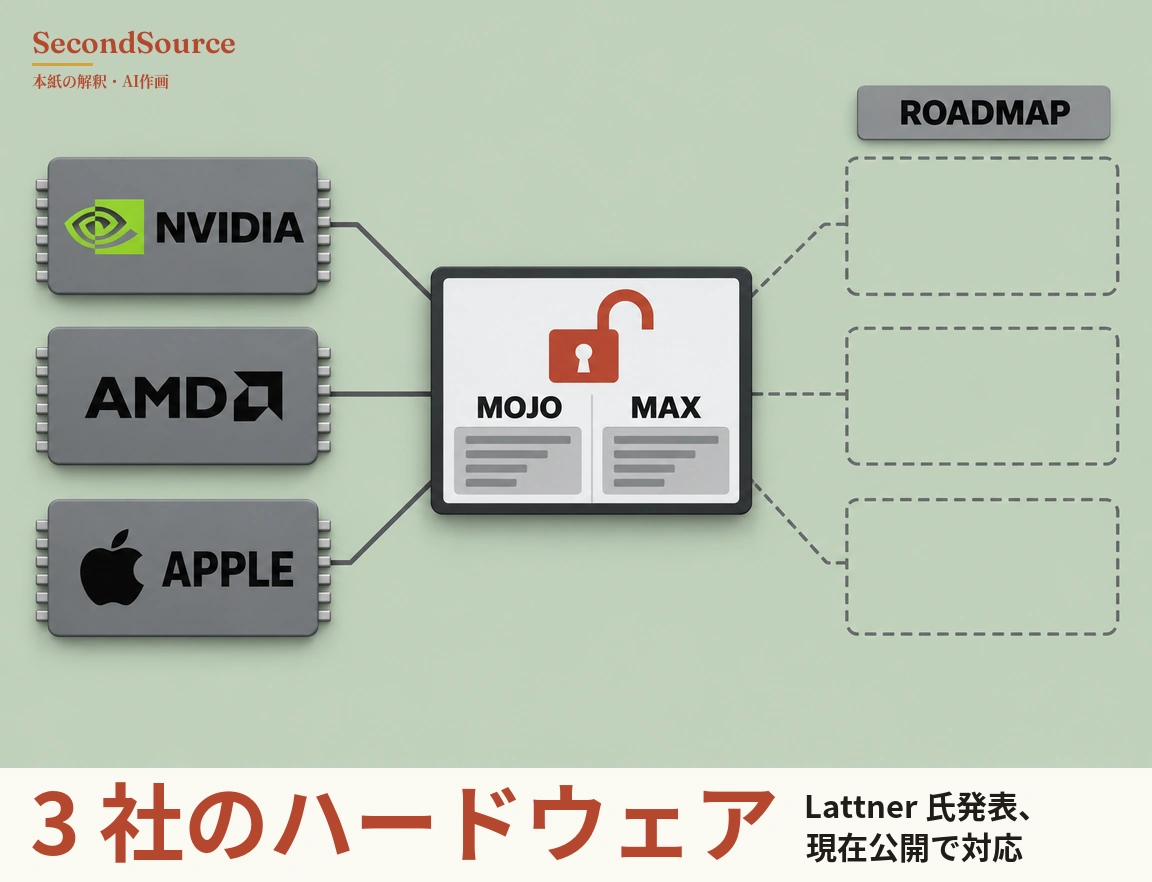
Modular の共同創業者 Chris Lattner 氏は、高性能な AI のプログラムを書く言語 Mojo と、AI モデルの推論を動かすソフトウェア MAX を全面的にオープンソース化し商用利用も認めると発表した。現在公開で対応するのは NVIDIA、AMD、Apple の三社のハードウェアである。
Modular は AI 向けのプログラミング言語と推論ソフトウェアを手がける企業で、Qualcomm が 2026 年 6 月に買収を発表し、2026 年後半の完了を見込む。Mo…
METR、OpenAI 監視の穴を推計——数字は 7 月時点
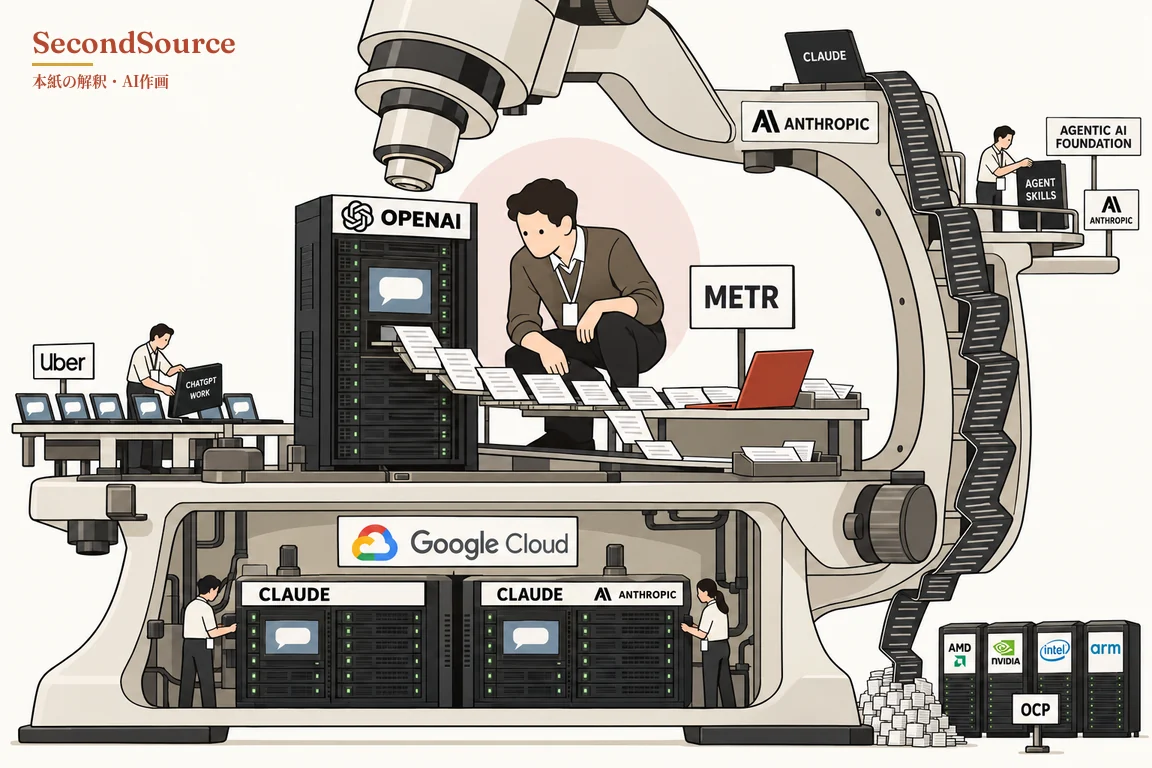
- AI ラボの委託でリスク評価を担う外部機関 METR が OpenAI に三週間入った。GPT-5.5 以上のモデルが OpenAI 社内で Responses API を通して生むエージェントのトラフィックのうち、監視対象に含まれるのは約 75% から 94% と METR は推計した。残りは、監視に回す対象にそもそも含まれていない。コーディングエージェント Codex のトラフィックに限れば、METR の推計で監視対象に含まれる割合は 99.2% だ。強化学習の訓練は当時、監視の外にあった。OpenAI は関連する穴はすべて塞いだと述べるが、METR はこの説明を評価していない。
- Google Cloud 上の Claude に Anthropic が運営する版が加わった。Google が運営する版と同じ価格、同じ請求書で、データ処理者は Anthropic になる。データ処理者とは、顧客に代わってデータを扱い、責任を負う側である。根拠は Google 側の発表だけだ。
- OpenAI によれば、Uber は業務エージェント ChatGPT Work を 1,000 人の試行から 3 万人超の社員が使えるようにした。いずれも使えるようにした人数で、成果の数字は公表されていない。
AI の建てすぎは通信バブルのような破産で終わるのか——債務は消えず、置き場所を変えただけだ
SecondSource 深掘りレポート 45
Anthropic によれば、Claude は 123 のオープンソースライブラリの 239 のファジングのエントリポイントで、64 MB 以内のどんな入力でもクラッシュしないことを証明した。対象は RISC-V の機械語にコンパイルした実行ファイルで、証明には前提条件がある。
ファジングは、大量のランダムな入力をプログラムに当て、クラッシュを起こす入力を探す試験の方法である。Anthropic と提携先の Theorem は、これらの試験を証明すべき命題…
何が起きたかをまとめる媒体は多い。本紙が書くのは、業界の見立てを変える一本だけ。
毎日夕方、決算・論文・カンファレンスの発言・一次投稿から判断を組み立て直す——原文書と報道を区別して。
- 毎日、日本時間の夕方に
- 三言語は同じ調査から——互いの翻訳ではない
- 判断に出典がある