深掘り 2026年10月22日
GPT-6 Astra は推論を書き出す必要が減った。だが OpenAI の保証が測ったのは別の能力だ
SecondSource 深掘りレポート #44
本稿の要点
AI の不正な振る舞いを見つける主な手段は、モデルが答える前に書く推論の下書き、つまり思考の連鎖を読むことだ。この方法が効くのは、難しい問題ではモデルが推論を書き出さざるをえないからである。OpenAI が 9 月に出した最新の旗艦モデル GPT-6 Astra は、下書きを書かずに頭の中で推論する力が大きく跳ね上がった。外部の研究者が測り直して確かめている。OpenAI も、Astra の下書きを読んで問題を見つけるのが難しくなったと測った。外部では、Astra の新しいアーキテクチャが原因ではないかと疑われた。Astra のシステムカードでアーキテクチャに触れた唯一の一文が扱うのは、別の能力である可制御性、つまりモデルが指示どおりに下書きを書き換えられるかどうかだった。可制御性の変化は特にアーキテクチャによるものではない、という内容である。システムカードとは、モデルの公開時に一緒に出す安全性評価の報告書だ。下書きなしの推論がなぜ跳ねたのか、カードは書いていない。Google DeepMind の研究者 Neel Nanda 氏がオープンウェイトモデル 34 個を比べても、二つの能力が一緒に動く様子は見られなかった。
1. まず三つの言葉を分ける——監視可能性、下書きなしの推論、可制御性
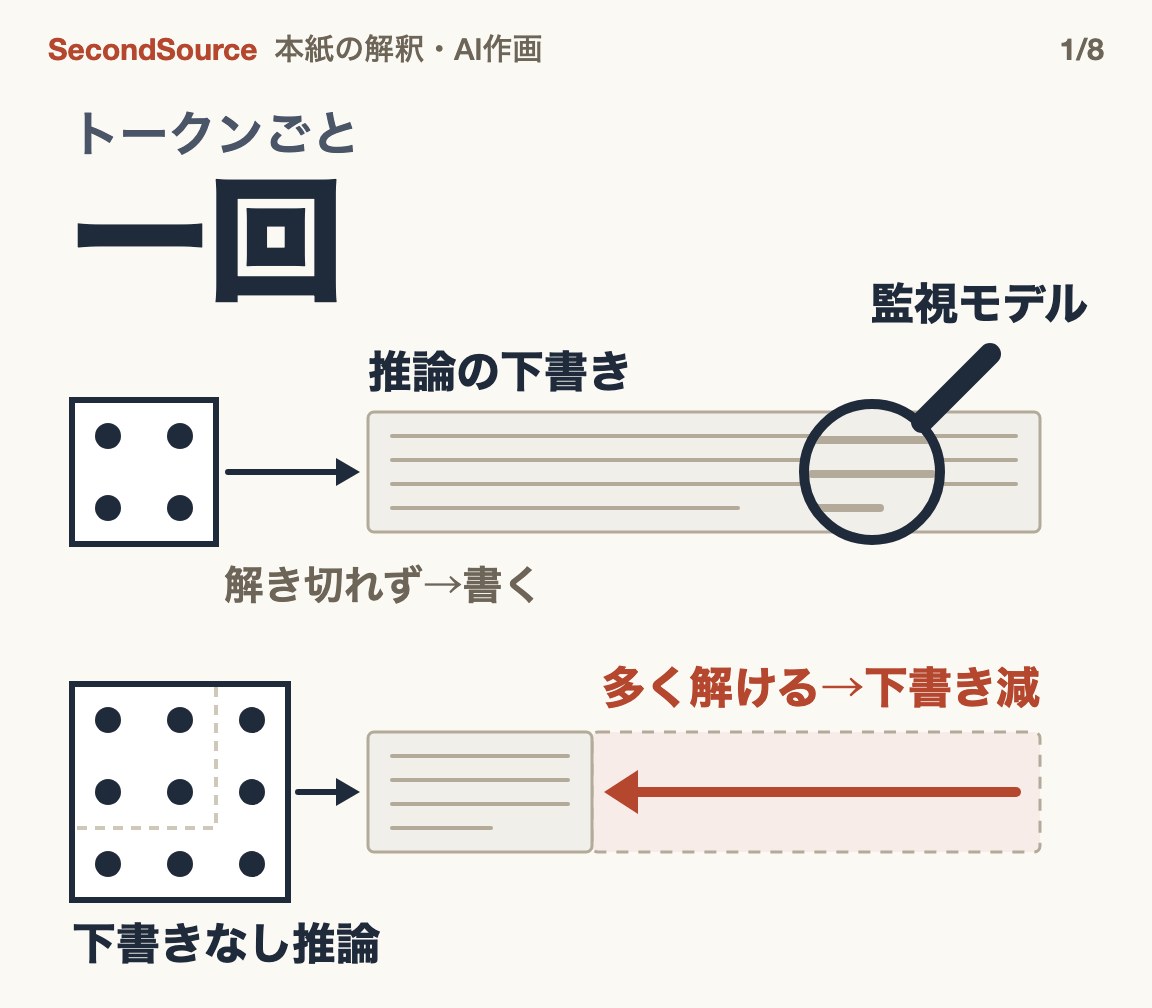
推論モデルは答えを出す前に、人の言葉で推論の過程を書く。研究者はこれを思考の連鎖と呼び、本稿では推論の下書きと呼ぶ。AI の不正を見つける業界の主な手段は、別のモデルにこの下書きを読ませることだ。読む側のモデルを監視役と呼ぶ。下書きを読んでモデルが何をしているか分かるかどうかを、監視可能性という。
この方法が効くのは、技術上の制約があるからだ。モデルは一文字出すごとに一回だけ計算する。この一回をフォワードパスと呼ぶ。一回でつなげる推論の段数には限りがあるので、難しい問題では途中の結果を書き出し、読み返して続きを計算するしかない。暗算できない長い割り算を紙に書くのと同じである。下書きが読めるのは、モデルが見せたいからではなく、書かなければ解けないからだ。
ここから二つの能力が出てくる。一つ目は下書きなしの推論で、研究者は CoT なし推論と呼ぶ。下書きを禁じられたとき、モデルが一回の計算の中でどこまで解けるかである。この能力が強いほど、モデルは推論を書き出さずに済み、監視役が読めるものは減る。しかも、モデルに隠す意図がなくてもそうなる。二つ目は可制御性である。問題の後ろに下書きの書き方の指示、たとえば推論で特定の語を使うなという指示を付け、モデルが従えるかを見る。可制御性が高いとは、求められれば下書きを別の形に書けるということだ。モデルが何かを隠そうとすれば、監視役が読むものは本当の過程とは限らない。OpenAI の 3 月の論文が測ったのは Astra より前のモデルで、従う割合は全般に低かった。そのため、可制御性が当面は監視を無効にしそうにないと判断した。Astra は後から出てきた例外で、従う割合がはっきり高い(第 3 節)。
二つの能力はどちらも監視を弱めるが、その仕方が違う。可制御性は、モデルが求められたときや隠そうとしたときにだけ効く。下書きなしの推論は、強くなるだけで下書きがおのずと短くなる。この二つに監視可能性を加えたものが、第 8 節と第 9 節で言う三つの項目である。
なぜ二つの能力は関係すると考えられたのか。直感的には、どちらもモデルが推論をどれだけ思いどおりに扱えるかの力に見える。一回の計算で多くの段を進めるモデルは、下書きに何を書くかもうまく決められそうだ。OpenAI も、Astra の訓練中に両者が一緒に上がったと述べている。二つが常に一緒に上下するなら、可制御性を測れば下書きなしの推論を測ったことになる。そうでなければ、可制御性だけを扱う保証は、下書きなしの推論について何も答えていない。本稿が答えるのはこの問いである。
2. 主役は OpenAI の最新旗艦 GPT-6 Astra、公式の保証は可制御性だけを扱う
GPT-6 Astra は 9 月 3 日に公開された、OpenAI でいま最も能力の高いモデルだ。同じ日に Astra のシステムカードも公開された。本稿でシステムカードと言えば OpenAI のこの一冊を指す。
カードは、Astra の下書きを読んで問題を見つけるのが前世代の GPT-5.6 Sol より難しいと測った。つまり監視可能性が下がった。同じ日、米フォーチュン誌は、Astra がより効率的な新しいアーキテクチャを使っているとの話を伝え、AI 安全の専門家が推論の見えないモデルへの一歩になると懸念していると報じた。機械学習の書き手 Sebastian Raschka 氏の記事は、うわさされるこの構造をループ型トランスフォーマー(looped transformer)と呼ぶ。同じ計算層の組を次の一文字を出す前に繰り返し使うので、一回の計算で何周も回れる。まさに、下書きなしで多く推論するための道筋である。トランスフォーマーは、いまの大規模モデルの基本となる構造だ。新しいアーキテクチャがループ型トランスフォーマーかどうかは、まだ証明されていない(第 3 節)。Raschka 氏自身は、層の再利用はモデルが意図して隠すものではないと見ている。下書きが減るのは書き出す途中の手順が減るからだ。ただ監視役にとっては、書き出されなかった手順はやはり読めない。これがまさに第 1 節で述べた問題である。
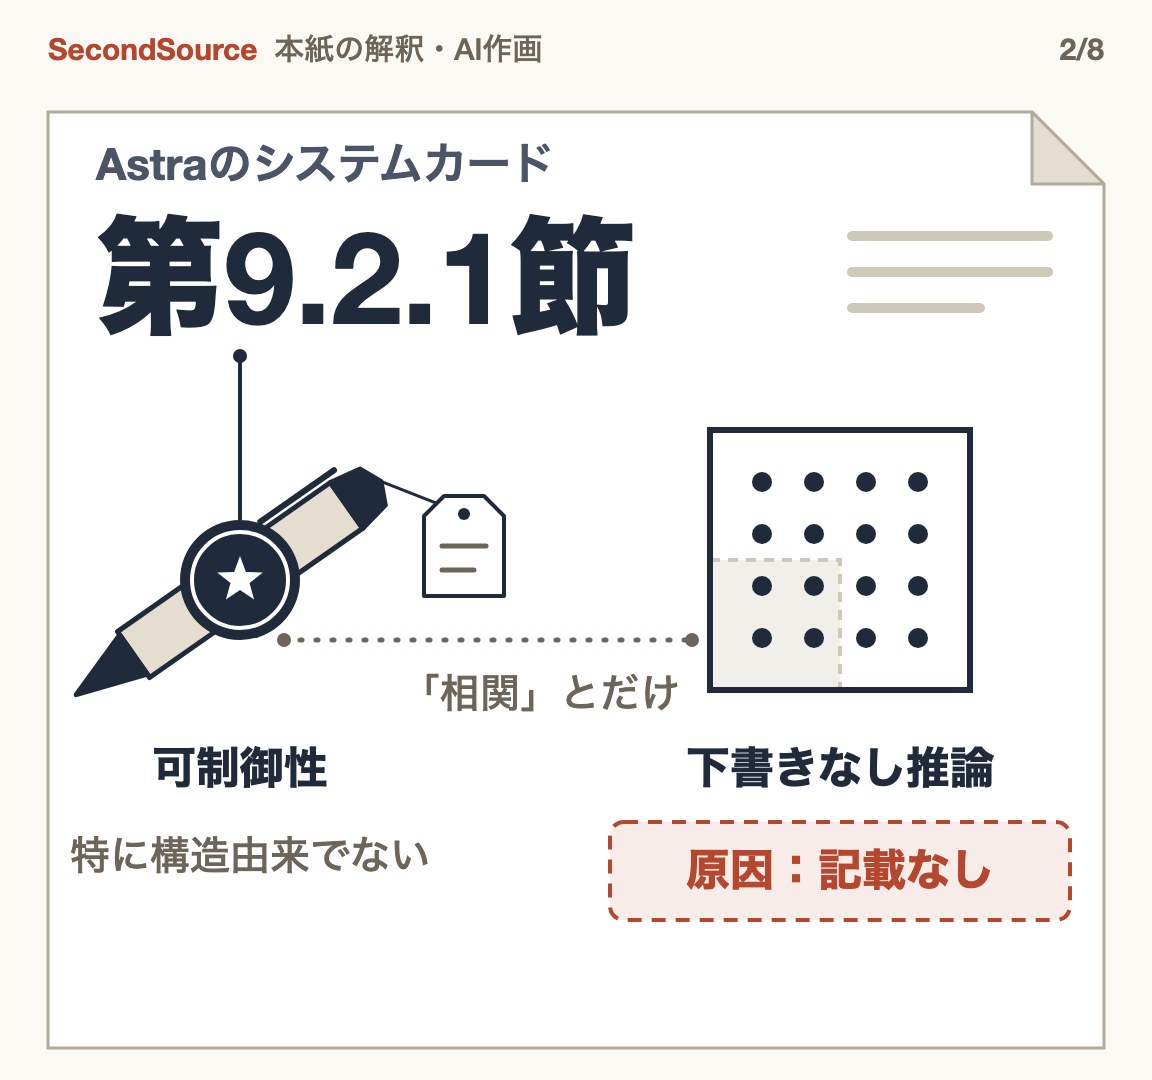
OpenAI の答えは、システムカード 9.2.1 節の段落にある。本稿が「保証」と呼ぶのはこの段落全体である。段落はアーキテクチャに触れており、本誌はこれを、新しいアーキテクチャへの外部の懸念への答えと読む。核となる一文は、可制御性の変化は特にアーキテクチャの変更によるものではないと OpenAI が「かなり確信している」というものだ(英語の原文は付録)。この一文の言い方は、前後の世代でアーキテクチャが変わったことを前提にしている(第 3 節も同じ読み方をとる)。だが何を変えたかは、カードのどこにも書かれていない。「特に…ではない」は原文の differentially にあたり、アーキテクチャが可制御性だけに特に効いたわけではない、という意味である。アーキテクチャがあらゆる能力をまとめて伸ばしたかどうかには、この一文は答えていない(付録)。この段落の文はどれも可制御性について述べている。下書きなしの推論は段落の終わりに出てくるだけで、両者が「相関」しているとしか言わず、原因には触れない。
問いと答えがかみ合っていない。第 1 節の理屈では、下書きなしの推論が強くなれば下書きは短くなり、監視は難しくなる。外部が心配しているのは、この因果の最初の一歩、つまり新しいアーキテクチャが推論を下書きの外へ移すことだ。次の三つの問いについて、カードの説明に本誌の補足を加えるとこうなる。
- 監視はなぜ難しくなったか:主に下書きが短くなったから(第 7 節)。
- 下書きなしの推論はなぜ強くなったか:カードは説明しておらず、アーキテクチャが関わったかどうかも書いていない。
- 可制御性はなぜ変わったか:カードは、特にアーキテクチャによるものではないとする。本誌が第 3 節で集めた手がかりは事後学習を指す。
外部が問うているのは二つ目であり、カードでアーキテクチャに触れた唯一の一文が答えているのは三つ目である。
3. 可制御性は主に事後学習で変わる
大規模モデルの訓練は二段階に分かれる。事前学習では大量の文章を読み、言葉と知識を身につける。事後学習ではその後、人間のフィードバックと強化学習で振る舞いを整える。強化学習とは、うまくできたら報酬を与え、それを何度も繰り返す訓練だ。推論モデルが下書きをどう書くかは、主に事後学習で身につく。
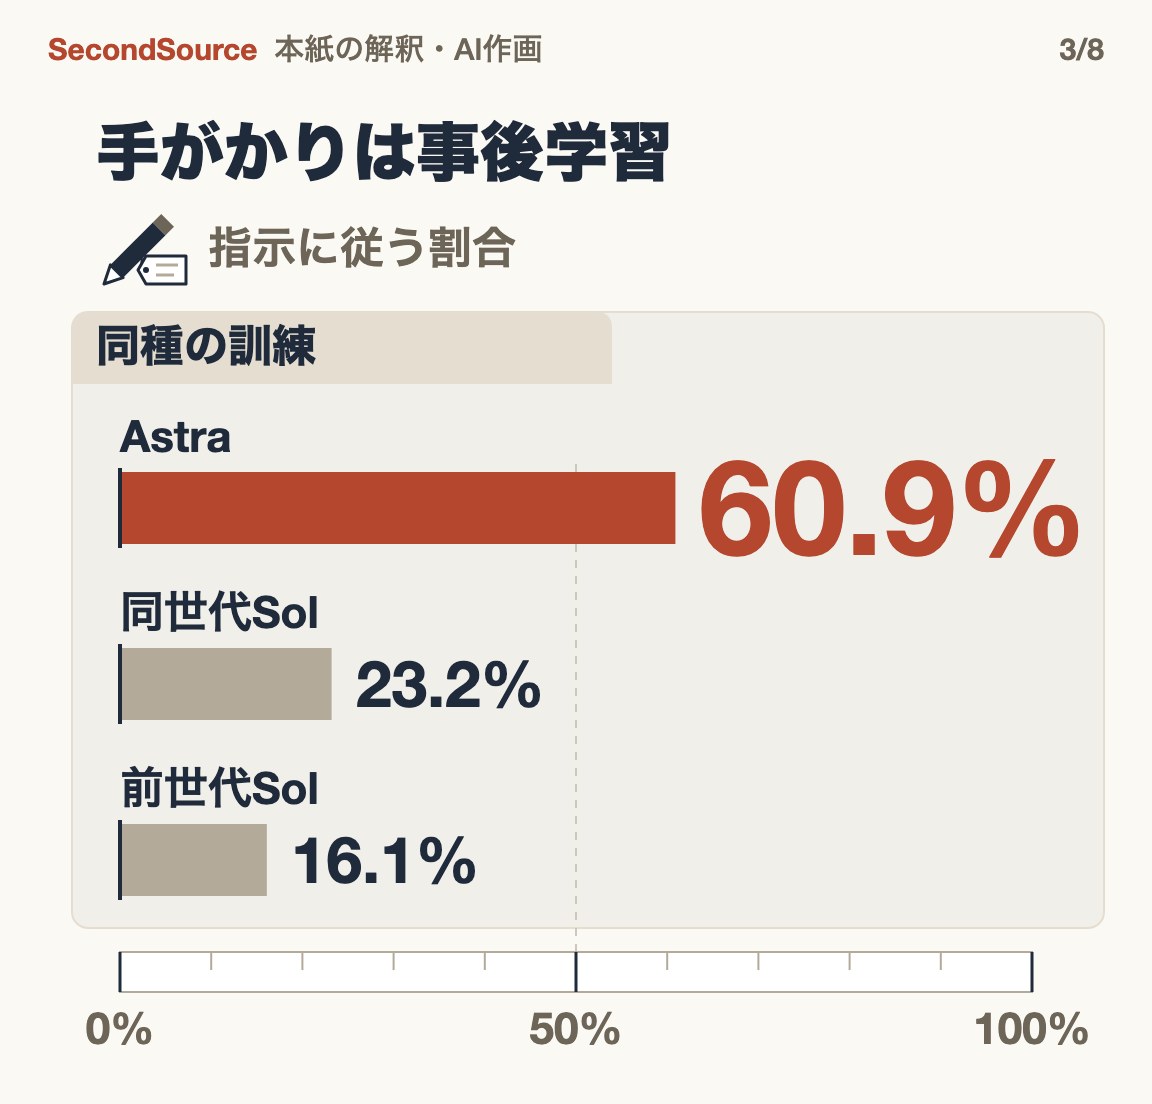
可制御性の手がかりはどれも事後学習を指す。ただしどれも単独では決め手にならない。OpenAI が 3 月に出した可制御性の評価の論文 CoT-Control は、可制御性が「強化学習を重ねるほど下がる」と書いた。6 か月後の Astra のシステムカードは、「以前のモデルと違い」、可制御性が強化学習の訓練中に上がったと書く。同じ評価で、向きが逆である。9 月 22 日には、カードの付録に同世代の小型モデル GPT-6 Sol が加わり、「Astra と同じ種類のデータと訓練を使った」と明記された。下書きの長さが 750〜1,250 トークンの区間(トークンはモデルが文章を扱う最小単位)で、指示どおりに下書きを書き換えた割合は、Astra が 60.9%、GPT-6 Sol が 23.2%、前世代の GPT-5.6 Sol が 16.1% だった。
同じ種類の訓練でも細部が同じとは限らない。これほどの差は「事後学習の細部が違えば可制御性も違う」という見方に合う。二つのモデルの訓練が具体的にどう違うかを OpenAI は書いていない。どれも決め手ではない。前後の世代の間でアーキテクチャも変わり、GPT-6 Sol は規模が小さくアーキテクチャも開示されていないので、差はそこから来ている可能性もある。
下書きなしの推論がどの段階で、なぜ強くなったのかは、まだ誰も示していない。ループ型アーキテクチャ説について、Nanda 氏は「証明されていない」と明記している。
4. 研究の五つの流れ
1. 監視可能性を測る:下書きを読んで問題を捕まえられるか。OpenAI はシステムカードで五つの評価を使って Astra を測った。
2. 可制御性を測る:問題に下書きについての指示を付け、モデルが従うかを見る。OpenAI が 3 月に出した CoT-Control 論文がこれに当たる。
3. 下書きなしでどこまで解けるかを測る:Nanda 氏、英国政府の AI 安全研究所、AI 安全の議論の場 LessWrong の何人かの書き手が、それぞれ問題を作って Astra を測った。
4. 下書きが短くなる代償:小型モデルに短い下書きを強いて、監視がまだ効くかを調べる(第 7 節)。
5. アーキテクチャをめぐる論争:同じ計算層を繰り返し使うと、推論が下書きの外に隠れるのか。機械学習の書き手 Sebastian Raschka 氏は、層の再利用そのものは下書きを隠さないと論じる。
5. 34 のモデルで比べると、下書きなしの推論が強いモデルでも可制御性が高いとは限らない
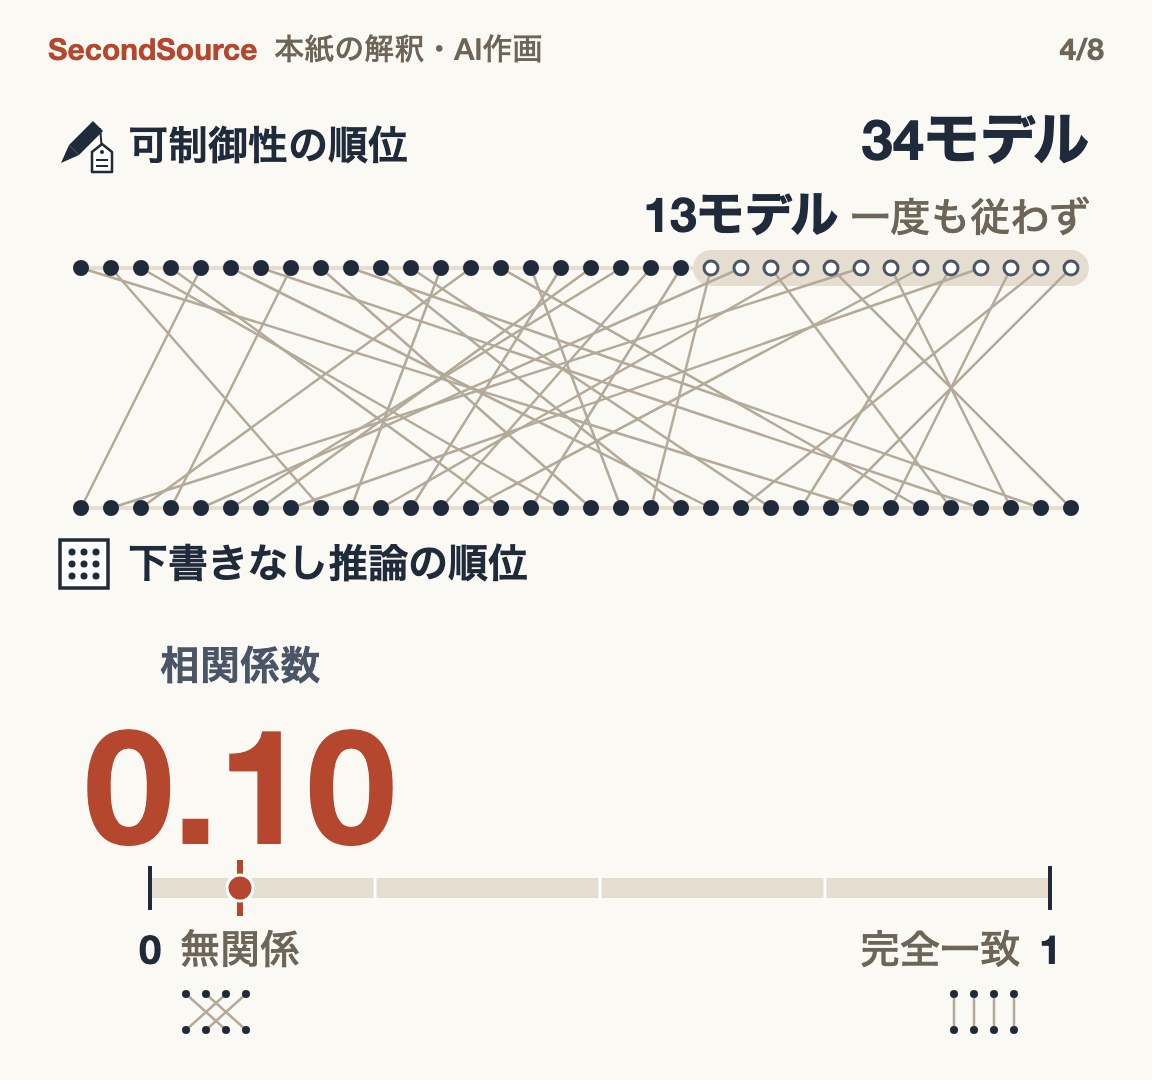
9 月 10 日、Nanda 氏は個人の立場で、CoT-Control を 34 のオープンウェイト推論モデルに当てた。オープンウェイトとは、モデルのファイルが公開されてダウンロードでき、下書きの全文を読めるモデルを指す。各モデルに 108 問を解かせ、Nanda 氏が自作した下書きなし推論の指数と突き合わせた。指数が高いほど、下書きなしで正しく解ける問題が多い。
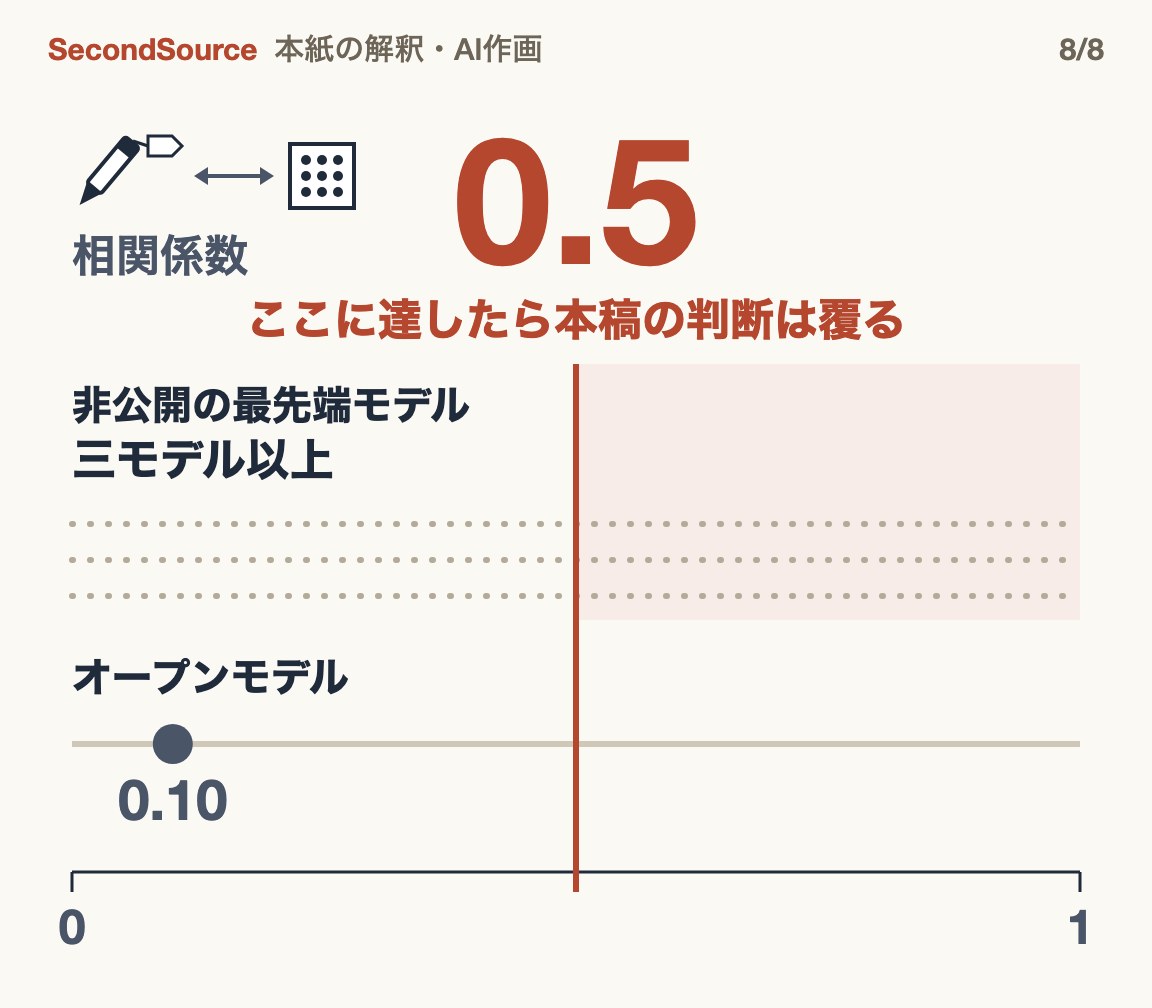
Nanda 氏は 34 のモデルを二つの能力でそれぞれ順位付けし、二つの順位がどれだけ似ているかを見た。この数を相関係数と呼び、1 なら完全に同じ、0 ならまったく無関係である。結果は 0.10 で、ほぼ無関係だった。
これは、両者が一緒に上がったという OpenAI の説明と矛盾しない。OpenAI が見たのは、一つの会社が同じ訓練のやり方で追いかけた推移だ。Nanda 氏が比べたのは、同じ時点の各社のモデルである。同じ塾の中なら、授業を多く取る生徒ほど数学と作文が一緒に伸びることはある。だが別々の塾の生徒を並べると、教え方が違うので、二科目の点数は連動するとは限らない。Nanda 氏の説明もまさにこれで、可制御性は「事後学習の細部に強く左右される」という。
限界は Nanda 氏自身が先に書いている。34 のうち 13 のモデルは一度も指示に従わず、全体で従った割合は 3% 未満だった。13 のモデルが最下位で並ぶので、相関係数は正確に出せない。そこで本稿は最も慎重な読み方だけを採る。このモデル群では、二つが一緒に動く様子は見られない。0.10 は正確な値として扱わない。
もう一つ穴がある。これらのオープンモデルが従った割合は 3% 未満だが、OpenAI のモデルは第 3 節の長さの区間で 16% から 61% だ。測り方が違うので、比べられるのは桁の違いだけである。この結論が Astra のようなモデルに当てはまるかは、重みが公開されていないフロンティアモデルで誰かが測るまで分からない(覆す条件の 2)。
6. Astra は下書きなしでどこまで解けるか——外部の測り直しで跳躍を確認
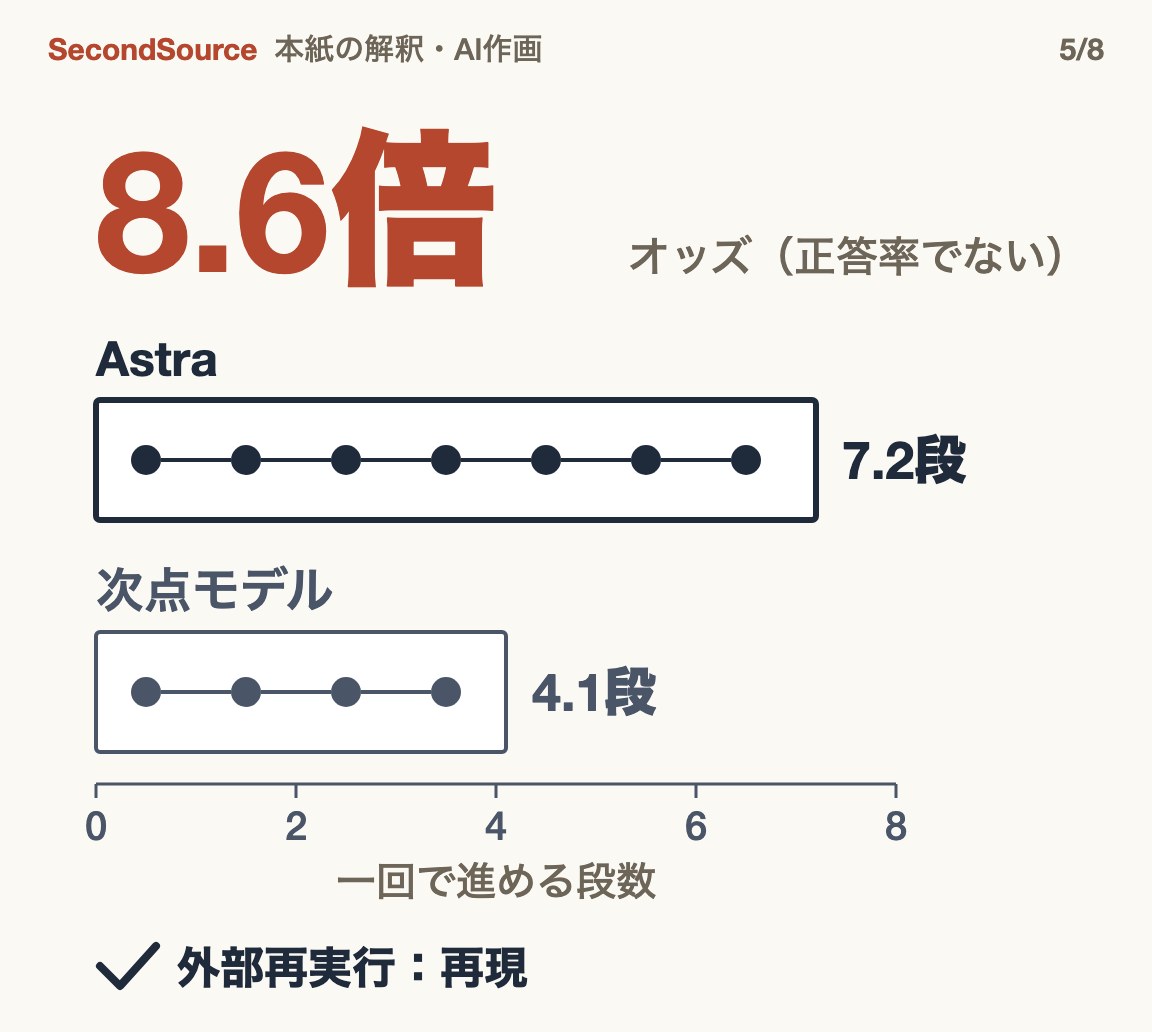
Nanda 氏は当初、英国 AI 安全研究所が測った跳躍を疑っていた。自作の問題集で測り直した結果は、「残念ながら、再現した」だった。
数字は三つある。一つ目に、Astra が下書きなしで推論問題を解くオッズは、次点の Anthropic の Claude Fable 5.1 の約 8.6 倍である。オッズは成功の回数と失敗の回数の比なので、正答率が 8.6 倍という意味ではない。二つ目に、一回の計算でつなげる前後依存の算術の段数は、Astra が約 7.2 段、次点が 4.1 段だった。三つ目に、強みは特定の種類の問題に偏っている。計算を次々につなげる問題や、いくつかの計算を同時にこなす人工的な問題では、Astra のオッズはほかの種類の問題の約 16 倍になる。Nanda 氏の換算で、算出方法は付録にある。これこそ、下書きを書く代わりになる種類の力である。
限界:英国 AI 安全研究所の元の資料は公開版が見当たらない。
7. 同じ結果に二つの書き方——システムカードは監視が難しくなった理由、企業向け発表文は安くなる理由
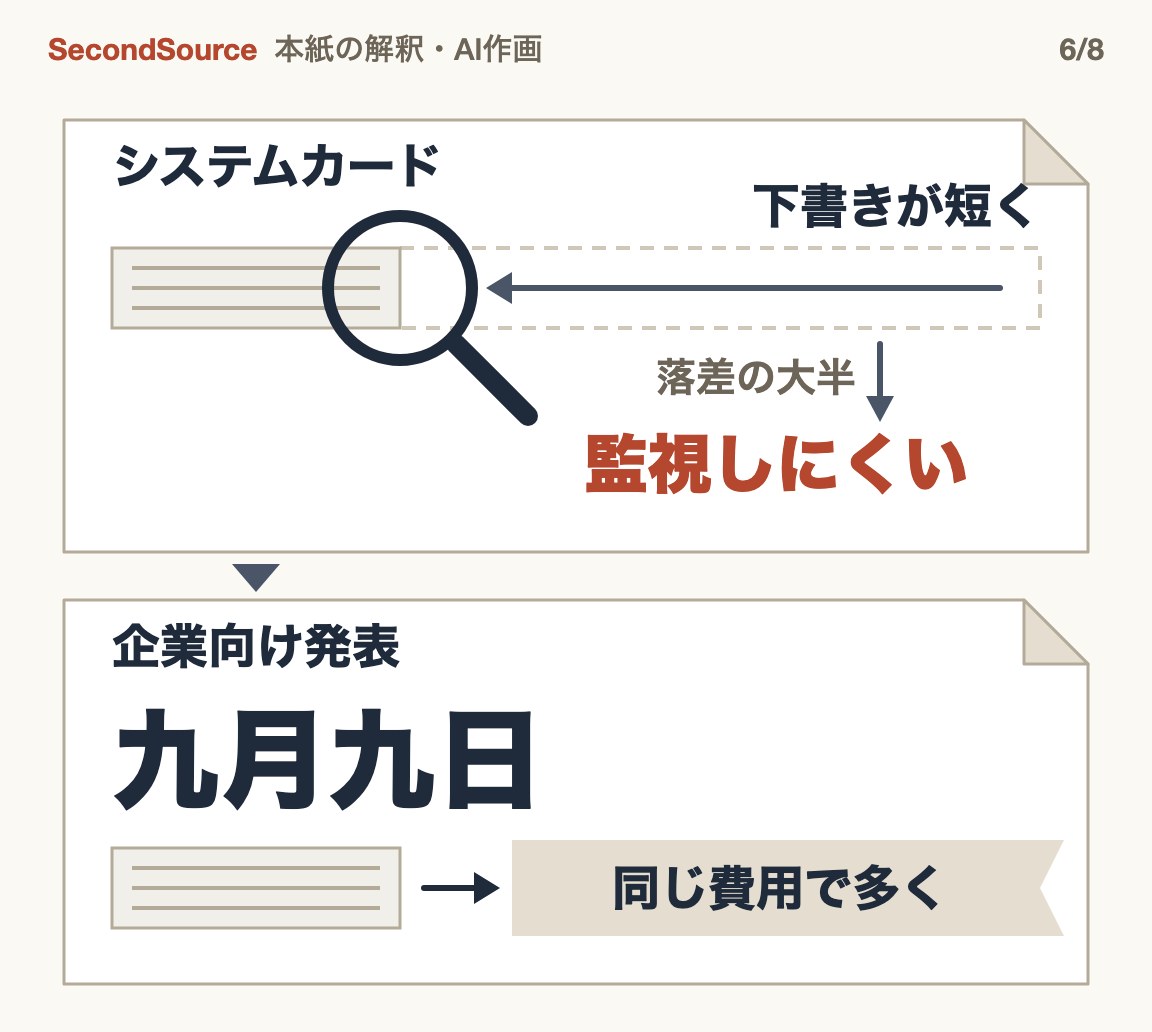
9 月 3 日のシステムカードは仕組みを書いている。"most of the aggregate gap in CoT monitorability comes from GPT-6 Astra producing shorter CoTs" で、短い下書きは監視役が必要とする証拠を省いたり弱めたりしがちだという。
9 月 9 日、OpenAI の企業顧客向けの発表文は Astra を "more useful work per dollar" と売り込んだ。Astra が "trained to complete tasks in fewer tokens with fewer retries" だからだという。推論の下書きもトークンで書かれる。システムカードは別の箇所で、推論トークンの上限を同じにしても、上限をどう設定しても Astra は前世代より使う量が少なかったと測っている(付録)。本誌は二つの文書を並べて読んだ。同じ結果が、システムカードでは監視が難しくなった理由として、企業向け発表文ではコストが下がる理由として書かれている。二つを並べて書いた OpenAI の文書はない。
反対の証拠もある。シェフィールド大学などの 10 月の論文は、小型モデルに短い下書きを強いても監視可能性は比較的保たれたと報告した(付録)。下書きが短くなれば必ず監視が難しくなるわけではない。本誌は Astra についてのシステムカードの説明を採るが、それを一般則にはしない。
8. この保証を外部の人は確かめられるか
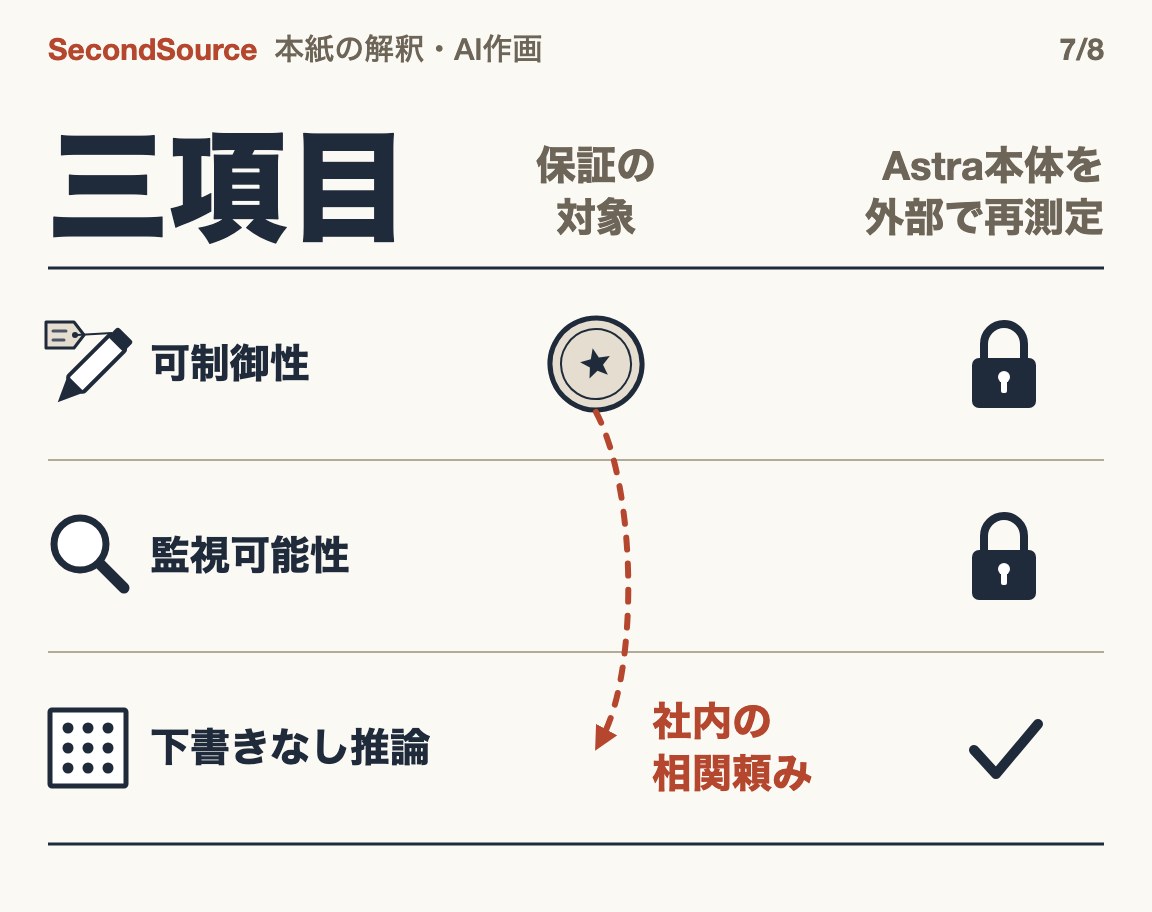
第 1 節の三つの項目について、誰が測ったか、外部の人が測り直せるか:
| 能力または指標 | 誰が測ったか | 外部の人が測り直せるか |
|---|---|---|
| 可制御性 | OpenAI。英国 AI 安全研究所も招かれて測った | Astra 自体:できない。測ったのは OpenAI と研究所だけ。方法:できる。問題は公開されており、オープンウェイトモデルなら誰でも測り直せる |
| 監視可能性 | OpenAI だけが自社の方法で測った | できない。招かれた研究所でさえ、この項目についてはブログで結果の参照先をシステムカードとしている |
| 下書きなしの推論 | OpenAI と研究所の数字はシステムカードの中にある。Nanda 氏は独自に Astra を測った | できる。第 6 節の測り直しがそれに当たる。測ったグループはいくつかあるが、コードとデータを公開したのは Nanda 氏だけ |
保証が扱うのは可制御性だ。外部の人もオープンウェイトモデルでこの方法を測り直せるが、Astra 自体の点数も、変化は特にアーキテクチャによるものではないという原因の判断も、外部からは確かめられない。この保証を下書きなしの推論にまで広げるには、両者が一緒に上がったという OpenAI 社内の相関に頼るしかない。その相関には、公開された数字も方法もない。
9. これは誰にとって何を意味するか
- 企業システムを操作する AI を導入する企業:「より少ないトークンで仕事を終える」には二つの面がある。請求額は下がるが、事後の監査に使える下書きも短くなる。ベンダー向け質問票に「思考の連鎖の監視」という欄が一つしかなければ、三つの項目が一つに混ざってしまう。
- 調達条項と規制の起草者: 条項をアーキテクチャに結びつけると空振りに終わる。測れる結果に結びつけて初めて効く。測れる結果とは、監視役を避けるよう指示されたときの再現率と、下書きなしの推論について外部で比較できる数字である。再現率とは、本当に問題のある事例のうち監視役が捕まえた割合だ。この数字はシステムカードにあるが、測ったのは OpenAI だけである(付録)。
本誌の見立て
AI 企業の安全性の保証を読むときは、まず二つを問う。保証が扱うのはどの項目か。外部の人がそれを測り直せるか。
これから見るべき数字
OpenAI の次のフロンティアモデル(最も能力の高い層)のシステムカードが三つの項目に別々の数字を出すかどうか、そして GPT-6 Sol のアーキテクチャが開示されるかどうかである。
この判断を覆す条件
観察期間はいずれも 2027 年 3 月 31 日までとする。条件の 1 は、それより前に新しいシステムカードが出れば、公開後 14 日を基準とする。
1. OpenAI の次のフロンティアモデルのシステムカード公開から 14 日以内(フロンティアモデルの判定基準は付録の算出範囲の注記):カードが下書きなしの推論の変化について、原因やアーキテクチャへの帰属を示せば、この項目が別に説明され始めたことになり、「保証は可制御性しか扱っていない」という本稿の判断は無効になる。
2. 2027 年 3 月 31 日まで:第三者(たとえば招かれた評価機関)が、重みが公開されていない少なくとも三つのフロンティアモデルで、本物の下書きを使って両者の相関係数 0.5 以上を測れば、「二つの能力は別物だ」という判断は無効になる。
3. 2027 年 3 月 31 日まで:OpenAI が Astra の訓練過程での両者の相関の数字と方法を公開し、相関が事後学習ではなくアーキテクチャから来ていれば、第 3 節を書き直す。
付録:数字の出どころ
各数字の出典
| 数字 | 何を測ったか | 誰が測ったか | どこで |
|---|---|---|---|
| 0.10 | 可制御性と CoT なし推論指数のスピアマン相関、34 のオープンウェイトモデル | Neel Nanda | Alignment Forum の投稿の付録、2026-09-10 |
| 13/34、<3% | 一度も指示に従わなかったモデルの数、全体の遵守率 | 同上 | 同上 |
| 6–13%、11%、0 | GLM-5 シリーズ、DeepSeek の一モデル、Qwen 3.5 各サイズの可制御性 | 同上 | 同上 |
| 8.6 倍、7.2 対 4.1 段、40 ポイント(16 倍) | CoT なし推論のオッズ、一回のフォワードパスでの直列の段数、合成課題での偏り | 同上 | 同上の本文 |
| 60.9%、16.1%、1.7%、23.2% | 750–1,250 トークンの区間で思考の連鎖への指示に従った割合:Astra、GPT-5.6 Sol、GPT-5.5 Thinking、GPT-6 Sol | OpenAI | システムカード §9.2.1 と付録 11.7.1.1(09-22 追加) |
| 93%、48% | 制約に従ったサンプルの割合:Astra、GPT-5.6 Sol | 英国 AI 安全研究所(カード内) | システムカードの UK AISI の節 |
| <11%、0 | 回避を指示された条件で思考の連鎖だけを読む監視役の再現率:WMDP、Monorepo-Bench | OpenAI | システムカード §9.2.2 |
| ~10%→~50%、15–40 分、10 対 35 ポイント | filler token を使った四段の事実推論、CoT なしで半分をこなせる作業の長さ、思考モードの有無による差 | LessWrong の三組の著者、Zvi 氏がまとめた | Zvi 2026-09-12 |
| 2.7%、61.9% | Claude Sonnet 4.5 が思考の連鎖を制御できた割合と、最終出力を制御できた割合 | OpenAI など | arXiv 2603.05706 の要旨 |
第 2 節の引用の原文
システムカード 9.2.1 節:"We are also quite confident that changes in CoT controllability are not differentially due to any architectural changes."
第 5 節の研究所ごとの詳細
オープンウェイトモデルのうち少しでもできるものは、研究所ごとに固まっている。Z.AI の GLM-5 シリーズは 6% から 13%、DeepSeek の一モデルは 11% だった。Alibaba の Qwen 3.5 は 9B から 397B まで、どのサイズもゼロだった。
Qwen 3.5 は 9B から 397B まで各サイズとも可制御性がゼロで、総パラメータ数の差は約 44 倍ある。本誌の推論はここまでにとどめる。同じ会社の中では、規模が大きくなっても可制御性は生まれなかった。各サイズの CoT なし指数は個別の数字が見当たらないので、これはまだ事後学習仮説への反例ではない。
第 6 節の数字の補足
一回のフォワードパスでこなせる直列の算術の段数は、Astra が約 7.2 段、次点が 4.1 段だった。途中の過程を書かずに、前後が依存し合う算術を何段まで連ねられるかという数字である。合成した直列・並列演算の課題での Astra の CoT なし指数は、ほかの課題より約 40 ポイント高い。Nanda 氏はこれをオッズに換算し、約 16 倍としている。
第 8 節の可制御性の第三者の数字
英国 AI 安全研究所はカードの中で、制約に従った割合を Astra で 93%、GPT-5.6 Sol で 48% と測った。この数字は第 3 節の 60.9%、16.1% と算出の範囲が違う。長さの区間と問題集は開示されていない。
そのほかの外部の三組の数字
Zvi Mowshowitz 氏は 9 月 12 日、LessWrong の三つの投稿をまとめた。プロンプトに意味のない文字を詰めてすぐに答えさせると、Astra の四段の事実推論は約 10% から約 50% に上がった。二人の研究者は、Astra が思考の連鎖を書かずに半分をこなせる作業の長さを 15〜40 分と見積もった。二人の以前の予測の中央値は、2028 年末まで 7 分を超えないというものだった。思考モードを切ると、Astra は 10 ポイントしか下がらず、Fable 5.1 は 35 ポイント下がった。三組の数字はいずれも投稿の自己申告で、Zvi 氏の転記による。元の投稿との照合は経ていない。
第 7 節の反対の証拠
システムカードの五つの監視可能性評価のうち、下書きの長さをそろえて比べると三つでは差が縮まった。二つではなお劣っており、下書きの中身そのものにも証拠が少ないことを示す。これが「大半であって、すべてではない」の根拠である。
システムカードはさらに、同じ推論トークンの上限を与えると、どの設定でも Astra が実際に使った量は GPT-5.6 Sol より少なかったと書いている。
シェフィールド大学などの 10 月 2 日の論文(arXiv 2610.03509)は、長さを縮める圧力を三つの方法でかけてオープンウェイトモデルを微調整した。生成予算の固定、事例ごとの長さ目標、グループ相対の長さ報酬の三つである。忠実性は多くの設定で下がり、主な原因は訓練後にモデルの一貫性が落ちたことだった。監視可能性は比較的頑健で、思考の連鎖が大幅に短くなっても、モデルは介入が答えに影響したことを認めた。対象は小型モデルで、介入の検出という指標を使っており、OpenAI のシステムカードの指標とは違う。以上は論文の要旨にもとづく。
本誌が追うトレンドライン
進行中 ?
本稿はこのトレンドラインのどこにあるか: このラインが追っているのは、モデルの推論がまだ読めるか、誰が検証するかである。本稿は上の樹の「支える物差しの交代」の節に続き、問いを一つ加える。検証に使う物差しが、結論を本当に支えている量を測っているかどうかだ。このラインの元の判断は変わらない。
本誌が計算した数字
- CoT-Control 論文の傾向の一文の全体:"We also find that CoT controllability is higher for larger models and decreases with more RL training, test-time compute, and increased problem difficulty." 同論文は、可制御性が "currently unlikely to be a failure mode of CoT monitorability" だと判断した。可制御性の分布について Nanda 氏が書いた評は "It's a mess." である。
- 約 44 倍:Qwen 3.5 の最大と最小のサイズの総パラメータ数の比で、397B を 9B で割った値。同じ会社の中で規模の差が大きいのに可制御性がすべてゼロだったことを示すためだけに使う。各サイズの CoT なし指数は個別の数字が見当たらない。
- 7 ポイント上昇、45 ポイント上昇:GPT-6 Sol の 23.2% から GPT-5.6 Sol の 16.1% を引いた値と、Astra の 60.9% から 16.1% を引いた値。同じ長さの区間で、カード内の数字をそのまま引いた。
算出範囲の注記
- 可制御性の数字はすべて一つの長さの区間(750–1,250 トークン)から取っており、カードは全長での集計値を示していない。英国 AI 安全研究所の 93%、48% は、長さの区間と問題集が開示されていない。
- システムカードは監視可能性の差の「大半」が短い思考の連鎖によると書くが、割合は示していない。「より少ない推論トークン」にも百分率はない。企業向け発表文の「タスクあたりのコストが 9% と 63% 低い」は、他社と比べた自己申告のコスト推計で、トークン数ではない。
- 外部の三組の数字(filler token、作業の長さ、思考モードの切り替え)は Zvi 氏の転記によるもので、元の投稿との照合は経ていない。
- 覆す条件の 1 のフロンティアモデルとは、OpenAI が危険度を評価する枠組み Preparedness のいずれかの領域で High 以上とされたモデルを指す。
- Korbak 氏の「数世代の間で強く相関」の一文は、Zvi 氏が 9 月 8 日にツイートへのリンク付きで転記したもので、原ツイートとの照合は経ていない。システムカードは 9 月 22 日と 29 日に二度更新されたが、どちらも 9.2.1 節のこの段落を変えていない。
別の見方(併記し、本文には入れない)
- カードの外での当事者のより広い否定:OpenAI のアラインメント研究者 Tomek Korbak 氏は 9 月 3 日、X に、監視可能性の低下は知能の跳躍によるもので、思考の連鎖への直接の最適化圧力でもアーキテクチャ変更でもないと書いた。この一文は監視可能性全体に及ぶが、書かれた場所はツイートで、システムカードではない。ニュースレター Don't Worry About the Vase を書く Zvi Mowshowitz 氏が 9 月 8 日に転記したもので、原ツイートとの照合は経ていない。
- 「differentially」のもう一つの読み方:Nanda 氏の指摘では、ループ化は事前学習を改善し、事前学習がよくなればもともとすべての能力が一緒に伸びる。そのため「ループが特別に引き起こしたものではない」という言い方は、正直でありながら情報を含まないこともありうる。本稿は二つの読み方を両方残す。
- アーキテクチャ無罪説:Sebastian Raschka 氏は 9 月、層の再利用そのものは思考の連鎖を隠さないと指摘した。目に見える推論の痕跡が減ったのは、出力する必要のある中間トークンが減ったからだという。第 7 節の「差の大半は短くなった思考の連鎖による」と同じ向きだが、なぜ減ったかには答えていない。
- システムカードのその後の更新:9 月 22 日に HealthBench の設定ミスを修正し、GPT-6 Sol と Luna の付録を追加した。9 月 29 日には、Astra で動く常駐 AI アシスタント dots の付録を追加した。どちらの更新も 9.2.1 節のこの段落を変えていない。
- 自己指示で可制御性は上がる:arXiv 2610.23257(10 月 16 日)は、制約をユーザーのプロンプトではなくモデル自身の思考の連鎖の中に自己指示として置くと、可制御性が大きく上がると主張する。監視役の回避に使えることも示した。この結果に従えば、「オープンウェイトの可制御性はほぼゼロ」という数字は低めに出ていることになる。ただし研究所ごとに固まるという形は変わらない。
本記事は日本語版・英語版・中国語版と同一の調査と判断にもとづいて書かれています。
出典にはリンクを付け、原文書と報道を区別し、確かめられなかった点を明記しています。
ご意見・ご感想は ops@secondsource.io までお寄せください。
この記事が依拠した出典
以下は、この記事が引いた事実の記録から機械的にまとめた出典で、各行はそのうち一つの事実の出どころである。
- Alignment Forum — Neel Nanda · 2026-09-10:Astra can do a concerning amount with no chain of thought
- OpenAI · 2026-09-03:GPT-6 Astra System Card
- Don't Worry About the Vase · 2026-09-08:Astra Is Hard to Monitor
- OpenAI · 2026-09-09:GPT-6 Astra: The next generation in intelligence for work
- Ahead of AI · 2026-09-09:GPT-6 Astra, Looped Transformers, and Hidden Reasoning
- Tomek Korbak · 2026-09-03:x.com/tomekkorbak/status/2095596839886274689
- Fortune · 2026-09-03:AI experts worry OpenAI's Astra model may be a dangerous step toward models with opaque reasoning
- Rauno Arike · 2026-09-03:How concerned should we be about Astra's recurrent architecture?
- Don't Worry About the Vase · 2026-09-12:thezvi.substack.com/p/gpt-6-astra-can-do-ambitious-things
- arXiv:Monitoring Monitorability
- OpenAI Blog:openai.com/news/
- arXiv · 2026-10-02:Efficient Reasoning Training Does Not Always Harm CoT Faithfulness and Monitorability
他言語版が引いた出典
以下の出典は、この記事の他言語版の本文ではリンクされているが、この版の本文にはないため、ここに補う。