深度 深度專欄 #44 · 2026年10月22日
GPT-6 Astra 越來越不必把推理寫出來,OpenAI 的保證量的卻是另一件事
本篇重點
AI 安全界抓模型做壞事,主要靠讀模型答題前寫下的推理草稿,也就是思維鏈;前提是模型碰到難題非寫出來不可。OpenAI 九月推出的最新旗艦 GPT-6 Astra,不寫草稿也能推理的能力大幅躍升,外部重跑確認;OpenAI 也量到,讀 Astra 的草稿抓問題變難了。外界懷疑是 Astra 的新架構造成的。Astra 的系統卡(發布模型時一起公開的安全評估報告)裡唯一談架構的一句,談的卻是另一種能力「可控性」,也就是模型能不能照指令改寫草稿:可控性的變化並非特別由架構造成。不寫草稿的推理為什麼躍升,系統卡沒有說;Google DeepMind 研究員 Neel Nanda 比了 34 個開放模型,也看不出這兩種能力一起變動。
一、先分清三個詞:可監控性、不寫草稿的推理、可控性
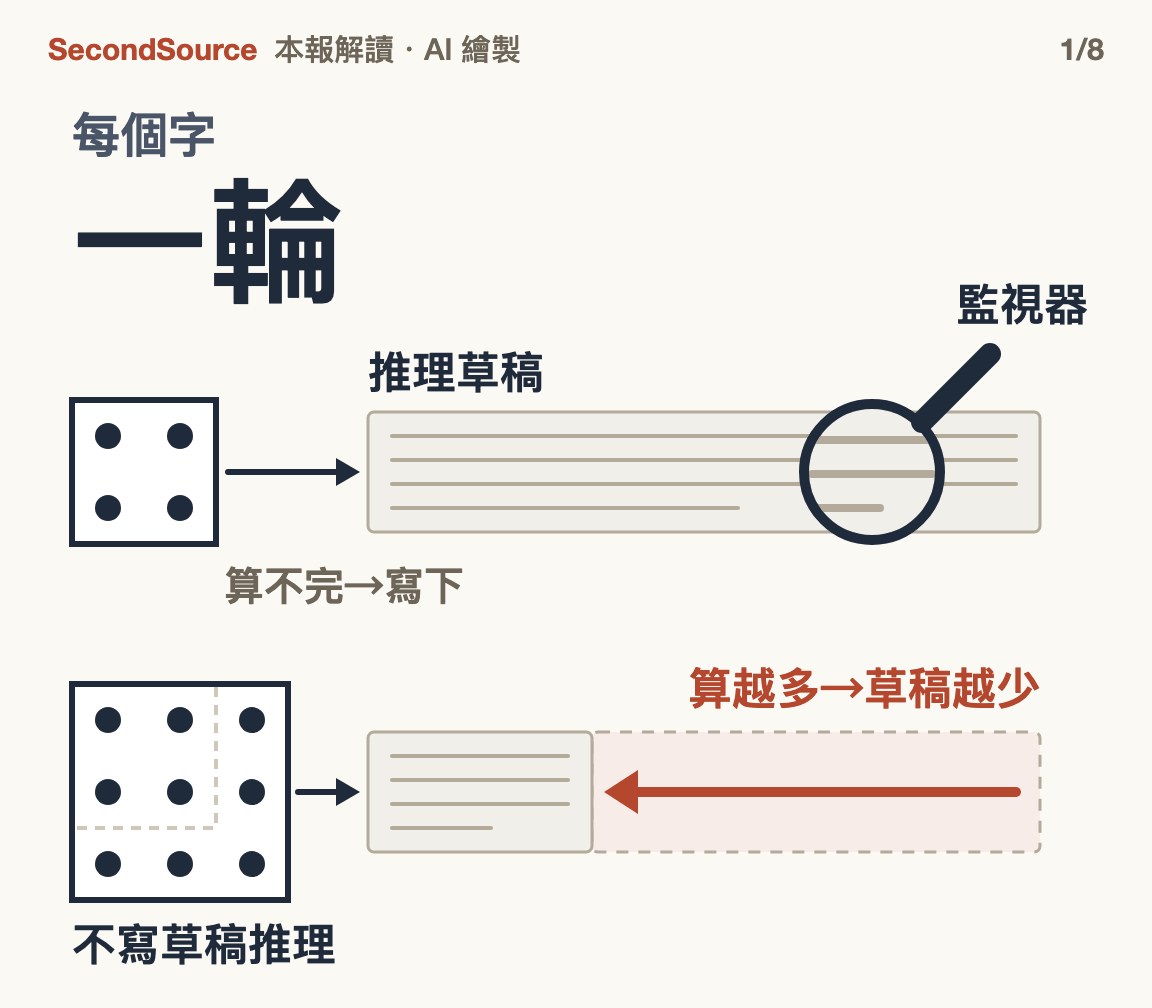
推理模型在給出答案前,會先用人話寫一段推理過程,學界叫思維鏈,本篇稱推理草稿。業界抓 AI 做壞事的主力手段,是派另一個模型(監視器)去讀這份草稿。讀了草稿看不看得出模型在做什麼,叫可監控性。
這招能用,靠的是一個技術限制。模型每吐出一個字只做一輪計算,這一輪叫前向傳遞。一輪能接的推理步數有限,難題只能把中間結果寫出來、再讀回去接著算,就像心算不了的長除法得寫在紙上。所以草稿讀得到,不是因為模型願意給人看,而是不寫就算不出來。
由此有兩種能力。第一種是不寫草稿的推理,學界叫無思維鏈推理:不准寫草稿時,模型在一輪計算裡還能算多少。這種能力越強,模型越不必把推理寫出來,監視器能讀的就越少,而且不需要模型有任何隱瞞的意圖。第二種是可控性:題目後附一條草稿怎麼寫的指令,例如推理時不准用某個詞,看模型做不做得到。可控性高,代表模型被要求時能把草稿寫成別的樣子;模型若想隱瞞,監視器讀到的就未必是真實過程。OpenAI 三月的論文量的是 Astra 之前的模型,照做比例普遍很低,因此判斷可控性目前不太可能讓監控失效。Astra 是之後的例外,照做比例明顯較高(第三節)。
兩種能力都會讓監控變弱,方式不同:可控性要模型被要求或想隱瞞時才起作用;不寫草稿的推理一變強,草稿自然變少。這兩種加上可監控性,就是第八、九節說的三項。
兩種能力為什麼會被認為有關?直覺上兩者都像模型對自身推理的掌控力:能在一輪計算裡多算幾步的模型,似乎也更能決定草稿上寫什麼。OpenAI 也說,Astra 訓練過程中兩者一起上升。若兩者總是一起高、一起低,量了可控性就等於量了不寫草稿的推理;若不是,只講可控性的保證,就沒回答不寫草稿的推理。本篇回答的就是這一題。
二、主角是 OpenAI 最新旗艦 GPT-6 Astra,官方保證只講了可控性
GPT-6 Astra 九月三日發布,是 OpenAI 目前最強的模型,系統卡同日公開;本篇提到的系統卡都指這一份。
系統卡量到,讀 Astra 的草稿抓問題,比讀前代 GPT-5.6 Sol 難,也就是可監控性下降。同一天,《財星》(Fortune)報導外傳 Astra 改用更有效率的新架構,安全專家擔心推理會變得不透明。機器學習作者 Sebastian Raschka 的文章替這種傳聞中的新架構取名 looped transformer。它的做法是:同一組計算層在吐出下一個字前反覆使用,等於一輪計算多算幾圈,正好是不寫草稿也能多推理的路。transformer 是當今大模型的基本架構。新架構是不是 looped transformer,至今未經證實(第三節)。Raschka 本人認為層重用不是模型在故意遮掩:草稿變少,是因為要寫出來的中間步驟變少了。但對監視器來說,沒寫出來的步驟一樣讀不到,這正是第一節說的問題。
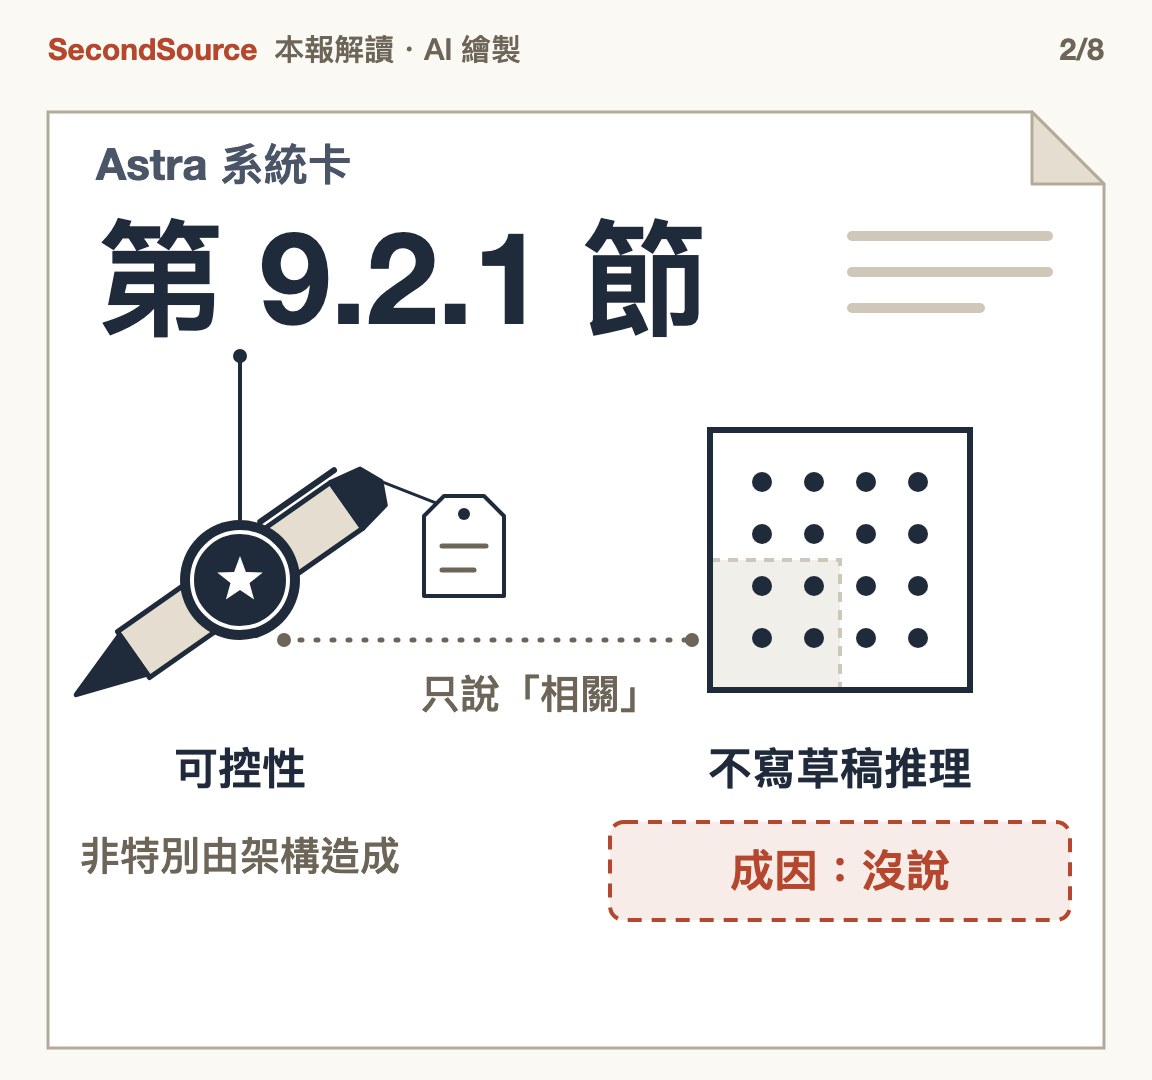
OpenAI 的回應在系統卡第 9.2.1 節那一段,本篇說的「保證」指的是這整段;這段談到架構,本報把它讀成對外界架構疑慮的回應。核心是這句: OpenAI「相當有信心」,可控性的變化並非特別由任何架構變更造成(英文原句見附錄)。這句的說法預設了前後兩代的架構有改(第三節也這樣讀),但改了什麼,全卡沒說。「並非特別」是說架構沒有特別針對可控性起作用;架構是否讓各種能力一起變強,這句沒回答(見附錄)。那一段每一句都在講可控性;不寫草稿的推理只在段末出現,只說兩者「相關」,沒說成因。
問和答對不上。照第一節的邏輯,不寫草稿的推理一變強,草稿就變短,監控就變難;外界擔心的,是新架構讓推理躲到草稿以外,也就是這串因果的第一步。對下面三個問題,系統卡的交代加上本報的補充是:
- 監控為何變難:大部分因為草稿變短(第七節)。
- 不寫草稿的推理為何變強:全卡沒有解釋,也沒說架構有沒有份。
- 可控性為何變:卡上說並非特別由架構造成;本報在第三節整理的線索指向後訓練。
外界問的是第二項;卡上唯一談架構的那句,答的是第三項。
三、可控性主要在後訓練階段被改變
大模型的訓練分兩段。預訓練是讀大量文字,學會語言與知識。後訓練是之後再用人類回饋與強化學習調整行為;強化學習就是做對給獎勵,反覆練。推理模型怎麼寫草稿,主要在後訓練練出來。
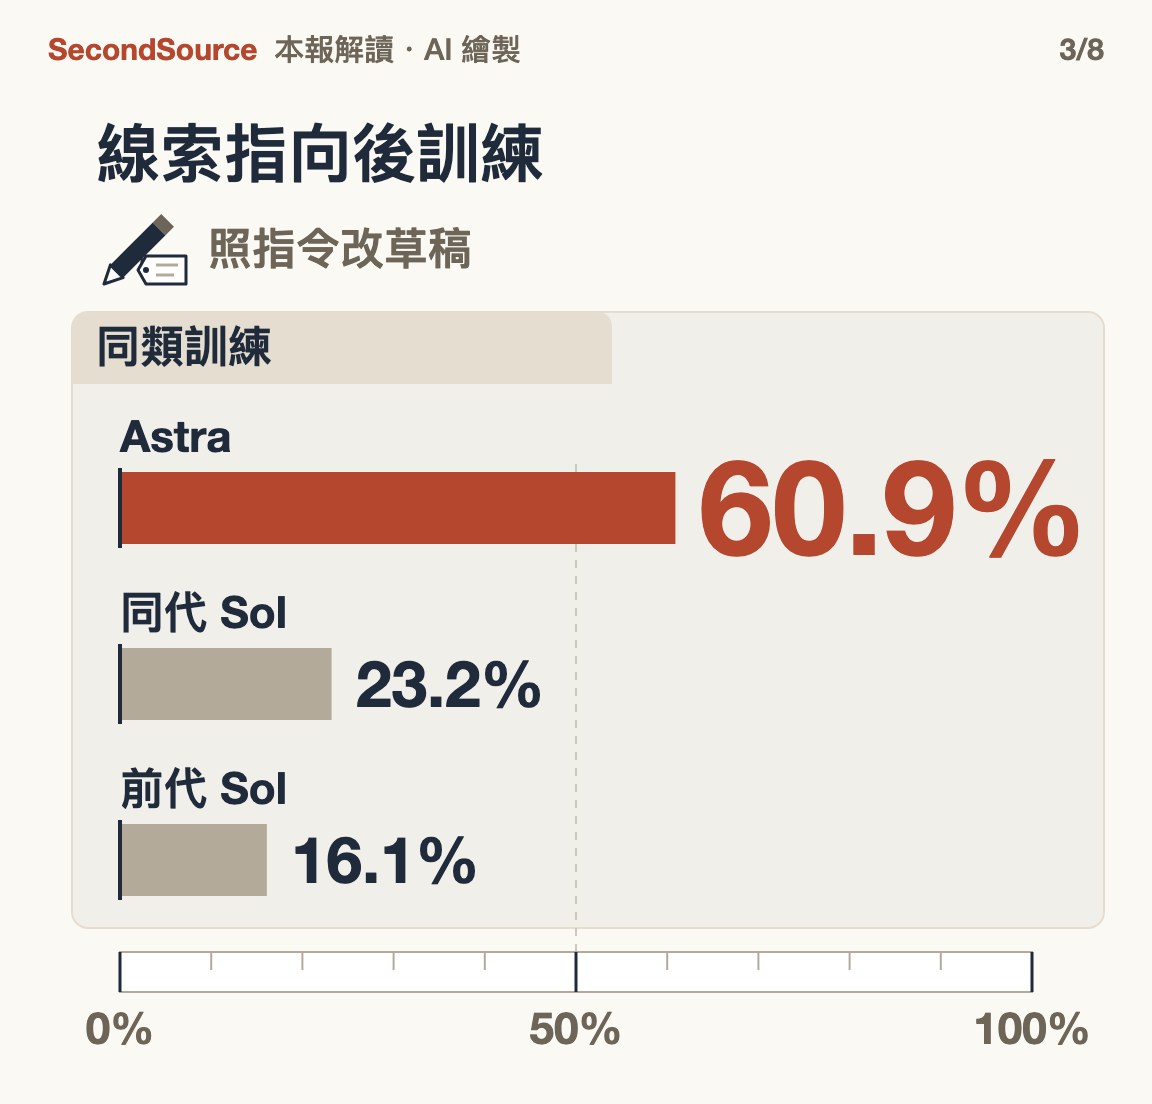
可控性的線索都指向後訓練,但每一條單獨看都不是鐵證。OpenAI 三月的可控性評測論文 CoT-Control 寫,可控性「隨更多強化學習訓練而下降」。六個月後的 Astra 系統卡卻寫,「與先前模型不同」,可控性在強化學習訓練中上升。同一套評測,方向相反。九月二十二日,系統卡附錄加入同代較小的 GPT-6 Sol,寫明「使用與 Astra 相同類型的資料與訓練」。在 750 到 1,250 個 token 的草稿長度內(token 是模型處理文字的最小單位),照指令改草稿的比例:Astra 60.9%,GPT-6 Sol 23.2%,前代 GPT-5.6 Sol 16.1%。
同類訓練不等於細節相同,差距這麼大,符合「後訓練細節不同,可控性就不同」;兩款練法具體差在哪,OpenAI 沒說。都不是鐵證:前後兩代之間也換了架構,GPT-6 Sol 規模較小、架構未揭露,差距也可能來自這些。
不寫草稿的推理是在哪一段、因為什麼變強的,目前沒人證實。looped 架構之說,Nanda 寫明「未經證實」。
四、學界目前的五條路
1. 量可監控性:讀了草稿抓不抓得到問題。OpenAI 在系統卡裡用五項評測。
2. 量可控性:題目後附一條草稿指令,看模型照不照做,就是 OpenAI 三月的 CoT-Control 論文。
3. 量不寫草稿能算多少:Nanda、英國政府的 AI 安全研究所,與 AI 安全論壇 LessWrong 上的幾位作者,各自出題量 Astra。
4. 草稿變短的代價:在小模型上逼草稿變短,看監控還靈不靈(第七節)。
5. 架構之爭:反覆使用同一組計算層,會不會把推理藏到草稿以外。機器學習作者 Sebastian Raschka 認為層重用本身不遮蔽草稿。
五、跨 34 個模型比:不寫草稿推理強的模型,可控性不見得高
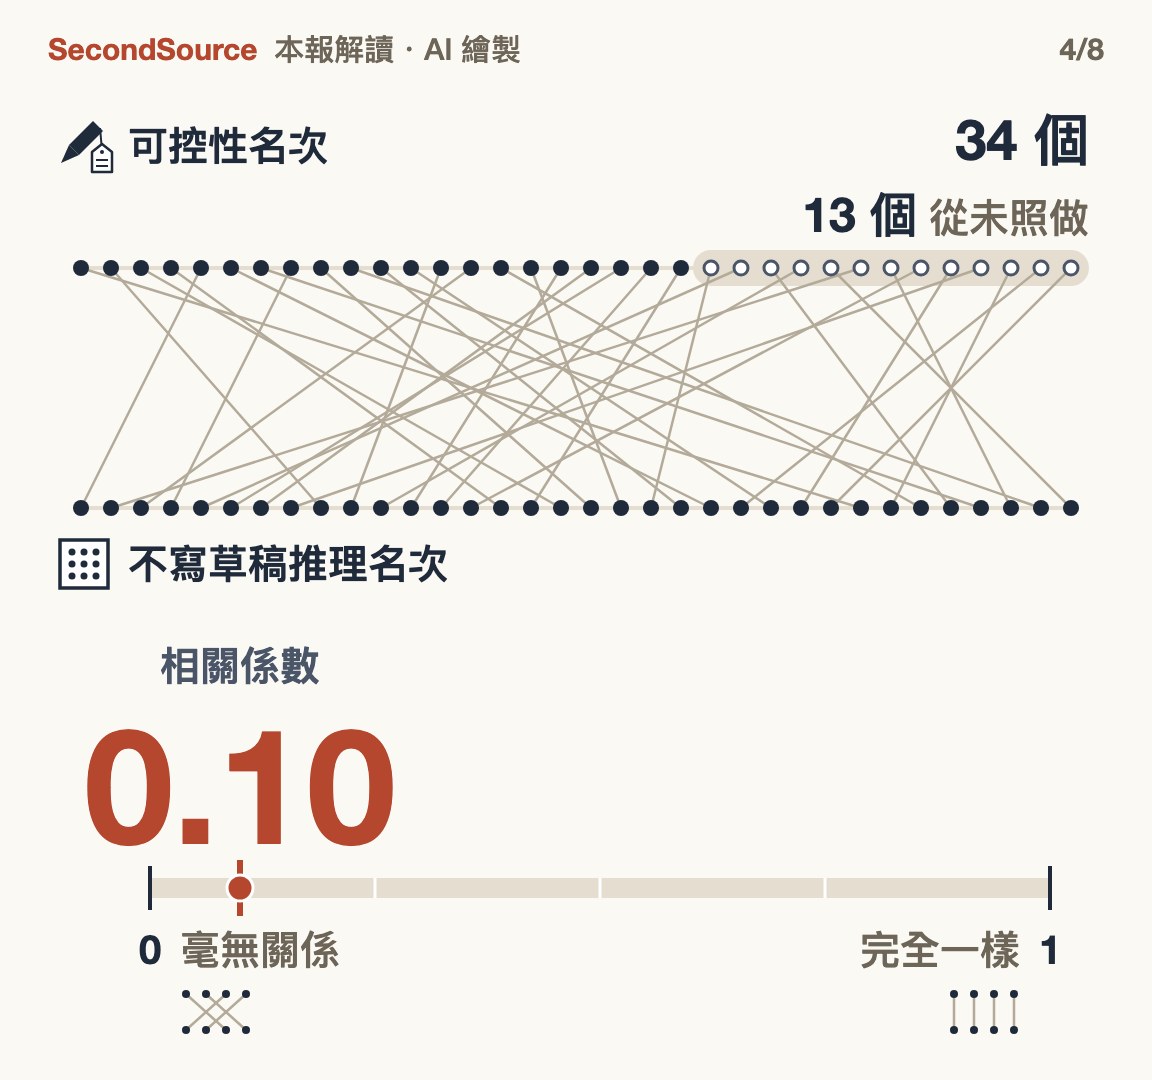
九月十日,Nanda 以個人身分,用 CoT-Control 量了 34 個開放權重推理模型。開放權重指模型檔公開可下載、看得到完整草稿。每個模型跑 108 題,再對照 Nanda 自製的不寫草稿推理指數,分數越高,不寫草稿能做對的題越多。
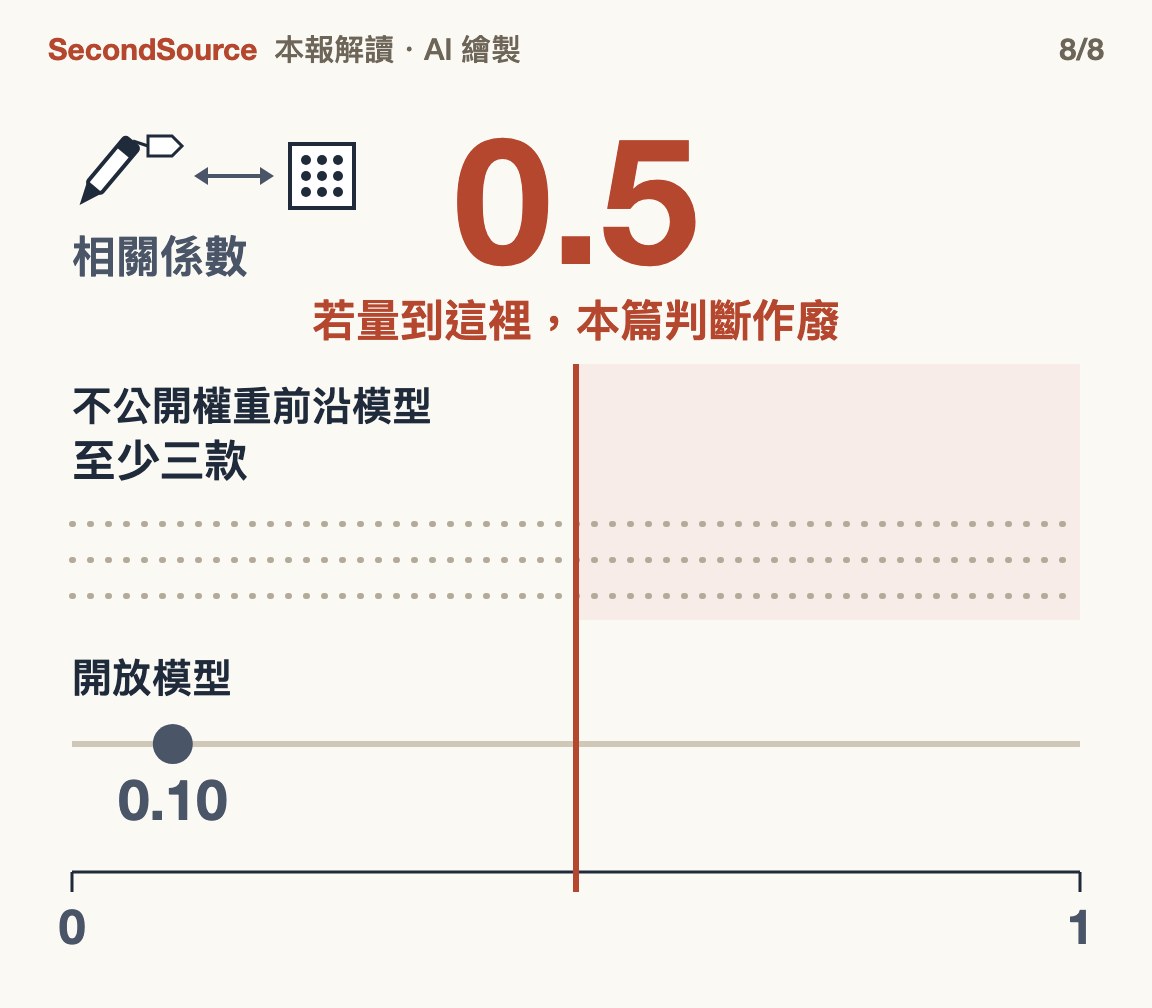
Nanda 把 34 個模型依兩種能力各排一次名次,看兩份名次像不像,這個數叫相關係數:1 表示完全一樣,0 表示毫無關係。結果是 0.10,接近無關。
這和 OpenAI 說兩者一起上升不矛盾。OpenAI 看的是同一家、同一套練法下一路追蹤;Nanda 比的是同一時間各家的模型。好比同一間補習班裡,數學與作文可能一起進步;不同補習班的學生放在一起比,兩科就未必相關,因為各班教法不同。Nanda 的解釋正是如此:可控性「深受後訓練細節的影響」。
限制 Nanda 先寫了:34 個模型裡 13 個一次都沒照做,整體照做比例不到 3%。13 個模型並列最低,相關係數算不準。所以本篇只採最保守的讀法:在這批模型上看不出兩者一起變動,0.10 不當精確值。
還有一個缺口:這批開放模型照做不到 3%,OpenAI 的模型在第三節那個長度區間是 16% 到 61%,口徑不同,只能比量級。結論能不能套到 Astra,要等有人在不公開權重的前沿模型上量(推翻條件第 2 條)。
六、Astra 不寫草稿能算多少:外部重跑確認躍升
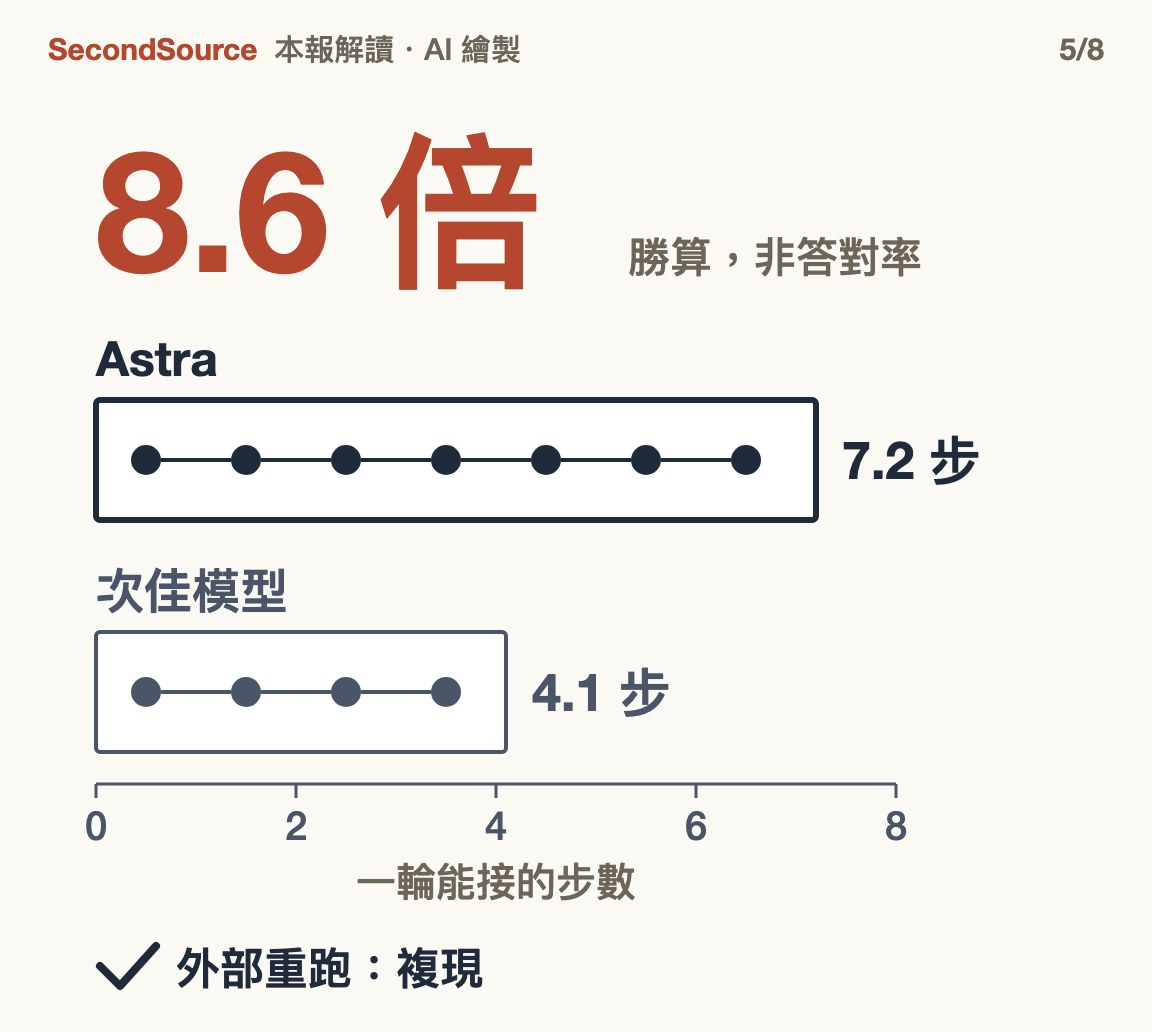
Nanda 原本懷疑英國 AI 安全研究所量到的躍升,用自製題庫重跑,結果「很不幸,複現了」。
三個讀數。第一,Astra 不寫草稿完成推理題的勝算,約是次佳的 Anthropic Claude Fable 5.1 的 8.6 倍;勝算是成功次數比失敗次數,不是答對率的 8.6 倍。第二,一輪計算能接的連續算術步數,Astra 約 7.2 步,次佳 4.1 步。第三,這個本事集中在特定題型:碰到要一連串接著算、或同時算好幾件事的人工設計題,Astra 的勝算約是做其他題型時的 16 倍,這是 Nanda 的換算,算法見附錄。這正是能代替寫草稿的那種能力。
限制:英國 AI 安全研究所的原件未見公開版本。
七、同一個結果兩種寫法:系統卡說草稿變短讓監控變難,企業發布文說它省錢
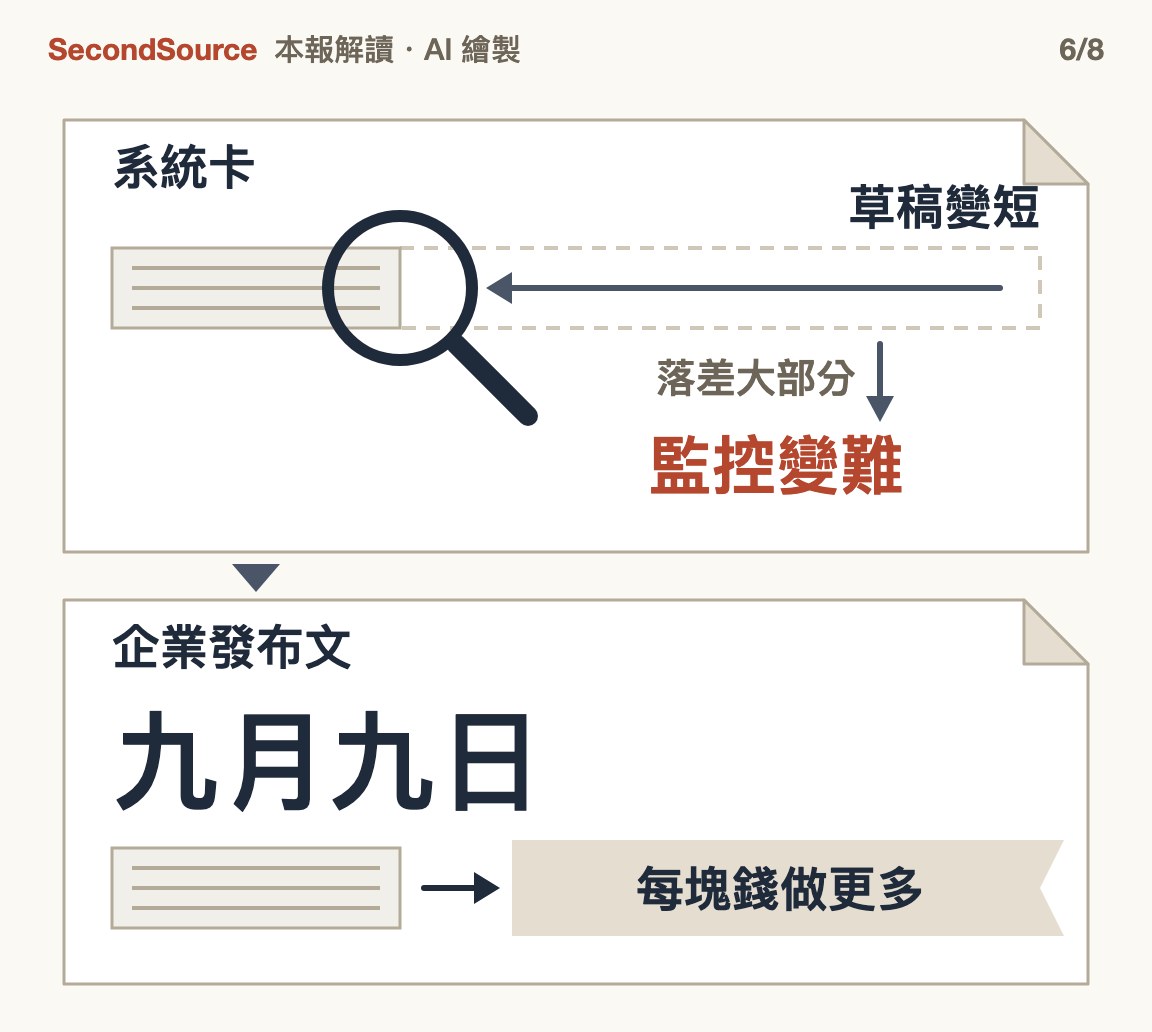
九月三日的系統卡寫了機制:「可監控性的落差大部分來自 GPT-6 Astra 產出更短的思維鏈,這些思維鏈常省略或弱化監視器需要的證據。」
九月九日,OpenAI 給企業客戶的發布文把 Astra 寫成「每一塊錢買到更多有用的工作」,因為 Astra「被訓練成用更少 token、更少重試完成任務」。推理草稿也是用 token 寫的;系統卡另量到,給同樣的推理 token 上限,不論上限設多少,Astra 都用得比前代少(見附錄)。本報把兩份文件放在一起看:同一個結果,系統卡寫成監控變難的原因,企業發布文寫成省錢的理由;OpenAI 沒有一份文件把兩件事放在一起講。
反向證據:謝菲爾德大學等十月的論文在小模型上逼草稿變短,可監控性大致守得住(見附錄)。可見草稿變短不一定讓監控變難。本報採用系統卡對 Astra 的解釋,但不把它推廣成通則。
八、這句保證,外人查得了嗎
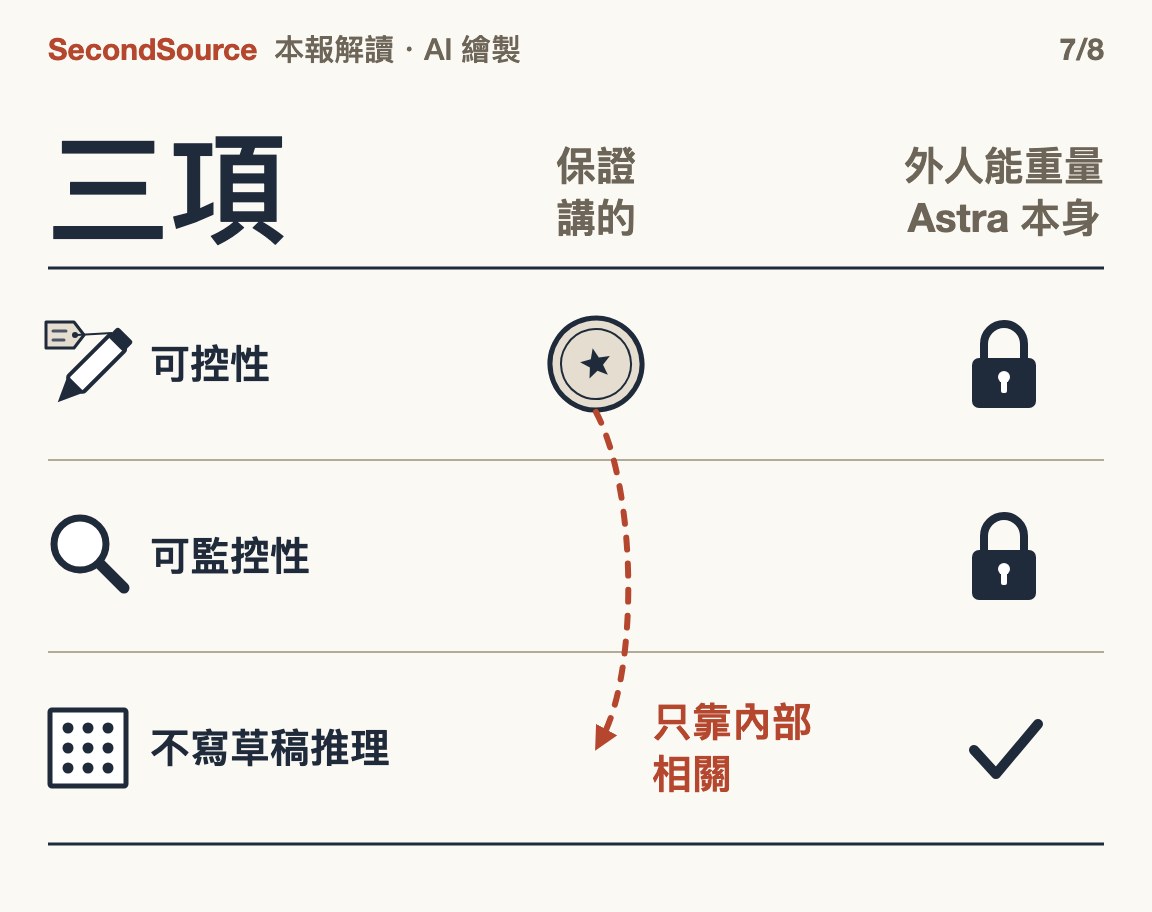
第一節那三項,誰量了、外人能不能重量:
| 能力或指標 | 誰量了 | 外人能不能重量 |
|---|---|---|
| 可控性 | OpenAI;英國 AI 安全研究所受邀也量了 | Astra 本身:不能,只有 OpenAI 與研究所量過。方法:能,題目公開,開放權重模型誰都能重跑 |
| 可監控性 | 只有 OpenAI,用自家方法 | 不能;受邀的研究所談到這項,部落格也只寫「結果請讀該模型的系統卡」 |
| 不寫草稿的推理 | OpenAI 與研究所的數字在系統卡內;Nanda 另外獨立量了 Astra | 能:第六節的重跑就是。量過的有好幾組,公開程式碼與資料的只有 Nanda |
保證談的是可控性。外人能用開放權重模型重跑這套方法,但 Astra 本身的分數與成因判斷(變化並非特別由架構造成),外人都查不了。要把保證延伸到不寫草稿的推理,只能靠 OpenAI 內部那個兩者一起上升的相關,而那個相關沒有公開數字,也沒有公開方法。
九、這對誰意味著什麼
- 部署會操作企業系統的 AI 的公司:「用更少 token 完成任務」有兩面:帳單較低,留下來供事後稽核的草稿也較短。供應商問卷若只問一欄「思維鏈監控」,三項會被混成一項。
- 寫採購條款與監管規範的人:條款綁在架構上會落空,綁在量得到的結果上才有效:模型被要求躲避監視器時的召回率,以及不寫草稿推理的外部可比讀數。召回率是真有問題的案例裡被抓到的比例。這個數系統卡上有,但只有 OpenAI 自量(見附錄)。
方向判斷
讀 AI 公司的安全保證,先問兩件事:保證講的是哪一項,外人能不能重量一次。
之後看哪幾個讀數
OpenAI 下一款前沿模型(能力最強那一級)的系統卡有沒有把三項分開給數字,以及 GPT-6 Sol 的架構有沒有揭露。
什麼會推翻本篇
觀察窗都到 2027 年 3 月 31 日;第 1 條遇新系統卡則以發布後十四天為準。
1. 下一款 OpenAI 前沿模型系統卡發布後十四天內(前沿模型的判準見附錄口徑說明):若卡內對不寫草稿推理能力的變化給出成因或架構歸因,代表這一項已分開交代,本篇「保證只講可控性」的判斷作廢。
2. 到 2027 年 3 月 31 日:若任一第三方(例如受邀評估的機構)在至少三款不公開權重的前沿模型上,用真實草稿量到兩者相關係數 0.5 以上,「兩種能力不是同一件事」作廢。
3. 到 2027 年 3 月 31 日:若 OpenAI 公開 Astra 訓練過程中兩者相關的數字與方法,且相關來自架構而非後訓練,第三節要改寫。
附錄:數字怎麼來的
每個數字的出處
| 數字 | 量什麼 | 誰量 | 哪裡 |
|---|---|---|---|
| 0.10 | 可控性與無思維鏈推理指數的 Spearman 相關,34 個開放權重模型 | Neel Nanda | Alignment Forum 貼文附錄,2026-09-10 |
| 13/34、<3% | 一次都不遵從的模型數、合併遵從率 | 同上 | 同上 |
| 6–13%、11%、0 | GLM-5 系列、一個 DeepSeek 模型、Qwen 3.5 各規格的可控性 | 同上 | 同上 |
| 8.6 倍、7.2 對 4.1 步、40 點(16 倍) | 無思維鏈推理勝算、單次前向序列步數、合成任務偏斜 | 同上 | 同上正文 |
| 60.9%、16.1%、1.7%、23.2% | 750–1,250 token 視窗內遵從思維鏈指令的比例:Astra、GPT-5.6 Sol、GPT-5.5 Thinking、GPT-6 Sol | OpenAI | 系統卡 §9.2.1 與附錄 11.7.1.1(09-22 新增) |
| 93%、48% | 遵從約束的樣本比例:Astra、GPT-5.6 Sol | 英國 AI 安全研究所(在卡內) | 系統卡 UK AISI 段 |
| <11%、0 | 指示規避下只讀思維鏈的監視器召回率:WMDP、Monorepo-Bench | OpenAI | 系統卡 §9.2.2 |
| ~10%→~50%、15–40 分、10 對 35 分 | filler token 四跳推理、無思維鏈 50% 時間長度、思考開關落差 | 三組 LessWrong 作者,Zvi 彙整 | Zvi 2026-09-12 |
| 2.7%、61.9% | Claude Sonnet 4.5 控制思維鏈與控制最終輸出的比例 | OpenAI 等 | arXiv 2603.05706 摘要 |
第二節引文原文
系統卡第 9.2.1 節:「We are also quite confident that changes in CoT controllability are not differentially due to any architectural changes.」
第五節的實驗室細節
開放權重模型裡做得到一點的按實驗室聚集:智譜的 GLM-5 系列 6% 到 13%,一個 DeepSeek 模型 11%,阿里巴巴的 Qwen 3.5 從 9B 到 397B 每一個都是零。
Qwen 3.5 從 9B 到 397B 的每個規格可控性都是零,總參數相差約 44 倍。本報的推論只到這裡:在同一家,規模變大沒有帶來可控性。各規格的無思維鏈指數未見逐一讀數,所以這還不是後訓練假說的反例。
第六節數字的細節
單次前向傳遞能做的序列算術步數,Astra 約 7.2 步,次佳 4.1 步。也就是不寫中間過程時,一連串前後相依的算術最多能接幾步。Astra 在合成的序列與平行運算任務上的無思維鏈指數,比在其他任務上高約 40 點。Nanda 換算成勝算,約是 16 倍。
第八節的可控性第三方讀數
英國 AI 安全研究所在卡內量到,Astra 遵從約束 93%,GPT-5.6 Sol 48%。這組數字的口徑與第三節的 60.9%、16.1% 不同,長度視窗與題庫未揭露。
其他三組外部讀數
Zvi Mowshowitz 九月十二日彙整三篇 LessWrong 貼文:在提示裡塞無意義字元再要求立即作答,Astra 在四跳事實推理上從約 10% 升到約 50%;兩位研究者估 Astra 不寫思維鏈能做完一半任務的時間長度在 15 到 40 分鐘,而兩人先前的中位預測是到 2028 年底不會超過 7 分鐘;關掉思考模式,Astra 只掉 10 分,Fable 5.1 掉 35 分。三組數字皆為貼文自報、經 Zvi 轉錄,原貼未核對。
第七節的反向證據
系統卡五項可監控性評測裡,把草稿長度拉齊再比,三項落差收斂;兩項仍較差,表示草稿內容本身也少了證據。這是「大部分、不是全部」的依據。
系統卡另寫:兩款模型給同樣的推理 token 上限,每一檔 Astra 實際用得都比 GPT-5.6 Sol 少。
謝菲爾德大學等十月二日的論文(arXiv 2610.03509)用三種施加長度壓力的方法微調開放權重模型:固定生成預算、逐例長度目標、群組相對長度獎勵。結果忠實性在多數設定下降,主因是訓練後模型一致性變差;可監控性較穩健,模型在思維鏈變短很多時仍會承認介入影響了答案。量的是小模型、用的是介入偵測口徑,與 OpenAI 系統卡的度量不同。以上依論文摘要。
本報追蹤的趨勢線
進行中 ?
本篇在圖上:這條線追的是,模型的推理還看不看得懂、由誰來驗證。本篇接在樹裡「承重面換手」那一節之後,多加一個問題:驗證用的尺,量的是不是真正支撐結論的那個量。這條線原本的判斷不變。
本報算的數
- CoT-Control 論文的完整趨勢句:可控性「對較大的模型較高,並隨更多強化學習訓練、更多測試時算力與更高題目難度而下降」,並判定可控性「目前不太可能成為可監控性的失效模式」。Nanda 對可控性分布的自評原話是「It's a mess.」
- 約 44 倍:Qwen 3.5 最大與最小規格的總參數比,397B 除以 9B。只用來說明同一家內規模差距很大而可控性全零;各規格的無思維鏈指數未見逐一讀數。
- 升 7 個百分點、升 45 個百分點:GPT-6 Sol 23.2% 減 GPT-5.6 Sol 16.1%;Astra 60.9% 減 16.1%。同一長度視窗,卡內數字直減。
口徑說明
- 可控性數字全部來自單一長度視窗(750–1,250 token),卡未給全長度彙總值;英國 AI 安全研究所的 93%、48% 未揭露長度視窗與題庫。
- 系統卡寫可監控性落差「大部分」來自更短思維鏈,沒有比例;「用更少推理 token」沒有百分比。企業版稿的「每題成本低 9% 與 63%」是自報的跨廠成本估計,不是 token 數。
- Nanda 的三項外部讀數(filler token、時間長度、思考開關)經 Zvi 轉錄,原貼未核對。
- 推翻條件第 1 條的前沿模型,指 OpenAI 用來評估模型危險程度的準備度框架裡,任一領域評為 High 以上的模型。
- Korbak「幾個世代之間強烈相關」一句經 Zvi 九月八日轉錄,附有推文連結,原推文未核對。系統卡九月二十二日、二十九日兩次更新,都沒有改第 9.2.1 節那一段。
別的說法(並列,不進正文)
- 第一方在系統卡外的更廣否認:OpenAI 對齊研究員 Tomek Korbak 九月三日在 X 上寫,可監控性下降「來自智力躍升,不是對思維鏈的直接優化壓力,也不是架構變更」。這句涵蓋整體可監控性,但只在推文,不在系統卡上;經 Zvi Mowshowitz 九月八日轉錄,原推文未核對。
- 「differentially」的另一種讀法:Nanda 提出,looping 改善預訓練,預訓練變好本來就會讓所有能力一起變好,所以「不是 looping 特別造成的」可以同時誠實且沒有資訊量。本篇兩種讀法都留。
- 架構無罪論:Sebastian Raschka 九月指出層重用本身不遮蔽思維鏈,可見推理痕跡變少是因為需要吐的中間 token 變少。這與第七節「落差大部分來自更短思維鏈」同向,但不回答為什麼變少。
- 系統卡後續更新:九月二十二日修正 HealthBench 誤設定並新增 GPT-6 Sol 與 Luna 附錄;九月二十九日新增以 Astra 驅動的常駐 AI 助手 dots 附錄。兩次更新都沒有改第 9.2.1 節那一段。
- 自我指令可提高可控性:arXiv 2610.23257(十月十六日)主張把約束放進模型本身的思維鏈裡當自我指令,可控性顯著高於放在使用者提示裡,並示範可用於規避監視器。這會讓「開放權重可控性近零」的讀數偏低,但不改變跨實驗室聚集的形狀。
本篇依據的出處
以下由本篇引用的事實紀錄機械彙整,每條是其中一個事實的出處;原件本報是否讀過、還是只讀到轉述,以正文各段的說明為準。
- Alignment Forum — Neel Nanda · 2026-09-10:Astra can do a concerning amount with no chain of thought
- OpenAI · 2026-09-03:GPT-6 Astra System Card
- Don't Worry About the Vase · 2026-09-08:Astra Is Hard to Monitor
- OpenAI · 2026-09-09:GPT-6 Astra: The next generation in intelligence for work
- Ahead of AI · 2026-09-09:GPT-6 Astra, Looped Transformers, and Hidden Reasoning
- Tomek Korbak · 2026-09-03:x.com/tomekkorbak/status/2095596839886274689
- Fortune · 2026-09-03:AI experts worry OpenAI's Astra model may be a dangerous step toward models with opaque reasoning
- Rauno Arike · 2026-09-03:How concerned should we be about Astra's recurrent architecture?
- Don't Worry About the Vase · 2026-09-12:thezvi.substack.com/p/gpt-6-astra-can-do-ambitious-things
- arXiv:Monitoring Monitorability
- OpenAI Blog:openai.com/news/
- arXiv · 2026-10-02:Efficient Reasoning Training Does Not Always Harm CoT Faithfulness and Monitorability
其他語言版引用的出處
以下出處在本篇其他語言版的正文裡有連結,這一版正文沒有連到,補列於此。