深掘り 2026年10月8日
長文書 AI の点数は読んだ量についてくる——同じモデル群でも外側のプログラムを替えると、審査の合格率が平均 39 ポイント上がる
SecondSource 深掘りレポート #40
本稿は 2026 年 10 月 8 日に掲載し、10 月 23 日に現行の基準で書き直した。出典を確かめ直し、三つの判断を改めた(付録)。
本稿の要点
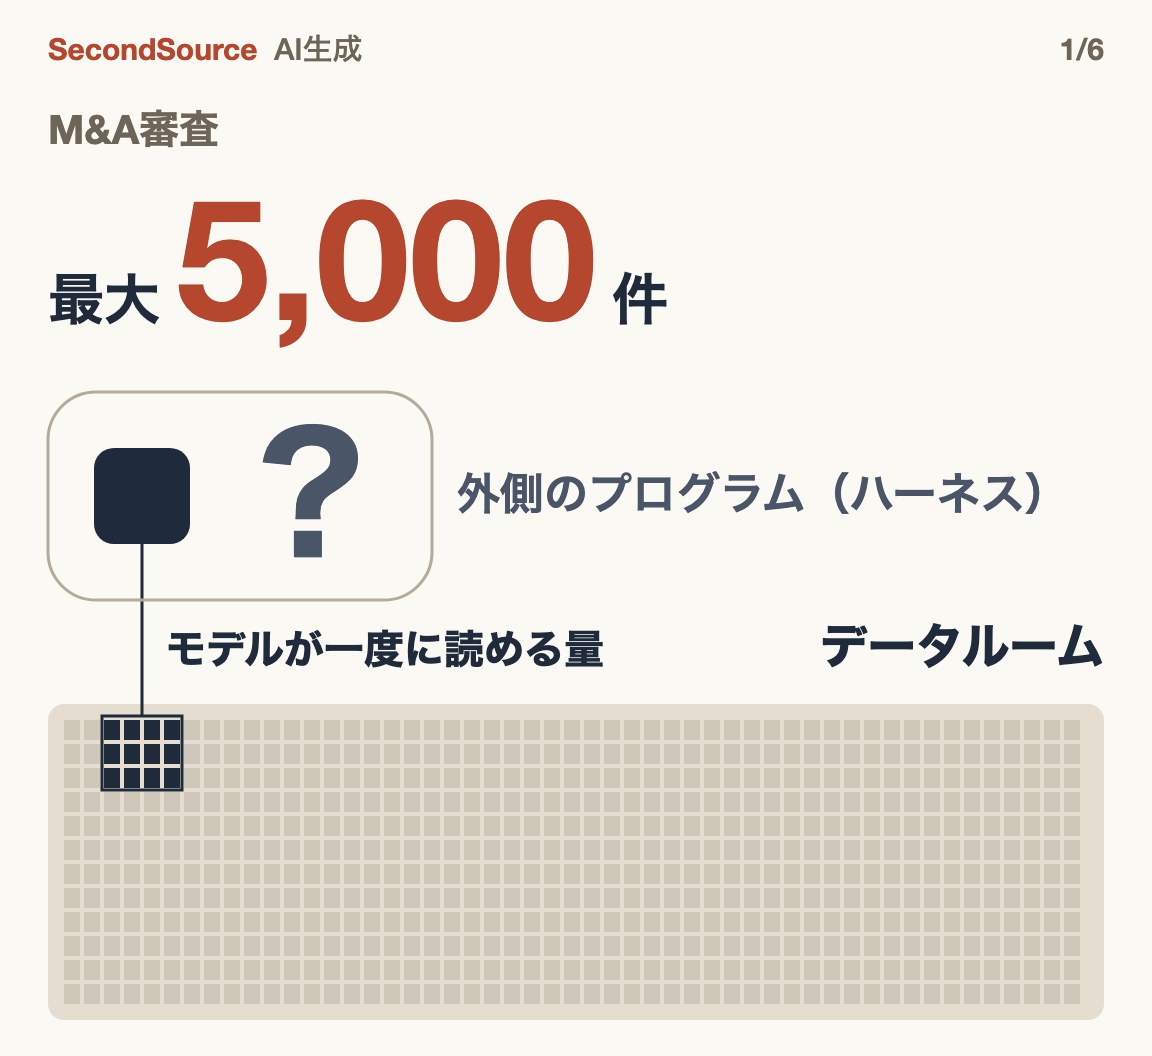
法律 AI 企業の Harvey は 9 月 8 日、一組の実験を公表した。7 つの AI モデルに、買い手の立場で模擬の M&A 文書を審査させる。1 件あたり最大 5,000 件の文書があり、モデルが一度に読み込める量をはるかに超える。モデルはそのままで、外側のプログラム(本稿ではハーネスと呼ぶ)だけを替えると、専門家が挙げた審査項目の平均合格率は 23.3% から 62.4% に上がった。読み込んだ資料が多いほど、点数も高い。
本誌は原文を確かめ、二点を補う。既製のコーディング用 AI エージェント二つの点数が低かったのは、初期設定のままで早く読むのをやめたからで、できないという意味ではない。ハーネスを正しく替えた後も、モデルの良し悪しの差はなお大きく、Harvey が鍛え直したオープンウェイトモデルも最良の商用モデルに負けている。したがって単一業界に特化した AI 企業で他社がまねしにくいのは、ハーネスのプログラムではなく、今のところ自前で鍛え直したモデルでもない。本誌の推論では、審査の良し悪しを判定する採点基準と、それに沿って組んだ模擬データルームである。数字はすべて Harvey 1 社のもので、文書は模擬である。
1. まず言葉を分ける——データルーム、エージェント、ハーネス
データルームとは、企業買収の際に売り手が買い手の審査用に開示する大量の文書のことだ。買い手の弁護士はそこからリスクを探す。この作業をデューデリジェンスという。Harvey はプログラムで模擬のデータルームをつくり、それぞれに専門家が書いたチェックリストを付けた。
エージェントとは、検索し、プログラムを書き、ツールを呼んで、仕事を自律的に片づける AI プログラムである。ハーネスとは、モデルの外側にあるプログラムで、モデルがどう読むか、どうツールを呼ぶか、いつ止めるかを決める。業界でも harness と呼ぶ。
Harvey は三つのやり方を比べた。
- 単純なツールループ:1 つのエージェントが検索し、文書を選んで読み、十分だと判断したら調査メモを書く。Harvey が自前でつくった法律 AI の試験の標準設定である。
- 再帰型ハーネス:主エージェントは文書を直接読まない。プログラムを書いてデータルームを種類ごとに切り分け、一塊ずつサブエージェントに読ませる。サブエージェントが見つけたことを返し、主エージェントがそれをメモにまとめる。このやり方は、マサチューセッツ工科大学の Alex Zhang 氏らが 2025 年末に出した論文「再帰言語モデル」に由来する。本稿ではこれを元論文と呼ぶ。
- 既製の汎用コーディングエージェント:Anthropic の Claude Code と OpenAI の Codex。どちらもプログラムを書くために設計されたが、ファイル操作の道具で大量の文書を探すこともできる。
合格率とは、メモが満たしたチェック項目の割合である。別の AI が採点役になり、専門家のチェックリストと一項目ずつ照らし合わせて判定する。
事後学習とは、既存のモデルを特定の仕事のデータや報酬でもう一度訓練することだ。フロンティアモデルは、今いちばん能力の高い商用モデルを指す。オープンウェイトモデルは、モデルのファイルが公開され、自社のサーバーで動かせるモデルを指す。
2. 同じ 7 モデルでハーネスを替えると、平均 39 ポイント上がる
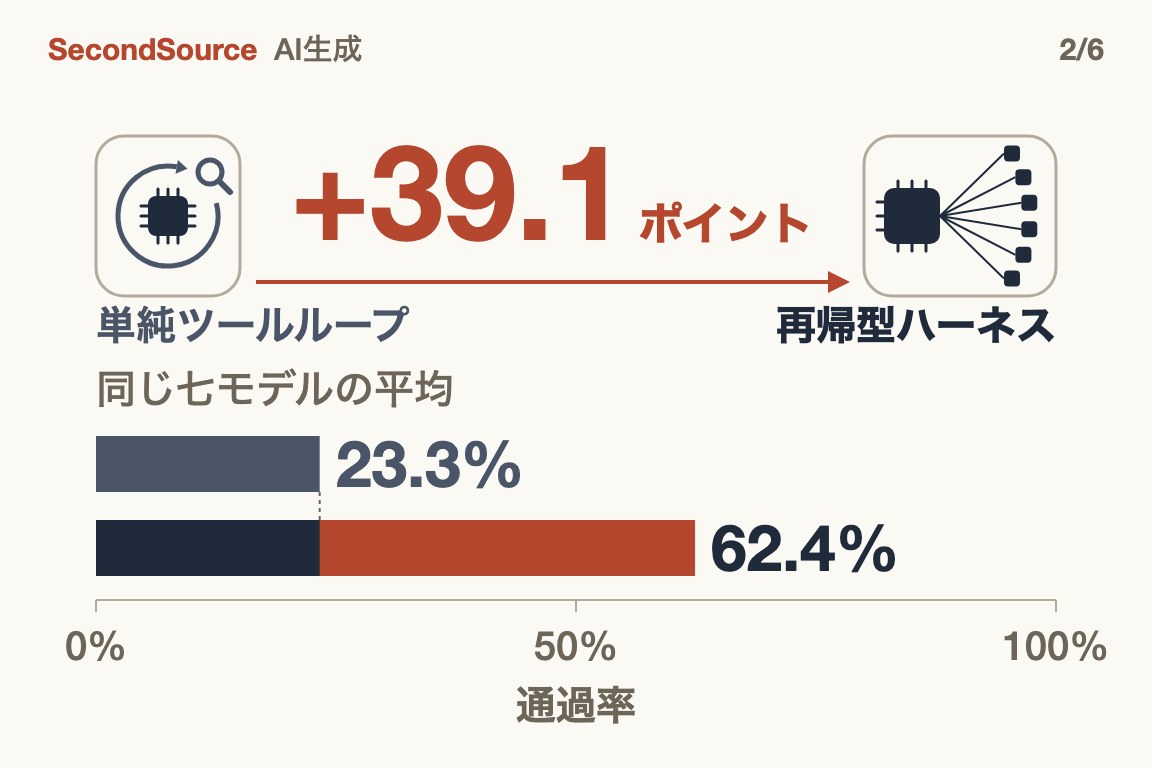
Harvey は模擬データルーム 50 室を試験専用に取り置き、第 4・6 節でモデルを鍛え直すときにも使わなかった。本稿の成績は、断りがない限りすべてこの 50 室のものだ。7 つのモデルには Anthropic の Claude Opus 5 や OpenAI の GPT-5.6 Sol などが含まれ、再帰型ハーネスでは順番に主エージェントを務める。サブエージェントには常に同じ小型のオープンウェイトモデルを使う。単純なツールループでの平均合格率は 23.3%、再帰型ハーネスでは 62.4% で、差は 39.1 ポイントだった。最高点は Opus 5 で、42.5% から 77.6% に上がった。モデル別の成績は付録に載せた。
既製の汎用コーディングエージェントはさらに低かった。Claude Code(Opus 5 で動かす)は 24.6%、Codex(GPT-5.6 Sol で動かす)は 12.0% で、同じモデルを単純なツールループに入れたときより、それぞれ 17.9 ポイント、4.6 ポイント低い。
これらの数字を読む前に知っておくべきことがある。データルームは模擬で、実際の取引ではない。採点役は AI で、弁護士の判断とどの程度一致するかを Harvey は示していない。事後学習(第 4・6 節)の報酬の点数も同じ採点役から出ている。試験官の基準で受験生を鍛えるのと同じで、事後学習による伸びの一部は採点役の好みに合わせただけかもしれない。Harvey はこれらの訓練実験を「初期の探索」と呼び、製品に組み込んだとは言っていない。
3. 点数は読んだ量についてくる
Harvey は実行のたびに、データルームの中身のうち実際にモデルに届いた割合を測った。単純なツールループは 1 回も 1% を超えず、大半は 0.1% から 0.5% しか読んでいない。再帰型ハーネスはほぼ毎回 10% を超え、大半はほぼ全量を読んだ。Harvey の結論は、多く読むほど合格率も高い、というものだ。
デューデリジェンスでは筋が通る。チェックリストには、複数の文書を突き合わせないと見つからない項目もあれば、あるはずの文書がないことを確かめる項目もある。開けていない棚について、中に何もないとは言えない。
ただし限界が二つある。
- サブエージェントに読ませるのは効くが、段を重ねるほどよいとは限らない。 Harvey は小さな追加実験で、サブエージェントがさらに下へ仕事を振れるよう一段増やした(主エージェントとサブエージェントは同じオープンウェイトモデル)。14 室のうち 4 室は良くなり、10 室は悪くなって、14 室の平均は 19 ポイント下がった。悪くなった 10 室のうち 4 室では、資料を読んだのに報告を書かなかった。失敗は報告を書く段階でも起きており、読んだ量だけが要因ではない。Harvey と無関係な 3 月の論文二本も同じ方向を指す。一本は元論文を実装し直したもので(本稿では再現論文と呼ぶ。試験の規模はずっと小さい)、二段目を加えると成績が下がり、実行時間は 3.6 秒から 344.5 秒に膨らんだ。もう一本(本稿では自己点検論文と呼ぶ)は再帰に頼らない。モデルに文書を探すプログラムを何通りか書かせ、モデル自身の確かさ(何度か答えさせて一致するか、自己申告の自信など)で一つを選ぶ。同じ時間で、元論文の再帰型のやり方を最大 22% 上回った。
- 多く読むことと高い点数は一緒に上がるだけで、因果は証明されていない。 仕事の分け方がうまいエージェントが、もともと多く読み、うまく書くのかもしれない。Harvey は両者の相関を報告しているだけで、この説明を排除していない。
4. 汎用エージェントが今回負けたのは初期設定のせいで、できないと証明されたわけではない
第 2 節の数字からは、汎用コーディングエージェントを万能のハーネスとして使うのは誤った選択だ、という結論が出やすい。だが、まず何を測ったかを見る必要がある。
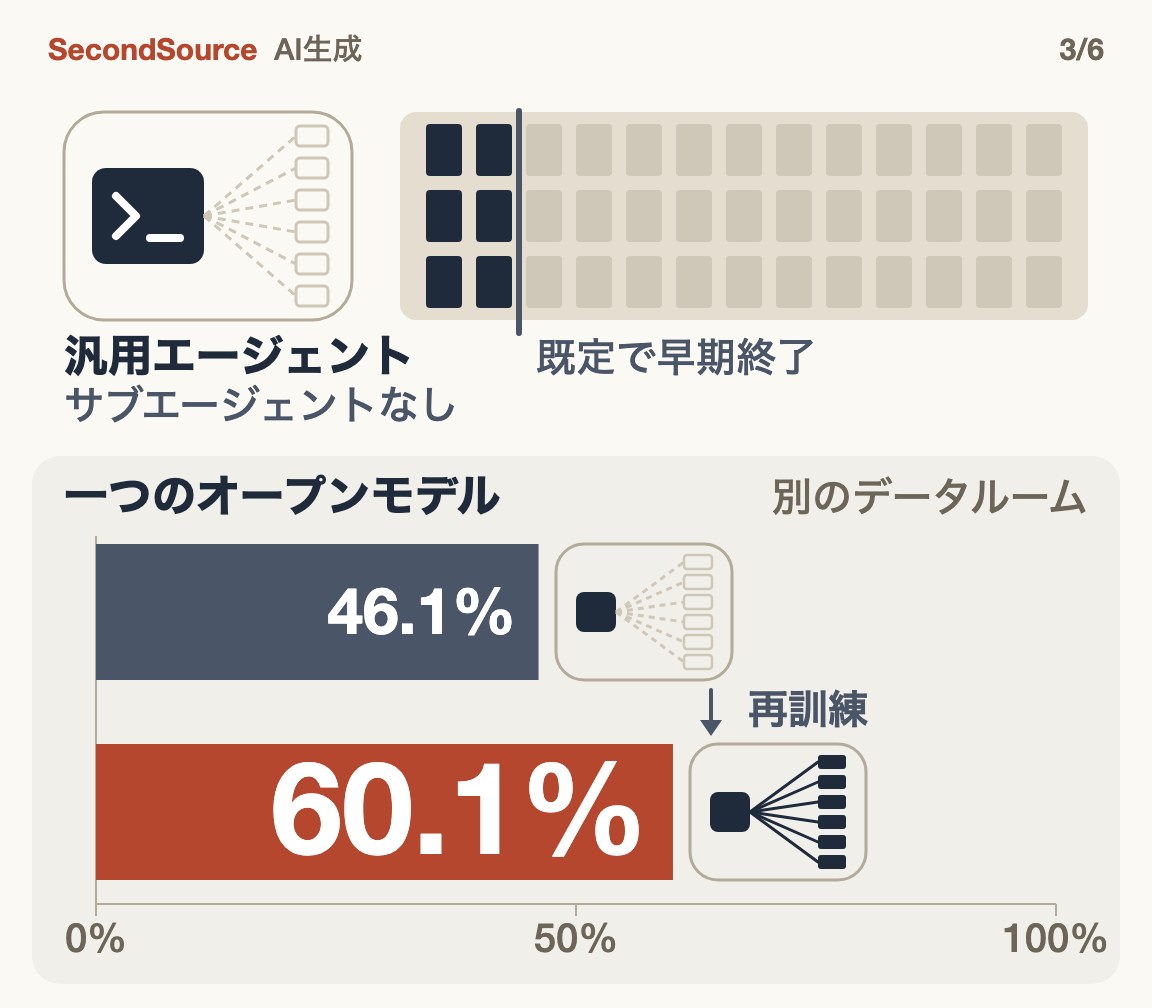
Harvey が Claude Code と Codex に与えたのは、単純なツールループと同じ最小限の指示だった。実行記録によると、両者とも「早々に読むのをやめ、短いメモを書いた」。サブエージェントを出す能力がありながら、どちらも出していない。これは初期設定での振る舞いの数字であって、能力の上限の数字ではない。
傍証は Z.ai のオープンウェイトモデル GLM-5.2 から来る。主エージェントを務めると、初めは早々にあきらめ、仕事を十分に振り分けないことが多かった。Harvey は GLM-5.2 が成功し、しかも多く読んだ実行記録を選び出し、それで同じモデルを鍛え直した。訓練の前後を同じ 20 室で比べると、成績は 46.1% から 60.1% に上がり、出すサブエージェントの数もデータルームの大きさに合わせて増減するようになった。この 20 室は出発点が低い(同じモデルが第 2 節の 50 室では訓練なしで 65.4%)ので、比べられるのは同じ組での前後だけだ。Harvey によれば、こうした振り分けの習慣は「比較的少数の実行記録から学べる」もので、ラベル付きの法律知識はいらない。本誌はここから、モデル企業が同じ方法で訓練すれば、汎用エージェントも原理的には学べると推論する。ただし検証されたのは GLM-5.2 だけである。
モデル企業はすでに大量の振り分けを汎用エージェントに組み込んでいる。 Anthropic は 5 月 28 日、Claude Code に動的ワークフローを入れた。数十から数百のサブエージェントを一度に並列で動かす機能で、すでに一般提供されている。Harvey はテストのときにこの機能を有効にしたかどうかを書いていない。公式の例はどれもプログラムを書く仕事で、長文書の審査での計測は見当たらない。
第三者の計測は割れており、どれも法律文書ではない。 ファイル操作論文(2026 年 3 月)は、既製のコーディングエージェントに長い文章をファイルとして扱わせ、使い慣れたファイル操作の道具で探させた。複数の長文テストで、公表済みの最高成績を上回った。並列サブエージェント論文(2026 年 6 月)は、合成のデータ集計問題 Oolong で、コーディングエージェントにサブエージェントを並列で出させて 81.36% を得た。再帰型のやり方は 64.38% だった。この二本は汎用エージェントの側に立つ。一方、元論文(2025 年末)は、再帰型のやり方が当時の Claude Code を上回ったと測った。各論文の数字と単位は付録に載せた。
したがって公平な言い方はこうなる。初期設定のまま動かした汎用エージェントは、長文書を読む量が少なすぎる。サブエージェントへの振り分けをはっきり指示すれば負けるとは限らず、別のテストでは勝っている。これは課題をまたいだ外挿で、Harvey は振り分けをはっきり指示した汎用エージェントを試していない(第 7 節の条件 1)。
5. ハーネスを替える差は大きく、主エージェントのモデルを替える差も大きい
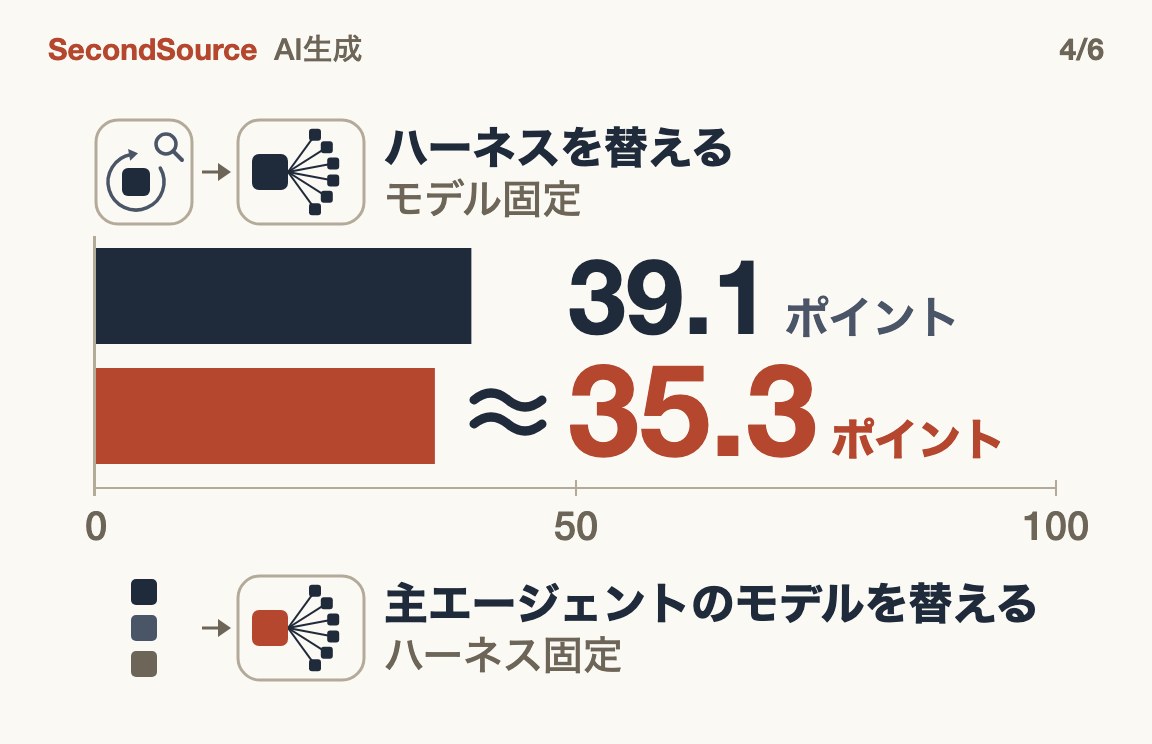
数字から出やすいもう一つの結論は、ハーネスを替える効果はフロンティアモデルに乗り換える効果より大きい、というものだ。Harvey の数字で確かめると、両者はほぼ同じ大きさである。ただし測り方は違い、一方は平均の上げ幅、もう一方は最良と最低の差だ。
- ハーネスを替える:モデルを固定してハーネスだけを替えると、7 モデルの平均で 39.1 ポイント上がる。
- モデルを替える:ハーネスを再帰型に固定してモデルだけを替えると、7 モデルのうち最良の Opus 5 は 77.6%、最低は 42.3% で、差は 35.3 ポイントある。Harvey は別に、4 種の主エージェントにそれぞれ 3 種のサブエージェントを組み合わせた。主エージェントだけを替えると、最良と最低の差は平均で約 38 ポイント。サブエージェントだけを替えると約 8 ポイントにとどまる。
したがって、ハーネスを正しく替えても、主エージェントのモデルはきちんと選ぶ必要がある。
主エージェント自身が扱う文字はごくわずかだ。Opus 5 が主エージェントのとき、読み込んだトークン全体の 3.8%、書き出したトークンの 1.1% にすぎず、残りはサブエージェントが文書を読むのに使った。トークンとは AI が文章を読み書きするときの計量単位である。文書を読む力仕事は安い小型モデルに任せられるが、どう切り分けるか、全部読むか、何百もの発見をどうメモにまとめるかを決める主エージェントでは、モデルの良し悪しの差が大きい。
費用では、7 モデルのうち 6 つが再帰型ハーネスに替えると高くなり、替えた後は 1 室あたり数米ドルから二十数米ドルかかる。例外は Opus 5 で、主エージェントに回るとかえって約 18 米ドルから約 7 米ドルに下がった(Harvey の費用グラフから本誌が読み取った概算)。
6. 垂直 AI 企業が他社にまねされにくいのは、ハーネスのプログラムでも、自前で鍛えたオープンウェイトモデルでもない
垂直 AI 企業とは、法律など一つの業界だけに特化した AI 企業のことだ。本稿の 10 月 8 日の初版は、こうした企業が守れる、他社にまねされにくい強みは、仕事に合わせて作り込んだハーネスと、そのハーネスに合わせて事後学習したオープンウェイトモデルだと判断した。この判断は三つの点で成り立たない。
1. ハーネスそのものは公開されている。 元論文のプログラムは MIT ライセンスで公開され、誰でも無料で使い、改変できる。Harvey がデータルーム向けに調整した細部は公開されていないが、記事はやり方をかなり詳しく書いている。
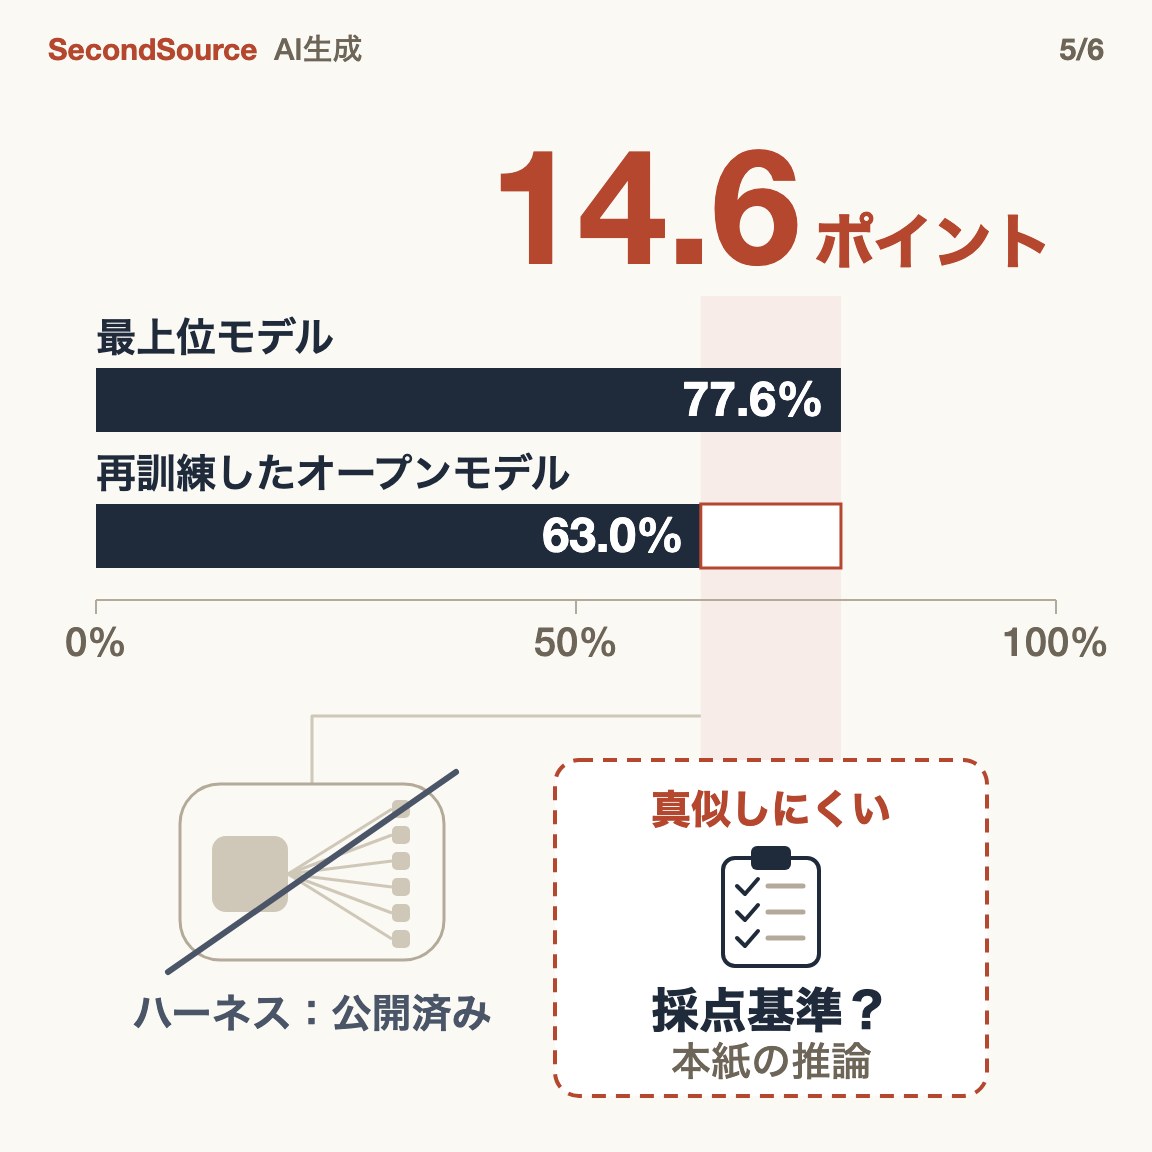
2. 事後学習したオープンウェイトモデルは、今のところフロンティアモデルに負けている。 Harvey は Alibaba Cloud のオープンウェイトモデル Qwen(第 2 節の 7 モデルには含まれない)を再帰型ハーネスの主エージェントにして事後学習し、第 2 節の 50 室で 29.9% から 63.0% に上げた。同じ 50 室で Opus 5 は 77.6% と 14.6 ポイント高く、7 モデルのうち他の 3 つも事後学習なしで 63.0% を上回る。同じオープンウェイトの GLM-5.2 もその一つだ。事後学習したオープンウェイトモデルには費用や運用の自由で利点があるかもしれないが、Harvey は費用を公表しておらず、比べようがない。
3. Harvey の事後学習は顧客データに頼っていない。 8 月に発表した自社モデル Tenet は、Moonshot AI のオープンウェイトモデル Kimi K3 を土台に、Fireworks(企業向けにオープンウェイトモデルを動かし訓練する基盤の会社)と一緒に事後学習したもので、「事後学習に顧客データは一切使っていない」と明記している。
では何が残るのか。ここからは本誌の推論で、確信度は低い。第 4 節で見たとおり、振り分けの習慣は学べる。だが、どの記録を良いとみなし、どれだけ報酬を与えるかには物差しがいる。デューデリジェンスが漏れなく正しくできたかを判定する採点基準と、その物差しで組み立てた模擬データルームである。したがって希少なのは物差しと訓練環境で、文書を読むプログラムではないかもしれない。ただし Harvey の試験問題の一部はすでに公開されており、物差しのどこまでが Harvey だけのものか、どれだけ正確か(第 2 節)は、公開情報からは分からない。顧客の信頼といった販路の強みも、本稿では測っていない。
7. 長文書 AI を評価するとき何を問うか、何が本稿を覆すか
本誌の見立て
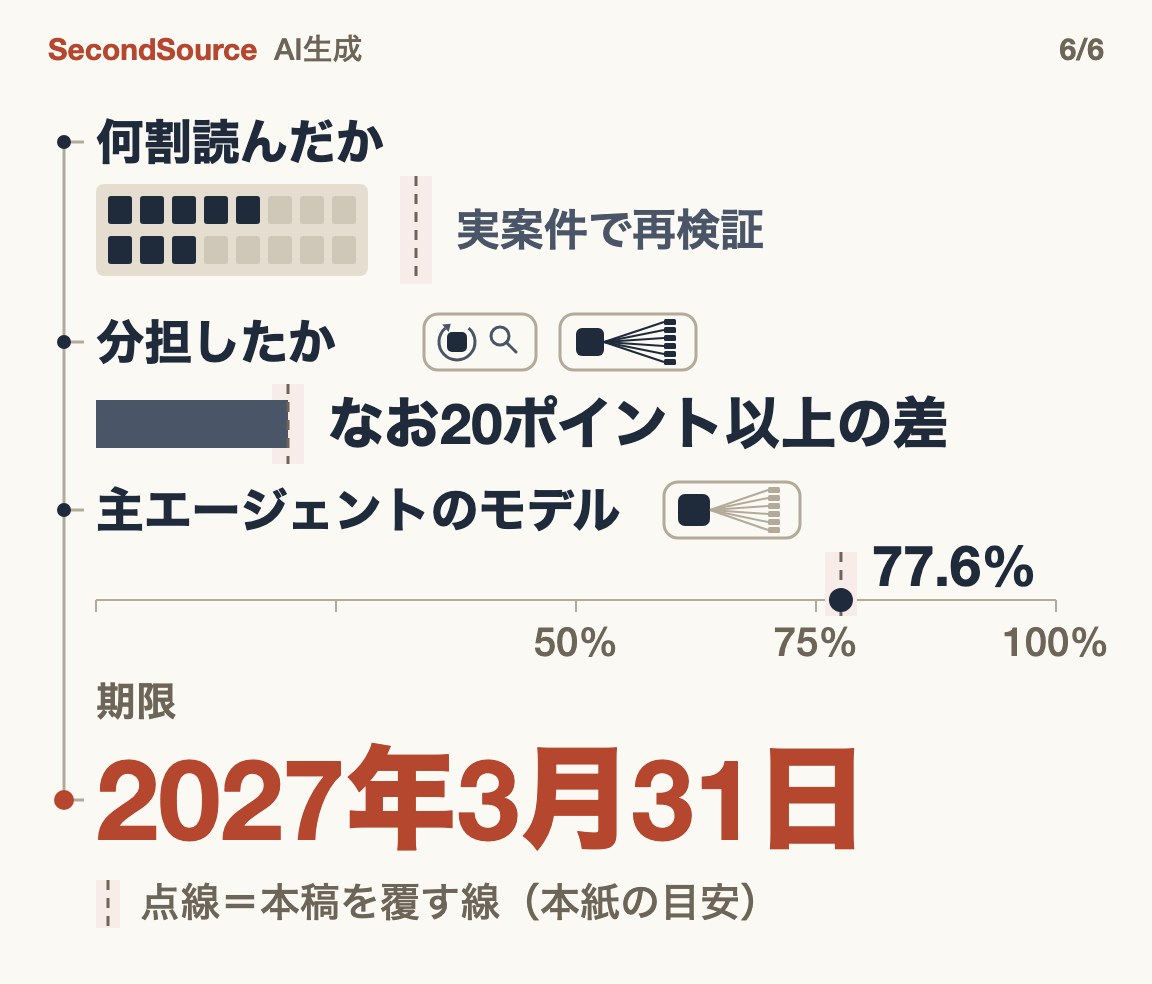
長文書を扱う AI 製品を評価するときは、主エージェントにどのモデルを使うかだけでなく、資料の何割を読んだか、仕事を振り分けたかも問う。
この判断を覆す条件
三つとも検証期日は 2027 年 3 月 31 日とする。閾値は本誌が独自に設けた観察線である。
1. 汎用エージェントにサブエージェントへの振り分けをはっきり指示して(または動的ワークフローを有効にして)同種のデューデリジェンスで再実行し、なお専用の再帰型ハーネスに合格率で 20 ポイント以上負ける。 その場合「差の主因は読み切っていないこと」は成り立たず、第 4 節冒頭の結論が成り立つ。
2. 事後学習したオープンウェイトの主エージェントが、最良のフロンティアモデルに並ぶ。 たとえば Harvey が記事の中で訓練を進めていると書いた Z.ai のオープンウェイトモデル GLM-5.3 が、訓練に使っていないデータルームで、その時点の最良のフロンティアモデル(現在は Opus 5 の 77.6%)を下回らない。その場合、第 6 節の第 2 点は書き直す。
3. 第三者が実際のデータルームか弁護士の採点でやり直し、読んだ量と点数の関係が消える。 その場合、第 3 節の主張は成り立たない。
付録:数字の出どころ
7 モデルごとの成績
Harvey のモデル別グラフのラベルを本誌が読み取った。7 つの平均は、Harvey の本文にある 23.3% と 62.4% に一致する。データルームは訓練に使っていない 50 室で、再帰型ハーネスのサブエージェントは Alibaba Cloud の Qwen3.6-35B-A3B に固定されている。
| モデル | 単純なツールループ | 再帰型ハーネス |
|---|---|---|
| Claude Opus 5 | 42.5% | 77.6% |
| Grok 4.5 | 22.8% | 68.4% |
| GPT-5.6 Sol | 16.6% | 67.7% |
| GLM-5.2 | 15.1% | 65.4% |
| Kimi K3 | 23.7% | 59.0% |
| Muse Spark 1.1 | 27.0% | 56.5% |
| DeepSeek V4 Flash | 15.6% | 42.3% |
| 7 モデルの平均 | 23.3% | 62.4% |
同じ 50 室でのその他の成績:事後学習した Qwen3.5-122B-A10B を主エージェントにしたもの、事後学習前 29.9%、後 63.0%。Claude Code(Opus 5)24.6%、Codex(GPT-5.6 Sol)12.0%。単純なツールループでの最良と最低の差は 27.4 ポイント(Opus 5 の 42.5% と GLM-5.2 の 15.1%)。
各数字の出典
| 数字 | 何を測ったか | 出典 |
|---|---|---|
| 23.3%、62.4%、39.1 | 7 モデルの平均合格率とその差、50 室 | Harvey の 9 月 8 日の記事 |
| 24.6%、12.0%、17.9、4.6 | 汎用エージェント二つの合格率と差 | 同上 |
| 1% 未満、0.1%〜0.5%、10% 超 | 各回の実行でデータルームを読んだ割合 | 同上 |
| 19、14、10、4 | 一段増やした実験:平均で下がったポイント、室数、悪くなった室数、読んだのに報告がなかった室数 | 同上、付録 |
| 46.1%、60.1%、0.17、0.84 | GLM-5.2 の鍛え直しの前後、別の 20 室 | 同上 |
| 約 38、約 8 | 組み合わせ実験:主エージェントだけ、サブエージェントだけを替えたときの最良と最低の差(ポイント)、別の 30 室 | 同上 |
| 3.8%、1.1% | Opus 5 が主エージェントのとき、読み込み・書き出しトークンに占める主エージェントの割合 | 同上 |
| 29.9%、63.0% | Qwen の主エージェントの事後学習前後、50 室 | 同上 |
| 約 18、約 7 米ドル | Opus 5 の 1 室あたり費用 | 同上 |
| 571 | 例示のデータルームのチェック項目数 | 同上 |
| 17.3% | ファイル操作論文 | arXiv 2603.20432 要旨 |
| 71.75%、64.38%、59.22%、81.36% | 並列サブエージェント論文、Oolong、基盤モデル GPT-5 | arXiv 2606.13643 要旨と本文の表 |
| 13% | 元論文、Claude Code との比較 | arXiv 2512.24601 要旨 |
| 3.6 秒、344.5 秒 | 再現論文 | arXiv 2603.02615 要旨 |
| 22% | 自己点検論文 | arXiv 2603.15653 要旨 |
五本の論文
- 元論文:Alex L. Zhang、Tim Kraska、Omar Khattab「Recursive Language Models」、arXiv 2512.24601、2025 年 12 月 31 日初版。GPT-5 を土台に、長文の四つの課題の中央値で Claude Code を 13% 上回った。
- 再現論文:Daren Wang「Think, But Don't Overthink: Reproducing Recursive Language Models」、arXiv 2603.02615、2026 年 3 月 3 日。S-NIAH と OOLONG の二つの試験を使う。
- 自己点検論文:Keivan Alizadeh 氏ら 4 人「Recursive Language Models Meet Uncertainty: The Surprising Effectiveness of Self-Reflective Program Search for Long Context」、arXiv 2603.15653、2026 年 3 月。要旨は、再帰そのものは再帰言語モデルの成績が良い主な理由ではないと書く。
- ファイル操作論文:Weili Cao 氏ら 4 人「Coding Agents are Effective Long-Context Processors」、arXiv 2603.20432、2026 年 3 月 20 日。複数の長文テストで、公表済みの最高成績を平均 17.3% 上回った。
- 並列サブエージェント論文:Elias Lumer 氏ら 4 人「Recursive Agent Harnesses」、arXiv 2606.13643、2026 年 6 月 11 日。Oolong で、コーディングエージェント Codex は 71.75%、再帰型のやり方は 64.38%、文章全体をそのままモデルに渡すと 59.22%。この三つはファイル操作論文の計測の引用である。Codex にサブエージェントを並列で出させると 81.36% に上がる。基盤モデルは GPT-5 に固定し、Claude Sonnet 4.5 に替えると 89.77% に達する。
費用の概算
Harvey の対数目盛りの費用グラフから本誌が読み取った概算である。Harvey は、定価にキャッシュを織り込んだ推計だと明記している。再帰型ハーネスに替えると、安いモデルは 1 室あたり 1 米ドル未満から約 3〜6 米ドルに、GPT-5.6 Sol は約 27 米ドルに上がった。Opus 5 は約 18 米ドルから約 7 米ドルに下がった。
Harvey の原文
- 単純なツールループが読んだ量:「In the standard tool-loop harness, no run reads more than 1% of the data room, and most read between 0.1% and 0.5%.」
- 再帰型ハーネスが読んだ量:「In the RLM harness, nearly every run reads more than 10% of the data room and most read close to all of it.」
- 相関だけ:「Higher coverage is associated with higher rubric criteria pass rates across this range.」
- 汎用エージェント:「In the traces, both agents stop reading early and write shorter memos, and neither spawns sub-agents despite having the ability to.」
- 同じ 50 室:「All other results use the 50-room hold-out set.」(GLM-5.2 の鍛え直しだけは別の 20 室)
- 学べる:「learnable from a relatively small number of on-policy traces, with no privileged information and no labeled legal knowledge」
- Tenet:「We did not use any customer data in any of our post-training efforts.」
ほかに追う数字
Harvey のブログの続報と、Anthropic の動的ワークフローの更新(条件 1)。Harvey の試験のデューデリジェンス問題が公開されるか、採点役の AI と弁護士の判断の一致度が開示されるか。物差しが公開されれば、第 6 節の「物差しが希少」は撤回する。
算出範囲の注記
- Harvey はこの実験を、AI モデルを動かすサービスの会社 Baseten と共同で公表した。
- 汎用エージェント二つ(Claude Code と Codex)は、どちらもウェブ接続を切って動かした。
- 相関係数:GLM-5.2 の鍛え直しの後、出したサブエージェントの数とデータルームの大きさの相関係数は 0.17 から 0.84 に上がった(1 は完全に連動することを示す)。
- 一段増やした実験は Qwen3.5-122B-A10B で行った。Harvey によれば GLM-5.2 は多くの回で制限時間内に終わらなかったため、Qwen の結果だけを報告している。
- 17.3%(ファイル操作論文)、13%(元論文)、22%(自己点検論文)は、相対的な伸びかポイント差かが論文に明記されていない。
- 本稿の 10 月 8 日の初版は三つの判断を書いた。汎用コーディングエージェントを万能のハーネスにするのは誤った選択だ。ハーネスを替える効果はフロンティアモデルへの乗り換えより大きい。垂直 AI 企業が守れるのは作り込んだハーネスと事後学習したオープンウェイトモデルだ。第 4・5・6 節は検証し直した後の書き直しである。
- Tenet の発表日は 2026 年 8 月 20 日。
本誌が追うトレンドライン
本誌は AI 製品の形の移り変わりを下の樹で追っている。チャットのアシスタントから、仕事のソフトに組み込まれたアシスタント、プログラムの仕事を丸ごと任せられるエージェント、そしてツールをまたいで仕事をし、土台のモデルを差し替えられる汎用エージェント基盤へ。最後の層を誰が押さえるかはまだ決まっていない。一方はモデル企業自身の基盤(Claude Code など)、もう一方はベンダー中立でモデルを替えられる第三者の外側の層である。
進行中 ?
本稿はこのトレンドラインのどこにあるか: 本稿の証拠は最後の分かれ道に落ちる。長文書の仕事では、差は主に仕事を振り分けるかどうかから生まれ、モデル企業はその振り分けの能力を自社の汎用エージェントに組み込みつつある(Claude Code の動的ワークフロー)。したがってモデル企業自身の基盤の側が一歩前に出た。分かれ道そのものはまだ決まっていない。
本稿が依拠した出典
- Harvey ブログ、2026-09-08:Post-training RLM agents for end-to-end M&A Diligence
- Harvey ブログ、2026-08-20:Harvey Tenet Research Preview
- Anthropic、2026-05-28:Introducing dynamic workflows in Claude Code
- arXiv、2026-03-20:Coding Agents are Effective Long-Context Processors
- arXiv、2026-06-11:Recursive Agent Harnesses
- arXiv、2026-03-07:Recursive Language Models Meet Uncertainty: The Surprising Effectiveness of Self-Reflective Program Search for Long Context
- arXiv、2026-03-03:Think, But Don't Overthink: Reproducing Recursive Language Models
- arXiv、2025-12-31:Recursive Language Models
- GitHub:alexzhang13/rlm
- Latent Space、2026-10-02:Academia is for Ambition — Alex Zhang, MIT
- Ahead of AI、2026-06-27:Using Local Coding Agents
- arXiv、2026-05-27:Harness-Bench: Measuring Harness Effects across Models in Realistic Agent Workflows
- arXiv、2026-06-10:Claw-SWE-Bench: A Benchmark for Evaluating OpenClaw-style Agent Harnesses on Coding Tasks
本記事は日本語版・英語版・中国語版と同一の調査と判断にもとづいて書かれています。出典にはリンクを付け、原文書と報道を区別し、確かめられなかった点を明記しています。
ご意見・ご感想は ops@secondsource.io までお寄せください。