深度 深度專欄 #40 · 2026年10月8日
長文件 AI 的分數跟著讀了多少走:同一批模型換個外層程式,審查通過率平均多 39 個百分點
本篇 10 月 8 日出刊,10 月 23 日依現行標準重寫並重新查證,修正三個判斷(見附錄)。
本篇重點
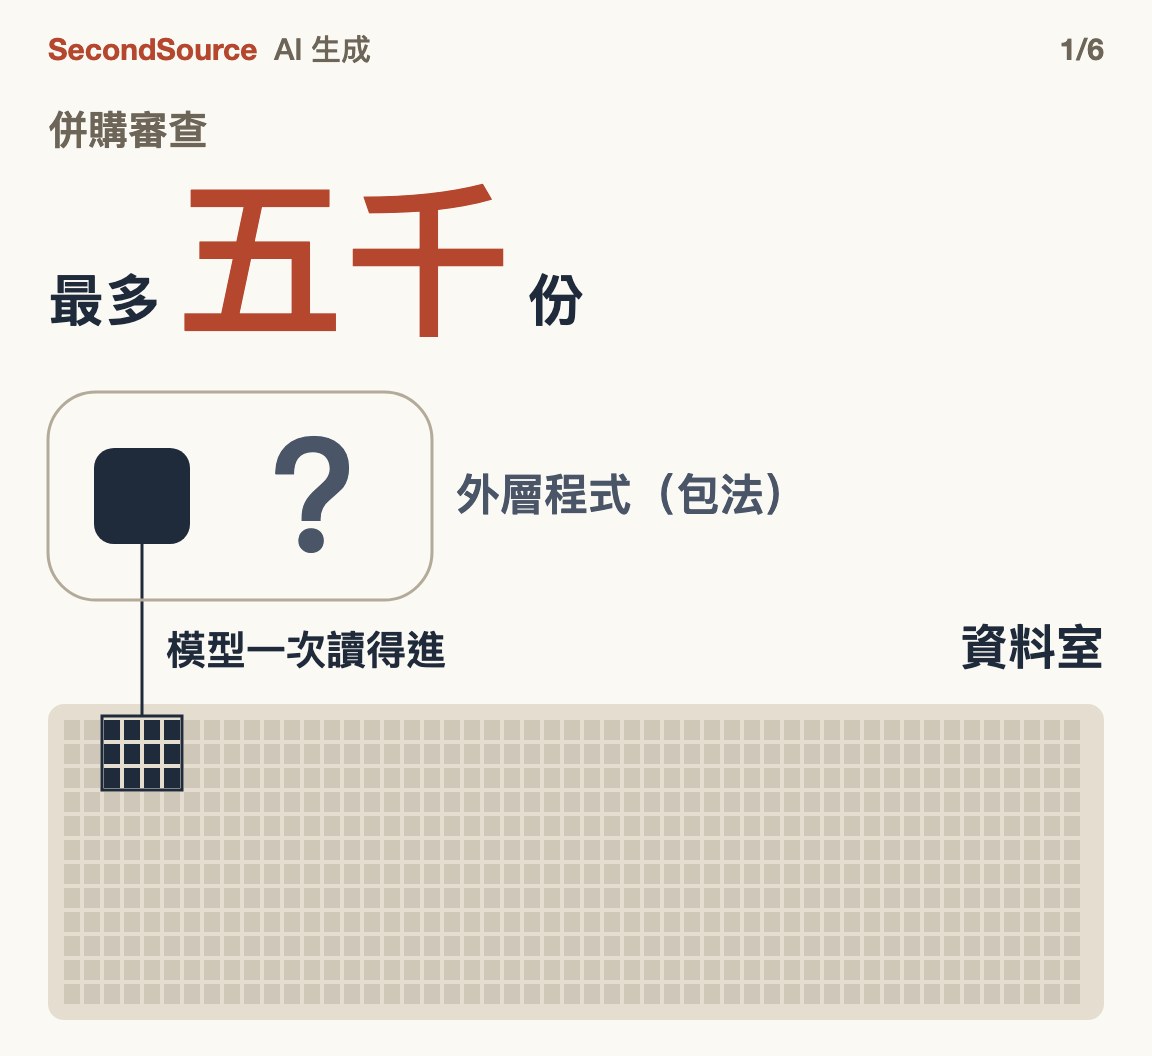
法律 AI 公司 Harvey 九月八日發表一組實驗:讓七個 AI 模型替買方審查模擬的併購文件,一案最多五千份,遠超過模型一次能讀的量。模型不換,只換外面那層程式(本篇稱包法),專家列的審查項目平均通過比例,從 23.3% 升到 62.4%。讀進的資料越多,分數越高。
本報核對後補兩點。兩個現成的寫程式 AI 代理分數低,是照預設設定太早停讀,不等於做不到。換對包法後,模型好壞仍差很多,Harvey 再訓練的開源模型仍輸給最好的商用模型。所以專做單一行業的 AI 公司,難抄的不是包法程式,目前也不是自家再訓練的模型;本篇推論是判斷審查好壞的標準,與依此搭的模擬資料室。數字全出自 Harvey 一家,文件是模擬的。
一、先分清幾個詞:資料室、代理、包法
資料室是併購交易中,賣方放出來讓買方審查的一大批文件。買方律師要從中找出風險,這項工作叫盡職調查。Harvey 用程式造出模擬的資料室,每間附一份專家寫的檢查清單。
代理是能自行搜尋、寫程式、呼叫工具完成任務的 AI 程式。包法是模型外面那層程式,決定模型怎麼讀、怎麼呼叫工具、什麼時候停手,業界叫 harness。
Harvey 比較了三種做法:
- 簡單工具迴圈:一個代理自行搜尋、挑文件讀,覺得夠了就寫備忘錄。這是 Harvey 自建法律 AI 測驗的標準設定。
- 遞迴包法:主代理不直接讀文件,而是寫程式把資料室按類別切塊,每塊交給一個子代理去讀;子代理交回發現,主代理再匯整成備忘錄。這個做法出自麻省理工學院 Alex Zhang 等人 2025 年底的論文「遞迴語言模型」,本篇稱原論文。
- 現成的通用寫程式代理:Anthropic 的 Claude Code 與 OpenAI 的 Codex。兩者原本為寫程式而設計,也能用檔案工具翻找大量文件。
通過率是備忘錄通過的條目比例:另一個 AI 當評審,對照專家檢查清單逐條判定。
後訓是拿現成模型,用特定任務的資料或獎勵再訓練一輪。前沿模型指目前能力最強的商用模型。開源模型指公開模型檔、可自行架設的模型。
二、同樣七個模型換包法,平均多 39 個百分點
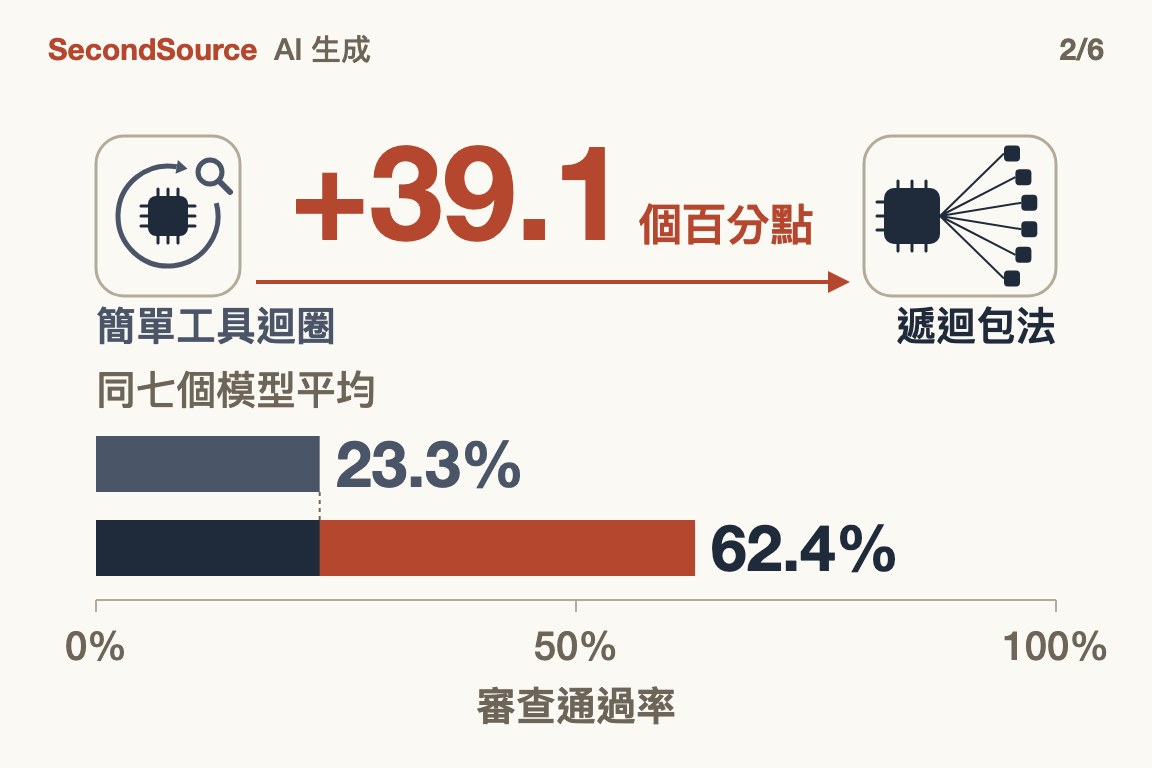
Harvey 留了 50 個模擬資料室專門考試,第四、六節再訓練模型時沒用過這一批;本篇的成績除另外註明都是這一批。七個模型包括 Anthropic 的 Claude Opus 5 與 OpenAI 的 GPT-5.6 Sol 等,在遞迴包法裡輪流當主代理,子代理固定用同一個小型開源模型。放進簡單工具迴圈,平均通過率 23.3%;放進遞迴包法,平均 62.4%,差 39.1 個百分點。成績最高的是 Opus 5,從 42.5% 升到 77.6%。逐模型成績見附錄。
現成的通用寫程式代理反而更低:Claude Code(搭 Opus 5)得 24.6%、Codex(搭 GPT-5.6 Sol)得 12.0%,比同一個模型放進簡單工具迴圈,分別低 17.9 與 4.6 個百分點。
讀這些數字前要先知道:資料室是模擬的,不是真實交易;評審是 AI,Harvey 沒說明評審和律師判斷的一致程度;後訓(第四、六節)的獎勵分數也來自同一個評審,等於拿考官的標準練考生,後訓的進步有一部分可能只是更合評審的口味;Harvey 稱這些訓練實驗是「初步探索」,沒有產品部署的說法。
三、分數跟著讀了多少走
Harvey 在每次執行時,量了資料室內容實際進到模型的比例。簡單工具迴圈沒有一次超過 1%,多數只讀 0.1% 到 0.5%;遞迴包法幾乎每次超過 10%,多數接近全讀。Harvey 的結論是:讀得越多,通過率越高。
這在盡職調查裡很合理。清單上有些項目要合併好幾份文件才找得到,有些要確認某份該有的文件不存在:沒翻過的櫃子,不能說裡面沒有東西。
但有兩個界線:
- 分給子代理讀有用,但分層越多不一定越好。 Harvey 另做一個小實驗,讓子代理再往下分派、多加一層(主代理與子代理用同一個開源模型):十四個資料室裡四個變好、十個變差,十四個平均掉 19 個百分點;變差的十個裡有四個讀了資料卻沒寫出報告。可見失敗也出在寫報告,讀了多少不是唯一的變數。三月兩篇與 Harvey 無關的論文也指向同一邊。一篇重新實作原論文(本篇稱重做論文,測試規模小得多),加到第二層後成績變差,執行時間從 3.6 秒暴增到 344.5 秒。另一篇(本篇稱自我檢查論文)不靠遞迴:讓模型寫出幾種翻找文本的程式,再依模型有多確定(多次作答是否一致、自評信心等)挑一種,同樣時間內最多比原論文的遞迴做法好 22%。
- 讀得多與分數高只是一起上升,不是已證明的因果。 也可能是分工安排得好的代理本來就讀得多、寫得好;Harvey 只報告兩者相關,沒有排除這個解釋。
四、通用代理這次輸在預設設定,不是已證明做不到
第二節的數字很容易導出一個結論:把通用寫程式代理當萬用包法,是錯的選擇。但要先看量的是什麼。
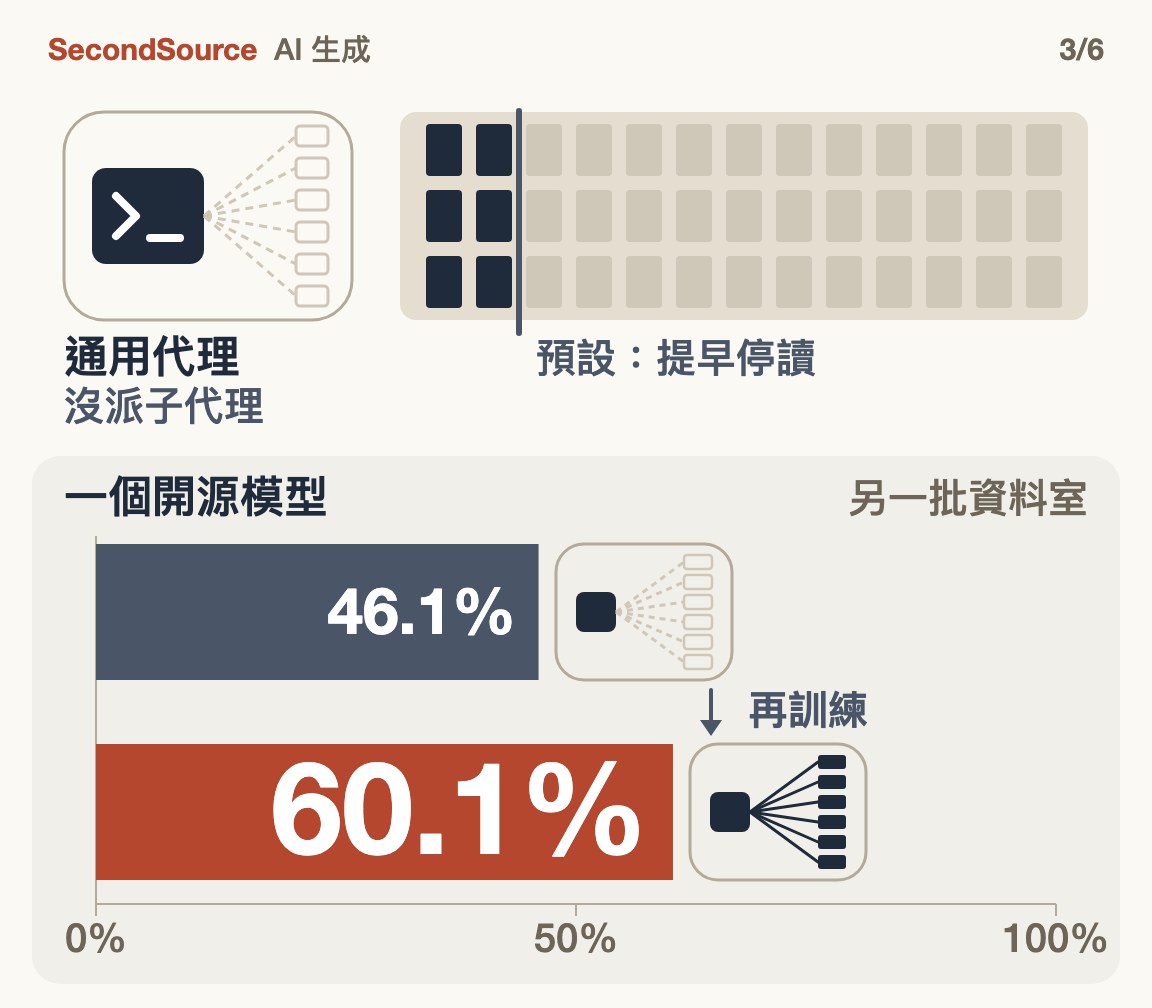
Harvey 給 Claude Code 與 Codex 的,是和簡單工具迴圈相同的極簡指令。執行紀錄顯示兩者「提早停止閱讀、寫較短的備忘錄」,有能力派出子代理卻都沒派。這是預設行為的讀數,不是能力上限的讀數。
旁證來自 Z.ai 的開源模型 GLM-5.2:當主代理時起初也常提早放棄、分派不足。Harvey 挑出 GLM-5.2 成功又讀得多的執行紀錄,拿來再訓練同一個模型。訓練前後在同一批二十個資料室上比:成績從 46.1% 升到 60.1%,派出的子代理數也開始跟著資料室大小走。這批起點較低(同一個模型在第二節那批未訓練就有 65.4%),只能同批前後比。Harvey 說這種分派習慣「從相對少量的執行紀錄就學得到」,不需要標註過的法律知識。本報據此推論,模型廠若用同樣方式訓練,通用代理原則上也學得會;但只在 GLM-5.2 上驗證過。
模型廠已把大量分派放進通用代理。 Anthropic 五月二十八日在 Claude Code 推出動態工作流程,一次並行派出數十到數百個子代理,現已全面開放。Harvey 沒寫測試時是否開了這項功能;官方範例都是寫程式,長文件審閱上本報沒看到量測。
第三方量測結果不一,而且都不是法律文件。 檔案系統論文(2026 年 3 月)讓現成的寫程式代理把長文本當成檔案,用慣用的檔案工具翻找,在多個長文本測試上勝過已發表的最佳成績。並行子代理論文(2026 年 6 月)在合成的資料彙整題 Oolong 上,讓寫程式代理並行派出子代理,得 81.36%,遞迴做法是 64.38%。這兩篇支持通用代理。原論文(2025 年底)則量到遞迴做法勝過當時版本的 Claude Code。各篇數字與口徑見附錄。
所以比較公平的說法是:照預設設定跑的通用代理,在長文件上讀得太少;明確要求分派子代理時就不一定輸,在別的測試上還贏了。這是跨任務外推,Harvey 沒測過明確要求分派的通用代理(第七節第 1 條)。
五、換包法差很多,換主代理的模型也差很多
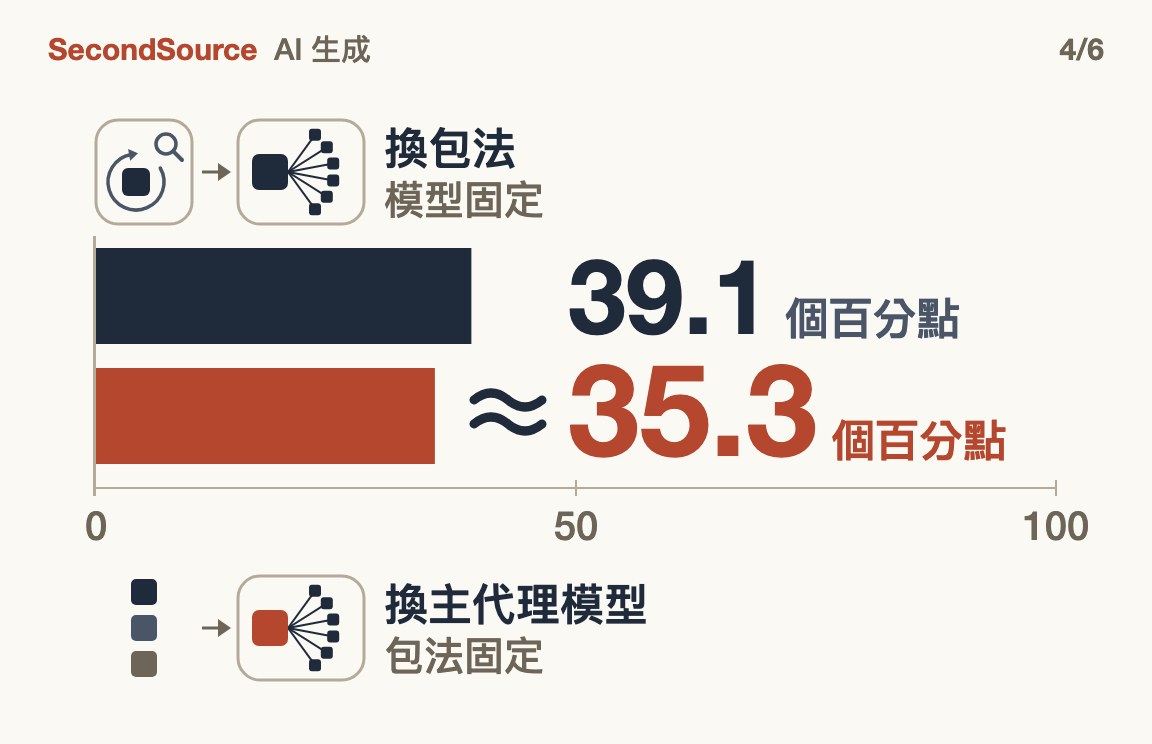
另一個容易導出的結論是:換包法的收益,大於換用前沿模型。用 Harvey 的數字檢查,兩者其實差不多大,只是口徑不同:一個是平均增幅,一個是最好減最差。
- 換包法:模型固定、只換包法,七個模型平均多 39.1 個百分點。
- 換模型:包法固定在遞迴包法、只換模型,七個模型裡最好的 Opus 5 是 77.6%,最差的是 42.3%,差 35.3 個百分點。Harvey 另讓四種主代理各搭三種子代理:只換主代理,最好與最差平均差約 38 個百分點;只換子代理,只差約 8 個百分點。
所以包法換對了,主代理的模型仍要選好。
主代理本身處理的文字很少:以 Opus 5 當主代理時,只占全部讀進文字的 3.8%、寫出文字的 1.1%,其餘是子代理讀文件用掉的。讀文件的苦工可以交給便宜的小模型,但決定怎麼切、要不要讀完、怎麼把幾百條發現寫成備忘錄的主代理,模型好壞差很多。
成本方面,七個模型裡六個換成遞迴包法後變貴,換後每個資料室要花約幾美元到二十幾美元;例外是 Opus 5,改當主代理反而從約十八美元降到約七美元(本報從 Harvey 成本圖讀出的近似值)。
六、垂直 AI 公司難被抄走的,不是包法程式,也不是自訓的開源模型
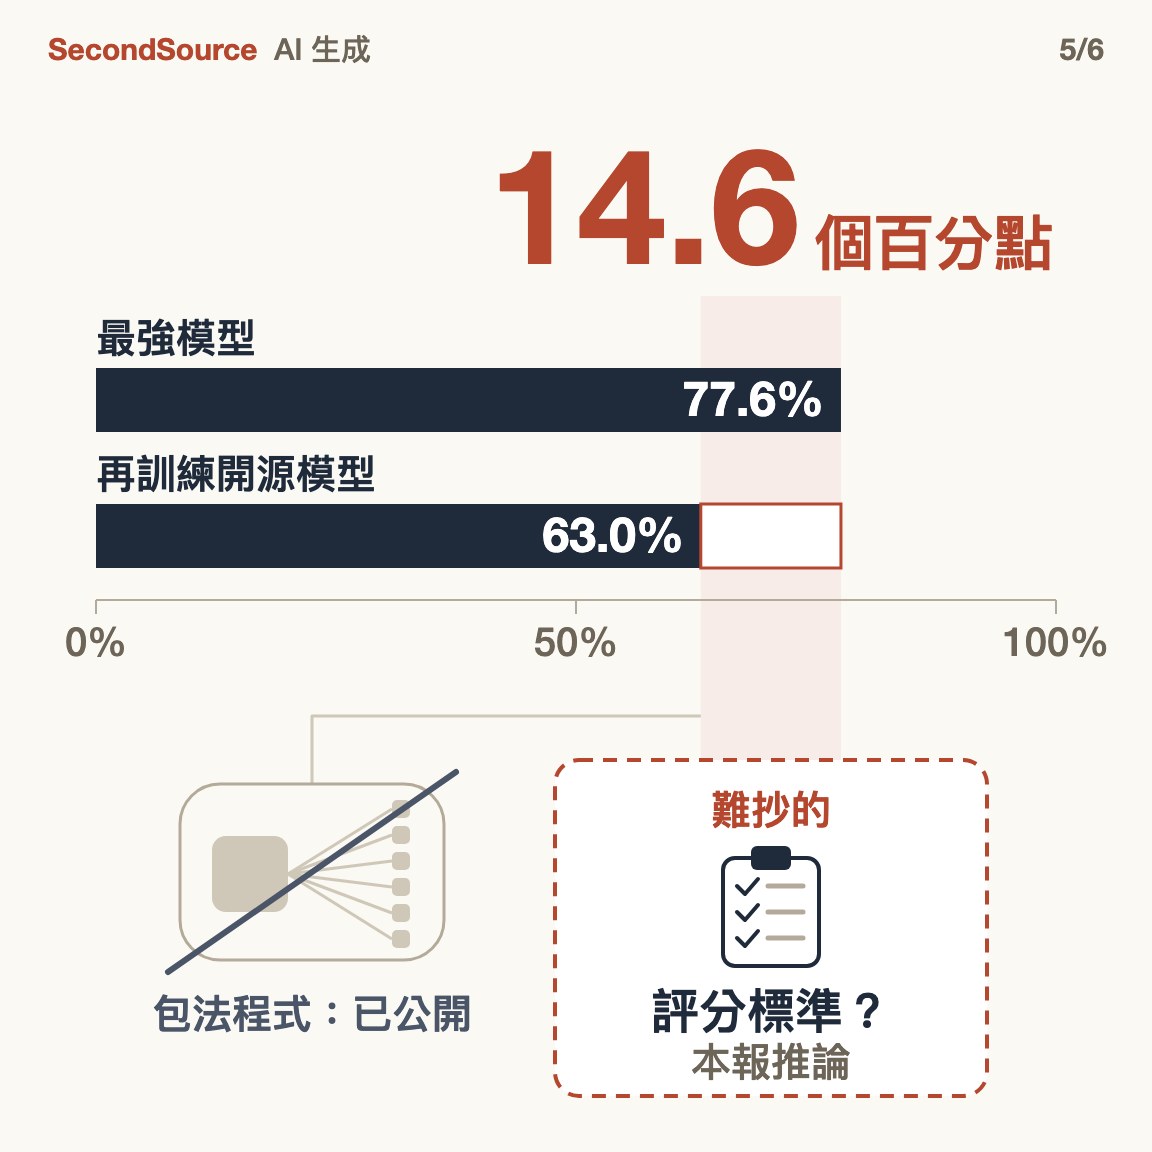
垂直 AI 公司指只服務一個行業(例如法律)的 AI 公司。本篇十月八日初版的判斷是,這類公司能守住、別家難抄的,是為任務量身打造的包法,加上圍繞包法後訓的開源模型。三點讓這個判斷站不住:
1. 包法本身是公開的。 原論文的程式庫以 MIT 授權開源,任何人可免費使用與修改。Harvey 針對資料室調的細節沒公開,但文章把做法寫得很完整。
2. 後訓過的開源模型目前輸給前沿模型。 Harvey 把阿里雲的開源模型 Qwen(不在第二節七個模型之內)放進遞迴包法當主代理再後訓,在第二節那 50 個資料室上從 29.9% 升到 63.0%。同一批資料室,Opus 5 是 77.6%,高 14.6 個百分點;七個模型裡另有三個不經後訓也高於 63.0%,包括同為開源的 GLM-5.2。後訓開源模型或許省錢、好掌控部署,但 Harvey 沒公布成本,無從比較。
3. Harvey 的後訓不靠客戶資料。 八月發表的自有模型 Tenet,以 Moonshot AI 的開源模型 Kimi K3 為底,與 Fireworks(替企業執行與訓練開源模型的平台公司)一起後訓,明寫「後訓沒有使用任何客戶資料」。
那剩下什麼?以下是本報推論,信心較低。第四節的分派習慣不難學,但挑出哪些紀錄算好、給多少獎勵,需要一把尺:判斷盡職調查做得完不完整、對不對的評分標準,加上用這把尺搭起來的模擬資料室。所以稀缺的可能是尺與訓練環境,不是讀文件的程式。不過 Harvey 的測驗題庫有一部分已開源,尺有多少仍是 Harvey 獨有、準不準(第二節),本報都沒查清楚;客戶信任這類通路優勢,本篇也沒有量。
七、評估長文件 AI 要問什麼,什麼結果會推翻本篇
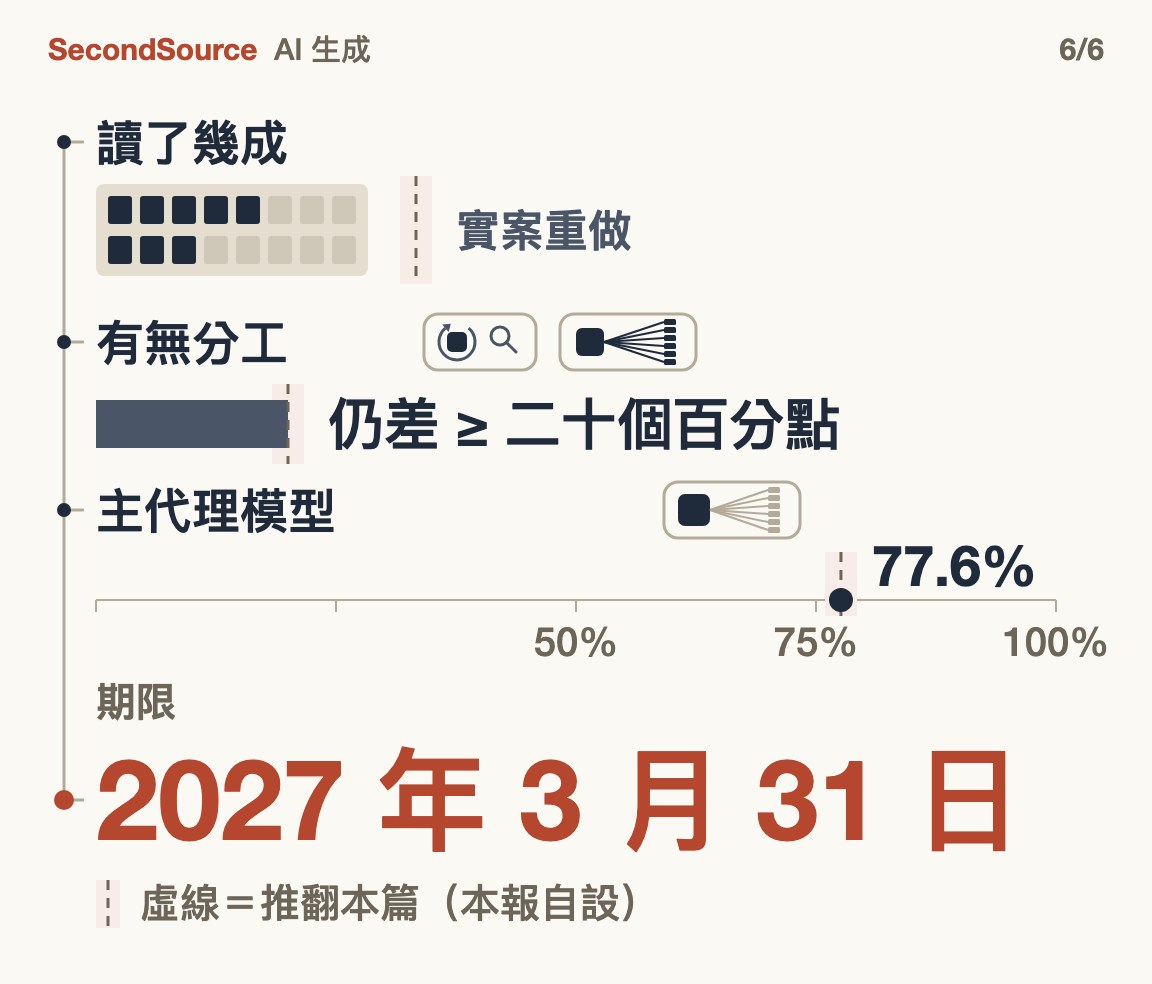
方向判斷
評估處理長文件的 AI 產品,除了問主代理用哪個模型,也要問讀了資料的幾成、有沒有把工作分出去。
什麼會推翻本篇
三條的檢驗期限都是 2027 年 3 月 31 日,門檻數字是本報自設的觀察線。
1. 有人明確要求通用代理分派子代理(或開啟動態工作流程),在同類盡職調查上重跑,仍落後專屬遞迴包法二十個百分點以上。 那麼「差距主要是沒讀完」不成立,第四節開頭那個結論成立。
2. 後訓的開源主代理追平最好的前沿模型。 例如 Harvey 文中提到正在擴大訓練的 Z.ai 開源模型 GLM-5.3,在訓練時沒用過的資料室上不低於屆時最好的前沿模型(目前是 Opus 5 的 77.6%)。那麼第六節第 2 點要重寫。
3. 第三方用真實資料室或律師評分重做,讀了多少與分數的關係消失。 那麼第三節的主張不成立。
附錄:數字怎麼來的
七個模型的逐一成績
本報從 Harvey 的逐模型圖讀出標籤,七個平均與 Harvey 正文的 23.3%、62.4% 吻合。資料室是 50 個訓練時沒用過的那一批;遞迴包法的子代理固定用阿里雲的 Qwen3.6-35B-A3B。
| 模型 | 簡單工具迴圈 | 遞迴包法 |
|---|---|---|
| Claude Opus 5 | 42.5% | 77.6% |
| Grok 4.5 | 22.8% | 68.4% |
| GPT-5.6 Sol | 16.6% | 67.7% |
| GLM-5.2 | 15.1% | 65.4% |
| Kimi K3 | 23.7% | 59.0% |
| Muse Spark 1.1 | 27.0% | 56.5% |
| DeepSeek V4 Flash | 15.6% | 42.3% |
| 七個平均 | 23.3% | 62.4% |
同一批資料室上的其他成績:後訓的 Qwen3.5-122B-A10B 當主代理,後訓前 29.9%、後訓後 63.0%;Claude Code(搭 Opus 5)24.6%,Codex(搭 GPT-5.6 Sol)12.0%。簡單工具迴圈裡最好與最差差 27.4 個百分點(Opus 5 的 42.5% 對 GLM-5.2 的 15.1%)。
每個數字的出處
| 數字 | 量什麼 | 出處 |
|---|---|---|
| 23.3%、62.4%、39.1 | 七模型平均通過率與差距,50 個資料室 | Harvey 九月八日文 |
| 24.6%、12.0%、17.9、4.6 | 兩個通用代理的通過率與落後幅度 | 同上 |
| <1%、0.1%–0.5%、>10% | 每次執行讀進資料室的比例 | 同上 |
| 19、14、10、4 | 加深一層:資料室數、變差數、平均掉幾個百分點、讀了沒寫報告的數 | 同上,附錄 |
| 46.1%、60.1%、0.17、0.84 | GLM-5.2 再訓練前後,另一批 20 個資料室 | 同上 |
| 約 38、約 8 | 交叉實驗:只換主代理、只換子代理的最好最差差距(個百分點),另一批 30 個資料室 | 同上 |
| 3.8%、1.1% | Opus 5 當主代理時,主代理占讀進與寫出 token 的比例 | 同上 |
| 29.9%、63.0% | Qwen 主代理後訓前後,50 個資料室 | 同上 |
| 約十八、約七美元 | Opus 5 每個資料室的成本 | 同上 |
| 571 | 範例資料室的檢查清單條數 | 同上 |
| 17.3% | 檔案系統論文 | arXiv 2603.20432 摘要 |
| 71.75%、64.38%、59.22%、81.36% | 並行子代理論文,Oolong,底層模型 GPT-5 | arXiv 2606.13643 摘要與正文表 |
| 13% | 原論文對 Claude Code | arXiv 2512.24601 摘要 |
| 3.6 秒、344.5 秒 | 重做論文 | arXiv 2603.02615 摘要 |
| 22% | 自我檢查論文 | arXiv 2603.15653 摘要 |
五篇論文
- 原論文:Alex L. Zhang、Tim Kraska、Omar Khattab,〈Recursive Language Models〉,arXiv 2512.24601,2025 年 12 月 31 日首版。以 GPT-5 為底,在四個長文本任務的中位數上比 Claude Code 高 13%。
- 重做論文:Daren Wang,〈Think, But Don't Overthink: Reproducing Recursive Language Models〉,arXiv 2603.02615,2026 年 3 月 3 日。用 S-NIAH 與 OOLONG 兩組測試。
- 自我檢查論文:Keivan Alizadeh 等四位,〈Recursive Language Models Meet Uncertainty: The Surprising Effectiveness of Self-Reflective Program Search for Long Context〉,arXiv 2603.15653,2026 年 3 月。摘要寫,遞迴本身不是遞迴語言模型成績好的主因。
- 檔案系統論文:Weili Cao 等四位,〈Coding Agents are Effective Long-Context Processors〉,arXiv 2603.20432,2026 年 3 月 20 日。在多個長文本測試上,平均比已發表的最佳成績高 17.3%。
- 並行子代理論文:Elias Lumer 等四位,〈Recursive Agent Harnesses〉,arXiv 2606.13643,2026 年 6 月 11 日。Oolong 上,寫程式代理 Codex 71.75%、遞迴做法 64.38%、整份直接交給模型 59.22%,這三個成績是該文引用檔案系統論文的量測;讓 Codex 並行派出子代理後升到 81.36%。底層模型固定為 GPT-5;改用 Claude Sonnet 4.5 時到 89.77%。
成本的近似值
以下是本報從 Harvey 的對數刻度成本圖讀出的近似值;Harvey 寫明是照牌價、計入快取的估算。換成遞迴包法後,便宜模型每個資料室從不到一美元升到約三到六美元,GPT-5.6 Sol 約二十七美元。Opus 5 從約十八美元降到約七美元。
Harvey 原文句
- 簡單工具迴圈讀了多少:「In the standard tool-loop harness, no run reads more than 1% of the data room, and most read between 0.1% and 0.5%.」
- 遞迴包法讀了多少:「In the RLM harness, nearly every run reads more than 10% of the data room and most read close to all of it.」
- 只說相關:「Higher coverage is associated with higher rubric criteria pass rates across this range.」
- 通用代理:「In the traces, both agents stop reading early and write shorter memos, and neither spawns sub-agents despite having the ability to.」
- 同一批資料室:「All other results use the 50-room hold-out set.」(除 GLM-5.2 再訓練那一組用另一批 20 個資料室)
- 學得會:「learnable from a relatively small number of on-policy traces, with no privileged information and no labeled legal knowledge」
- Tenet:「We did not use any customer data in any of our post-training efforts.」
其他要追的讀數
Harvey 部落格的後續文章與 Anthropic 動態工作流程的更新(推翻條件第 1 條);Harvey 測驗的盡職調查題組是否公開、評審與律師判斷的一致度是否公布。尺一旦公開,第六節「尺是稀缺的」就要收回。
口徑說明
- Harvey 這篇實驗與推理服務公司 Baseten 合作發表。
- Claude Code 與 Codex 兩個通用代理都關掉了上網。
- 相關係數:GLM-5.2 再訓練後,派出子代理的數量與資料室大小的相關係數從 0.17 升到 0.84(1 代表完全同步)。
- 加深一層的實驗用 Qwen3.5-122B-A10B 跑;Harvey 寫明 GLM-5.2 很多次沒在時限內跑完,所以只報 Qwen。
- 17.3%(檔案系統論文)、13%(原論文)與 22%(自我檢查論文),原文都沒註明是相對提升還是百分點。
- 本篇十月八日初版寫過三個判斷:通用寫程式代理當萬用包法是錯的選擇、換包法的收益大於換用前沿模型、垂直 AI 公司的可守位置在量身包法加後訓開源模型。第四、五、六節是重驗後的改寫。
- Tenet 的發表日是 2026 年 8 月 20 日。
放到本報追蹤的趨勢上
本報把 AI 產品形態的變化畫成下面這張圖:從聊天助手,到嵌進工作軟體的助手,到能交付整個寫程式任務的代理,再到跨工具辦事、底層模型可以替換的通用代理平台。這一層最後由誰吃下還沒定:一邊是模型廠自家的平台,例如 Claude Code;另一邊是廠牌中立、可換模型的第三方外層。
進行中 ?
本篇在圖上:本篇的證據落在最後那個分岔。長文件工作的差距主要在有沒有把工作分出去,而模型廠正把分派能力放進自家的通用代理(Claude Code 的動態工作流程),所以模型廠自家平台這一邊往前推了一步;分岔本身還沒定。
本篇依據的出處
以下由本篇引用的事實紀錄機械彙整,每條是其中一個事實的出處;原件本報是否讀過、還是只讀到轉述,以正文各段的說明為準。
- Harvey Blog · 2026-09-08:Harvey — Post-training RLM agents for end-to-end M&A Diligence
- Harvey Blog · 2026-08-20:Harvey Tenet Research Preview
- Anthropic · 2026-05-28:Introducing dynamic workflows in Claude Code
- arXiv · 2026-03-20:Coding Agents are Effective Long-Context Processors
- arXiv · 2026-06-11:Recursive Agent Harnesses
- arXiv · 2026-03-07:Recursive Language Models Meet Uncertainty: The Surprising Effectiveness of Self-Reflective Program Search for Long Context
- arXiv · 2026-03-03:Think, But Don't Overthink: Reproducing Recursive Language Models
- arXiv · 2025-12-31:Recursive Language Models
- GitHub:alexzhang13/rlm
- Latent Space · 2026-10-02:Academia is for Ambition — Alex Zhang, MIT(Latent Space)
- Ahead of AI · 2026-06-27:Using Local Coding Agents
- arXiv · 2026-05-27:Harness-Bench: Measuring Harness Effects across Models in Realistic Agent Workflows
- arXiv · 2026-06-10:Claw-SWE-Bench: A Benchmark for Evaluating OpenClaw-style Agent Harnesses on Coding Tasks